Category: Notes

  • Installer OpenCode et connecter DeepSeek

    OpenCode est un agent de programmation ouvert qui réside directement dans le terminal. Il peut lire des fichiers de projet, éditer du code, exécuter des commandes et des tests, rechercher dans le référentiel et travailler avec git – à peu près la même chose que Claude Code et d’autres agents de console. La principale différence est qu’OpenCode n’est pas lié à un seul fournisseur de modèle : des dizaines de fournisseurs peuvent être connectés via lui, y compris DeepSeek. Dans cet article, je décrirai l’installation de l’agent et la connexion de DeepSeek à celui-ci.

    Ce dont vous avez besoin

    Vous n’avez besoin que de deux choses pour fonctionner :

    • Terminal moderne. WezTerm, Alacritty, Ghostty, Kitty ou tout autre feront l’affaire.
    • Clé API du fournisseur. Dans notre cas, DeepSeek.

    Node.js n’est pas requis si vous installez l’agent avec un script d’installation standard : le binaire arrive prêt à l’emploi.

    Installation

    Le moyen le plus simple est le script d’installation officiel :

    curl -fsSL https://opencode.ai/install | bash
    

    Il détectera la plateforme elle-même et placera le fichier exécutable dans PATH. Après l’installation, vous devez vérifier que tout est en place :

    opencode --version
    

    Si la commande affiche la version, l’installation a réussi.

    Installation à l’aide d’autres méthodes

    Si vous préférez les gestionnaires de packages, il existe plusieurs options. Via Node.js :

    npm install -g opencode-ai
    

    Bun, pnpm et Yarn peuvent faire la même chose :

    bun install -g opencode-ai
    pnpm install -g opencode-ai
    yarn global add opencode-ai
    

    macOS et Linux ont Homebrew. Attention : c’est le tap des développeurs qui est recommandé, et non la formule officielle – il est mis à jour moins fréquemment :

    brew install anomalyco/tap/opencode
    

    Sous Arch Linux :

    sudo pacman -S opencode
    paru -S opencode-bin
    

    La première commande installe la version stable du référentiel, la seconde – la dernière de l’AUR.

    Installation sous Windows

    Sous Windows, il est recommandé de travailler via WSL : de cette façon, les performances sont plus élevées et la compatibilité avec les capacités de l’agent est complète. Mais il existe aussi des méthodes natives. Via Chocolatey, Scoop ou npm :

    choco install opencode
    scoop install opencode
    npm install -g opencode-ai
    

    Il existe également une option via Mise, ainsi qu’un conteneur Docker :

    mise use -g github:anomalyco/opencode
    docker run -it --rm ghcr.io/anomalyco/opencode
    

    Enfin, le binaire terminé peut toujours être extrait de la page des versions sur GitHub.

    Clé DeepSeek

    La clé est créée dans votre compte personnel DeepSeek. Accédez à platform.deepseek.com, ouvrez la section avec les clés API et cliquez sur créer une nouvelle clé. Il est préférable de sauvegarder immédiatement la chaîne résultante : elle ne sera affichée qu’une seule fois.

    Connexion DeepSeek

    Ensuite, tout se fait à l’intérieur de l’agent lui-même. Lancez OpenCode dans le terminal :

    opencode
    

    Dans l’interface, nous exécutons la commande de connexion :

    /connect
    

    Dans la liste des fournisseurs qui s’ouvre, recherchez DeepSeek, sélectionnez-le et insérez la clé API. Les clés ajoutées de cette manière sont enregistrées dans un fichier :

    ~/.local/share/opencode/auth.json
    

    Après connexion, il ne reste plus qu’à sélectionner le modèle avec la commande :

    /models
    

    Les modèles DeepSeek seront disponibles dans la liste, notamment deepseek-v4-pro, deepseek-flash et deepseek-v4-flash. Pour le travail de routine dans le référentiel, l’option flash est suffisante ; Pour les tâches complexes, il est judicieux de passer au pro.

    Configuration via config

    Si vous ne souhaitez pas stocker la clé via un maître ou si vous devez définir votre propre adresse API, le fournisseur est décrit directement dans le fichier de configuration opencode.json :

    {
      "$schema": "https://opencode.ai/config.json",
      "provider": {
        "deepseek": {
          "options": {
            "baseURL": "https://api.deepseek.com"
          }
        }
      }
    }
    

    Le champ baseURL est utile si vous passez par un proxy ou votre propre passerelle. Dans ce cas, il est pratique de transférer la clé elle-même vers une variable d’environnement :

    export DEEPSEEK_API_KEY=ваш_ключ_deepseek
    opencode
    

    Cette option convient aux lancements CI et ponctuels : la clé ne finit pas dans le stockage, mais vit uniquement dans l’environnement du processus.

    Premier lancement dans le projet

    Accédez au répertoire du projet et lancez l’agent :

    cd ваш_проект
    opencode
    

    La première étape consiste à l’initialiser :

    /init
    

    OpenCode analysera la structure du projet et créera un fichier AGENTS.md – un analogue des instructions pour l’agent. Ce fichier vaut la peine d’être engagé dans git : il aide l’agent à comprendre les conventions et les modèles adoptés dans le projet.

    Comment l’utiliser

    Le travail est structuré à peu près de la même manière que celui des autres agents. Quelques astuces que vous devriez connaître tout de suite :

    • Mode planification. La touche Tabulation fait basculer l’agent entre les modes planification et assemblage. Dans le premier, il suggère uniquement comment résoudre le problème et ne change rien – il est pratique de vérifier l’idée avant d’apporter des modifications.
    • Liens vers des fichiers. La touche @ ouvre une recherche floue dans les fichiers du projet pour transférer un fichier spécifique à l’agent dans le contexte.
    • Annuler les modifications. La commande /undo annule les dernières modifications et renvoie la demande d’origine, /redo les renvoie. Vous pouvez revenir en arrière de plusieurs étapes d’affilée.
    • Partager une conversation. La commande /share crée un lien vers la conversation en cours et la copie dans le presse-papiers. Par défaut, les conversations ne sont publiées nulle part.

    Pour des modifications simples, vous n’êtes pas obligé de passer en mode planification, mais décrivez immédiatement ce qui doit être fait et spécifiez les fichiers via @.

    À quoi faire attention

    Quelques points pratiques. OpenCode ne nécessite pas d’abonnement : vous payez directement le fournisseur lorsque vous dépensez des jetons, donc les longues sessions avec DeepSeek sont, comme on pouvait s’y attendre, moins chères que les meilleurs modèles. La clé est stockée localement dans auth.json – cela vaut la peine d’être pris en compte sur une machine partagée, mais pour les environnements d’autres personnes, une variable d’environnement est plus fiable.

    Et encore une chose : la qualité des réponses à des problèmes architecturaux complexes diffère selon les modèles de différentes classes, donc pour la conception, il est logique de prendre un modèle plus solide et de céder la routine à un modèle rapide et bon marché.

    Liens

    https://opencode.ai/
    https://opencode.ai/docs/
    https://opencode.ai/docs/providers/
    https://github.com/anomalyco/opencode
    https://platform.deepseek.com/api_keys
    https://api-docs.deepseek.com

    Sources

    https://opencode.ai/docs/
    https://opencode.ai/docs/providers/#deepseek
    https://github.com/anomalyco/opencode/releases
    https://models.dev/

  • Installer Asahi Linux sur un MacBook avec un processeur M2

    Sur un Mac équipé d’un processeur Apple Silicon, vous ne pouvez pas installer Linux de la manière habituelle : démarrer à partir d’une clé USB est ici impossible, et le bootloader est signé par Apple. Le projet Asahi Linux a entrepris de contourner ce problème : ses participants ont utilisé l’ingénierie inverse pour faire fonctionner le matériel M1 et M2 sous Linux classique. Désormais, la distribution phare du projet est Fedora Asahi Remix, et elle fonctionne de manière assez fiable sur le M2. Dans cet article, je décrirai l’installation étape par étape.

    Qu’est-ce qu’Asahi Linux

    Le projet a débuté en 2020, lorsque Apple est passé à ses propres puces et avec elles un système de démarrage fermé : l’appareil exécute uniquement du code signé par Apple. Les participants à Asahi Linux ont écrit leur chargeur de démarrage m1n1, sur lequel ils ont écrit U-Boot et un environnement UEFI. Ensuite, le système ARM64 le plus courant est chargé, mais avec un noyau Linux-asahi, auquel sont ajoutés des pilotes pour le matériel Apple non standard : GPU, vidéo, son, unités de caméra.

    En pratique, cela ressemble à ceci : vous exécutez l’installateur depuis macOS, il partitionne le disque, installe la chaîne de démarrage et le système. macOS reste en place, vous bénéficiez du double démarrage et choisissez votre système lorsque vous l’allumez.

    Exigences

    • Mac sur puce M2 : MacBook Air, MacBook Pro 13 “, ainsi que 14” et 16 ″ avec M2 Pro et M2 Max. Les voitures M1 sont également prises en charge.
    • MacOS actuel. Le programme d’installation nécessite la dernière version du système, donc mettez-le à jour avant de commencer.
    • Espace libre. Minimum environ 30 Go, confortable – 100 Go ou plus. L’espace est coupé du conteneur APFS et ne reviendra pas tout seul.
    • Mot de passe de l’administrateur macOS. Vous en aurez besoin à la fois lors du partitionnement et lors du premier démarrage en mode de récupération.
    • Sauvegarde. Le partitionnement de disque est une opération qu’il est préférable de démarrer avec une nouvelle sauvegarde.

    Étape 1. Sauvegarde et mise à jour

    Faites une copie via Time Machine ou toute autre méthode. Mettez à jour macOS vers la dernière version disponible et redémarrez. Si FileVault est activé, le mot de passe correspondant sera toujours nécessaire au démarrage en mode de récupération – le programme d’installation doit déverrouiller le lecteur.

    Étape 2. Lancez le programme d’installation

    Ouvrez le Terminal sur macOS et exécutez une commande :

    curl https://alx.sh | sh
    

    Il s’agit de l’installateur officiel du projet. Il se téléchargera tout seul, vérifiera votre modèle de Mac et vous proposera de choisir une distribution. Il existe également une option directement pour Fedora :

    curl https://fedora-asahi-remix.org/install | sh
    

    La première option est préférable : elle indique quels systèmes sont actuellement disponibles et elle propose également un choix de bureau.

    Étape 3. Partition de disque

    Le programme d’installation demandera le mot de passe administrateur et affichera la disposition actuelle. Le dialogue ressemble alors à ceci :

    • Appuyez sur r pour redimensionner la partition macOS.
    • Entrez la taille de la nouvelle partition Linux. Cela peut être en gigaoctets, cela peut être en pourcentage du disque, ou vous pouvez écrire min – alors le plus petit morceau possible sera coupé.
    • Confirmez le marquage avec la lettre y. Cette étape est la plus longue : le système déplace physiquement les données dans le conteneur APFS ; sur un disque volumineux, cela prend plusieurs minutes.
    • Appuyez sur f pour diriger le programme d’installation vers la partition libre nouvellement créée.

    Il est important de comprendre ce qui se passe : Linux n’est pas installé dans APFS, mais sur une partition distincte à côté de celui-ci. C’est pourquoi macOS reste intact et le rollback se réduit à la suppression de cette section.

    Étape 4. Sélection de la distribution et du bureau

    Ensuite, le programme d’installation proposera l’environnement système et de bureau. Fedora Asahi Remix est livré par défaut avec KDE Plasma – c’est l’option phare qui reçoit les mises à jour en premier. Une alternative est GNOME, qui est plus proche de macOS. Il existe également une image minimale si vous n’avez pas besoin d’un environnement graphique.

    Étape 5. Premier démarrage en mode de récupération

    Après le partitionnement, le programme d’installation vous demandera de continuer et le Mac s’éteindra. Voici la partie la plus inhabituelle :

    • Attendez au moins 25 secondes : c’est la condition requise par Apple pour passer en mode de récupération.
    • Maintenez enfoncé le bouton d’alimentation jusqu’à ce que les options de démarrage apparaissent.
    • Sélectionnez le volume d’installation et saisissez votre mot de passe macOS.

    A cette étape, la chaîne de démarrage est installée dans la partition de service : environnement m1n1, U-Boot et UEFI. Ensuite, la machine redémarrera à nouveau – maintenez à nouveau le bouton d’alimentation enfoncé et sélectionnez un nouveau volume, cette fois pour accéder au système. Il y aura plusieurs redémarrages de ce type, chacun nécessitant une sélection manuelle : par défaut, le Mac continue de charger macOS.

    Étape 6. Installation du système

    Ensuite, l’assistant de configuration initiale démarre : nom du système, utilisateur, mot de passe, fuseau horaire, disposition du clavier. Après cela, l’installation elle-même commence, et elle provient déjà d’Internet – vous aurez besoin d’une connexion stable et, avec le temps, cela prend de quinze minutes à une demi-heure.

    Une fois l’installation terminée, redémarrez et sélectionnez Linux dans le menu de démarrage. Lorsque vous vous connectez pour la première fois, le système vous invite à terminer la configuration et la mise à jour.

    Ce qui fonctionne et ce qui ne fonctionne pas

    Avant l’installation, vous devez évaluer sobrement ce que vous allez perdre. Sur les ordinateurs portables M2, la situation est la suivante :

    Travaux:

    • Wi-Fi et Bluetooth – sans restrictions.
    • Écran et graphiques intégrés – accélération matérielle, y compris OpenGL et Vulkan.
    • Webcam, microphone et haut-parleurs sur MacBook Air et MacBook Pro.
    • Mode veille : fonctionne normalement.
    • Décodage vidéo matériel : les lecteurs ne chargent pas le processeur.
    • Ports USB, notamment USB 2 et USB 3 via des connecteurs Thunderbolt.

    Ne fonctionne pas ou fonctionne partiellement :

    • Touch ID. L’empreinte digitale n’est pas disponible sous Linux – connectez-vous avec un mot de passe.
    • Thunderbolt (USB4). Statut – en développement. Malheureusement, les appareils qui nécessitent spécifiquement Thunderbolt ne fonctionneront pas.
    • Moniteur externe via USB-C. Le mode DisplayPort Alt est également opérationnel. Les ordinateurs portables M2 n’ont pas de port HDMI, vous ne pouvez donc pas connecter un écran externe. Les modèles avec M2 Pro et M2 Max ont HDMI, et cela fonctionne. Une solution de contournement pour l’USB-C se trouve dans la section Fairydust Core ci-dessous.
    • L’encodage vidéo matériel est prévu, le décodage est déjà en place.

    En termes simples, c’est un excellent système pour travailler avec du code, un terminal, un navigateur et des modèles locaux, mais pas pour une station d’accueil pour moniteur externe.

    Moniteur externe via Fairydust Core

    La sortie d’image USB-C est disponible dans la branche expérimentale du noyau Fairydust de l’équipe Asahi Linux. Son assemblage manuel prend beaucoup de temps, il est donc plus facile d’utiliser le script wrapper du projet asahi-fairydust-display :

    git clone https://github.com/bharambetejas/asahi-fairydust-display
    cd asahi-fairydust-display
    chmod +x asahi-fairydust-build.sh
    ./asahi-fairydust-build.sh
    

    Le script clone la branche fairydust, configure et assemble le noyau, le place à côté du noyau standard et édite GRUB. Vous avez besoin de 15 Go d’espace libre, d’un adaptateur USB-C → HDMI ou DisplayPort et de 60 à 90 minutes pour l’assemblage. Après le redémarrage, sélectionnez le noyau intitulé -fairydust dans GRUB et insérez l’adaptateur dans le port USB-C le plus en avant.

    Vérifiez après le téléchargement :

    uname -r
    glxinfo | grep "OpenGL renderer"
    xrandr
    

    La première commande doit afficher la version avec le suffixe -fairydust, la seconde doit afficher l’Apple M2, pas llvmpipe, la troisième doit afficher la sortie DP-1 connectée.

    Réservations. La branche est expérimentale et n’est pas officiellement prise en charge. La sortie ne fonctionne que via un seul port USB-C et ne résiste pas toujours au branchement à chaud : il est plus sûr de redémarrer avec l’adaptateur déjà inséré. Le script ne configure pas automatiquement l’affichage : l’étape correspondante est désactivée car elle a provoqué une boucle de connexion sur Wayland. La mise à jour du noyau d’origine via dnf réorganise le lien symbolique /boot/dtb, c’est pourquoi la sortie peut cesser de fonctionner silencieusement – la construction doit alors être répétée.

    Le noyau standard n’est pas touché : pour y revenir, il suffit de le sélectionner dans le menu GRUB.

    Disque externe au lieu d’une mise à niveau

    Voici le bon côté. Le MacBook ne peut pas être mis à niveau : la mémoire et le stockage sont soudés sur la carte, et leur capacité est sélectionnée une fois lors de l’achat. Sous macOS, le disque externe reste externe : le système et les applications ne peuvent pas vraiment y être transférés.

    Sous Linux, cette limitation est supprimée : un SSD externe via USB est un périphérique de bloc standard, et n’importe quel point de montage peut y être transféré via /etc/fstab. Si vous souhaitez transférer votre répertoire personnel, votre bibliothèque Steam, des images de machine virtuelle ou des modèles locaux, veuillez le faire. Il s’avère que c’est exactement la mise à niveau que cette voiture n’a pas.

    Cela ressemble à ceci. Tout d’abord, regardez l’UUID de la partition souhaitée :

    lsblk -f
    sudo blkid
    

    Ajoutez ensuite la ligne dans /etc/fstab :

    UUID=ваш-uuid  /home  ext4  defaults,nofail  0  2
    

    Le transfert lui-même se fait par copie : les données sont déplacées vers un disque externe, après quoi elles sont montées à l’endroit souhaité. Le plus souvent, ce n’est pas le /home entier qui est supprimé de cette façon, mais des répertoires individuels lourds – de cette façon, il y a moins de risques.

    Quelques mises en garde. Le paramètre nofail mérite d’être paramétré dans les options : sans lui, le système ne démarrera pas si le disque n’est pas connecté. La vitesse d’une clé USB est toujours inférieure à celle du NVMe intégré, il est donc préférable de laisser de l’espace sur le disque interne pour les opérations d’E/S fréquentes. Et il n’est pas nécessaire de retirer le disque lors du déplacement avec les répertoires qui y sont montés – démontez-le d’abord.

    Comment basculer entre les systèmes

    Lorsque vous l’allumez, maintenez le bouton d’alimentation enfoncé – le menu de démarrage apparaîtra, il contiendra macOS et Linux. Vous pouvez sélectionner le système par défaut dans macOS : « Préférences Système » → « Général » → « Disque système ». Linux dispose également des paramètres correspondants, vous pouvez donc basculer dans les deux sens sans terminal.

    Liens

    https://asahilinux.org/fedora/
    https://asahilinux.org/docs/
    https://asahilinux.org/docs/platform/feature-support/m2/
    https://fedoraproject.org/asahi-remix
    https://github.com/bharambetejas/asahi-fairydust-display
    https://github.com/AsahiLinux/linux/tree/fairydust

    Sources

    https://asahilinux.org/docs/platform/feature-support/m2/
    https://discussion.fedoraproject.org/t/fedora-asahi-remix-installation-guide/
    https://github.com/AsahiLinux/docs
    https://github.com/bharambetejas/asahi-fairydust-display/blob/main/README.md
    https://github.com/bharambetejas/asahi-fairydust-display/blob/main/asahi-fairydust-build.sh

  • Installation de VirtualBox avec des ajouts d’invités sur un Mac ARM

    Instructions pour installer Ubuntu Server dans VirtualBox sur un Mac avec un processeur ARM64 et connecter les suppléments invité.

    Installer VirtualBox

    Téléchargez la version ARM64 de VirtualBox, montez l’image et transférez VirtualBox.app vers Applications.

    Configurer une machine virtuelle

    Nous créons une nouvelle machine, spécifions le type Linux et la version Ubuntu (ARM 64 bits). Dans les paramètres, nous définissons :

    • TPM – désactiver
    • UEFI – désactiver
    • RAM – 4 096 Mo.
    • Contrôleur graphique – VMSVGA (pour VBoxLinuxAdditions).
    • Processeur – 4 cœurs.

    Installer le serveur Ubuntu

    Montez l’image ISO du serveur Ubuntu pour ARM64 dans le lecteur de CD-ROM. Dans la section de téléchargement, placez le lecteur optique en premier dans la liste. Nous démarrons la machine et procédons à l’installation d’Ubuntu Server.

    Installer xubuntu-desktop

    Installez l’environnement graphique XFCE :

    sudo apt update
    sudo apt install -y xubuntu-desktop
    

    Dans la boîte de dialogue de sélection du gestionnaire de connexion, sélectionnez lightdm.

    Redémarrez le système invité :

    sudo reboot
    

    Ajouts d’invités

    Après le premier démarrage, installez les packages pour créer les modules du noyau :

    sudo apt update
    sudo apt install -y build-essential linux-headers-$(uname -r)
    

    Nous montons le disque avec les suppléments invité via le menu VirtualBox : Périphériques → Monter l’image disque des suppléments invité. Le disque apparaîtra à l’intérieur de l’invité dans le répertoire /media/$USER.

    Ouvrez un terminal dans Xubuntu, allez dans le répertoire du disque monté et exécutez l’installateur :

    cd /media/$USER/*
    sudo ./VBoxLinuxAdditions-arm64.run
    

    Redémarrez le système invité :

    sudo reboot
    

    Qu’est-ce qui devrait fonctionner après l’installation

    On vérifie que les modules du noyau sont chargés :

    lsmod | grep vbox
    

    La sortie doit inclure vboxguest et vboxsf.

    Ajoutez un dossier partagé dans les propriétés de la machine et montez-le dans l’invité :

    sudo mkdir -p /media/sf_shared
    sudo mount -t vboxsf shared /media/sf_shared
    

    Caractéristiques de travail :

    • Dossiers partagés : le répertoire hôte est visible dans l’invité via vboxsf.
    • Presse-papiers partagé : copiez le texte entre l’hôte et l’invité.
    • Intégration de la souris : le curseur s’étend librement en dehors de la fenêtre de la machine.
    • Changement automatique de résolution : l’écran invité s’ajuste à la taille de la fenêtre.
    • Synchronisation de l’heure : l’heure de l’invité est ajustée à celle de l’hôte.

    Sources

    https://www.virtualbox.org/manual/topics/guestadditions.html
    https://forums.virtualbox.org/viewtopic.php?t=112886

  • Comment connecter DeepSeek à Claude Code

    Claude Code est un agent console d’Anthropic qui peut lire des fichiers de projet, éditer du code, exécuter des commandes et des tests, rechercher dans le référentiel et travailler avec git. Le principal inconvénient lors de son utilisation est le coût : de longues sessions avec beaucoup de contexte engloutissent vite le budget de l’abonnement.

    Il existe une solution. DeepSeek fournit un point de terminaison compatible avec l’API Anthropic. Il suffit de changer l’adresse de base et le jeton, et Claude Code commencera à fonctionner sur les modèles DeepSeek, sans nécessiter de réinstallation ni de correctif. Dans cet article, je décrirai comment configurer cela sur macOS, Linux et Windows.

    Pourquoi est-ce nécessaire

    Les raisons peuvent être différentes :
    – Prix. Les modèles DeepSeek sont nettement moins chers que Claude, et pour les tâches de routine des agents – navigation dans un projet, modifications mineures, exécution de tests – une qualité optimale n’est pas toujours nécessaire.
    – Disponibilité. Si vous n’avez pas d’abonnement ou si le paiement avec une carte Anthropic n’est pas disponible pour une raison quelconque, DeepSeek devient une option fonctionnelle.
    – Expériences. Il est intéressant de comparer la façon dont différents modèles gèrent la même base de code dans le même environnement.

    Ce dont vous avez besoin

    Vous devez installer Claude Code et la clé API DeepSeek. Si Claude Code n’est pas déjà installé, l’ordre est le suivant :
    1. Installez Node.js 18 ou version ultérieure. Sous Windows, vous aurez également besoin de Git pour Windows.
    2. Installez Claude Code lui-même à l’aide de la commande ci-dessous.
    3. Vérifiez l’installation.

    npm install -g @anthropic-ai/claude-code
    claude --version
    

    Si la version s’affiche, l’installation a réussi. La clé API est créée dans votre compte personnel DeepSeek sur la page des clés.

    Configuration via variables d’environnement

    Toute intégration se résume à des variables d’environnement. Pour macOS et Linux, cela ressemble à ceci :

    export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
    export ANTHROPIC_AUTH_TOKEN=ваш_ключ_deepseek
    
    export ANTHROPIC_MODEL=deepseek-flash[1m]
    export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
    export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
    export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
    export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
    
    export CLAUDE_CODE_EFFORT_LEVEL=max
    export CLAUDE_CODE_AUTO_COMPACT_WINDOW=786432
    

    Pour Windows dans PowerShell, la syntaxe est différente, mais les noms de variables sont les mêmes :

    $env:ANTHROPIC_BASE_URL="https://api.deepseek.com/anthropic"
    $env:ANTHROPIC_AUTH_TOKEN="ваш_ключ_deepseek"
    $env:ANTHROPIC_MODEL="deepseek-flash[1m]"
    

    Voyons ce qui se passe ici. La variable `ANTHROPIC_BASE_URL` redirige les requêtes des serveurs Anthropic vers DeepSeek. `ANTHROPIC_AUTH_TOKEN` remplace votre clé. Les variables restantes déterminent quel modèle est utilisé dans quel rôle. Il existe des modèles avec le suffixe « [1m] » – il s’agit d’une option avec une fenêtre contextuelle d’environ un million de jetons, qui permet à l’agent de conserver beaucoup plus de fichiers de projet à la fois. En conséquence, `CLAUDE_CODE_AUTO_COMPACT_WINDOW` est défini sur la taille de cette fenêtre afin que la compression automatique de l’historique ne fonctionne pas trop tôt.

    Il est pratique de ne pas exporter manuellement les variables à chaque fois, mais de les enregistrer dans la configuration de Claude Code. Ensuite, les paramètres seront récupérés automatiquement au démarrage.

    {
      "env": {
        "ANTHROPIC_BASE_URL": "https://api.deepseek.com/anthropic",
        "ANTHROPIC_AUTH_TOKEN": "ваш_ключ_deepseek",
        "ANTHROPIC_MODEL": "deepseek-flash[1m]",
        "ANTHROPIC_DEFAULT_HAIKU_MODEL": "deepseek-flash",
        "CLAUDE_CODE_SUBAGENT_MODEL": "deepseek-flash"
      }
    }
    

    Après cela, allez dans le répertoire du projet et exécutez l’agent :

    cd ваш_проект
    claude
    

    Claude Code dans VS Code

    Claude Code est disponible non seulement dans le terminal, mais également en tant qu’extension pour VS Code. Il s’installe normalement : ouvrez le panneau des extensions en utilisant Cmd+Shift+X, recherchez “Claude Code” et cliquez sur Installer. L’extension est produite par Anthropic lui-même.

    L’extension contient sa propre copie de la CLI et lit le même fichier ~/.claude/settings.json que la version du terminal. Les paramètres de la section précédente s’appliquent également ici – mais avec une mise en garde, qui prête le plus souvent à confusion.

    La vérification des entrées a lieu avant le lancement

    Avant de démarrer, l’extension vérifie les informations d’identification à partir de son propre paramètre « claudeCode.environmentVariables », et non à partir de settings.json. Les valeurs de settings.json atteignent le processus en cours – c’est-à-dire que l’adresse API et les modèles sélectionnés sont correctement récupérés – mais elles ne passent pas le contrôle de connexion de l’extension. Si vous voyez l’écran de connexion alors que tout fonctionne déjà dans le terminal, c’est la raison.

    Cela peut être guéri avec quelques lignes dans les paramètres de VS Code : dupliquez les variables dans `claudeCode.environmentVariables` et désactivez la demande de connexion.

    {
      "claudeCode.environmentVariables": [
        { "name": "ANTHROPIC_BASE_URL", "value": "https://api.deepseek.com/anthropic" },
        { "name": "ANTHROPIC_AUTH_TOKEN", "value": "ваш_ключ_deepseek" },
        { "name": "ANTHROPIC_MODEL", "value": "deepseek-flash[1m]" }
      ],
      "claudeCode.disableLoginPrompt": true
    }
    

    nuance macOS

    Si vous lancez VS Code depuis le Dock ou le Finder, il n’hérite pas des variables d’environnement de ~/.zshrc. Il s’agit d’un comportement standard de macOS et est spécifiquement abordé dans la documentation Claude Code. Autrement dit, `export ANTHROPIC_BASE_URL=…` dans votre shell pour l’extension ne fonctionnera tout simplement pas – cette variable ne sera pas dans son environnement.

    Il y a deux conclusions à en tirer. Premièrement, les paramètres de `claudeCode.environmentVariables` sont plus fiables que les variables shell. Deuxièmement, si vous préférez toujours un shell, lancez l’éditeur depuis le terminal, où les variables sont déjà exportées :

    code .
    

    Ce qui ne fonctionnera pas

    Sur un fournisseur tiers, certaines fonctionnalités d’extension ne sont pas disponibles car elles nécessitent un compte claude.ai :
    – il n’y aura pas de barre d’utilisation du forfait, de saisie vocale et d’onglet Web pour les sessions cloud ;
    – les commandes de déconnexion ne sont pas affichées dans le menu ;
    – `/usage` affichera la consommation et le nombre de jetons de la session en cours au lieu des limites du plan ;
    – La télécommande ne fonctionne pas si l’adresse de base n’est pas anthropique.

    Il s’agit d’un comportement attendu et non d’un signe d’échec de l’installation.

    Par ailleurs, je voudrais ajouter que JetBrains possède son propre plugin, mais il est conçu différemment : il ne contient pas de CLI intégrée, mais en lance une déjà installée dans le terminal intégré. Il n’y a pas de paramètres pour les variables d’environnement, vous devez donc lancer l’EDI à partir du terminal avec les variables déjà exportées.

    Comment DeepSeek comprend les noms de modèles de Claude

    Claude Code fait référence en interne aux modèles par des noms comme claude-opus, claude-sonnet et claude-haiku. DeepSeek intercepte ces noms et les remplace par les siens :
    – tout ce qui commence par claude-opus va vers deepseek-v4-pro ;
    – tout ce qui commence par claude-sonnet ou claude-haiku va vers deepseek-flash ;
    – le nom du modèle inconnu est également réduit à deepseek-flash.

    Cela signifie que même sans spécifier explicitement les modèles, l’intégration fonctionnera – mais il est préférable de contrôler explicitement quels modèles et à quel tarif répondront à la demande. C’est pourquoi, dans les paramètres, tous les rôles sont écrits manuellement.

    À quoi faire attention

    La compatibilité est incomplète et vous devez le savoir à l’avance. DeepSeek ignore simplement certaines des capacités de l’API Anthropic :

    – Invites de mise en cache. Le champ `cache_control` n’est pas pris en charge. Claude Code utilise activement le cache afin de ne pas payer trop cher pour envoyer le même contexte à plusieurs reprises. Cela n’arrivera pas ici, donc les longues sessions sont plus chères que ce à quoi on pourrait s’attendre du prix par jeton. Commencez périodiquement un nouveau dialogue au lieu de poursuivre sans fin l’ancien.
    – Thinking Budget. Le paramètre `thinking` est pris en charge, mais les `budget_tokens` qu’il contient sont ignorés.
    – Divers. Les champs `top_k`, `service_tier`, `container` et la connexion des serveurs MCP depuis l’API sont également ignorés.
    – MCP. Le mécanisme du serveur MCP intégré côté DeepSeek ne fonctionne pas, bien que les outils habituels de l’agent – lecture de fichiers, édition, exécution de commandes, recherche – fonctionnent normalement.

    Séparément, il convient de mentionner les procurations. Il existe des projets dans la communauté comme « ds-cc-proxy », qui sont placés entre Claude Code et DeepSeek et se chargent de lisser les incompatibilités mineures, ainsi que de séparer la session principale et les sous-agents en différents modèles. Si la configuration standard se comporte de manière instable, une telle couche intermédiaire peut aider.

    Claude Code Routeur

    La méthode décrite ci-dessus met un modèle sur toutes les tâches. Mais l’agent fait des choses très différentes : il comprend la structure du projet, corrige de petites choses et résout parfois un problème vraiment complexe. Il est logique que différents modèles soient utilisés pour différents types de travaux. C’est exactement ce que peut faire le claude-code-router (CCR) : une passerelle locale qui se situe entre Claude Code et les fournisseurs de modèles.

    Ça donne quoi

    – Routage par règles. Vous pouvez définir quel modèle sert la session principale, lequel sert les tâches en arrière-plan, lequel sert le mode de planification. Il est logique d’utiliser un modèle coûteux uniquement pour des raisonnements complexes et de confier la routine à un modèle bon marché.
    – Options de sauvegarde. Si le fournisseur renvoie une erreur, la requête est transmise au modèle suivant dans la chaîne, plutôt que d’abandonner la session.
    – Observabilité. L’interface affiche le journal des demandes, les retards, la consommation de jetons et le coût – quelque chose que vous ne pouvez deviner qu’avec une connexion directe.
    – Une adresse pour plusieurs agents. Les fournisseurs, les clés et les règles résident au même endroit, et les clients se connectent à une seule adresse locale.

    Tout d’abord à propos des versions : c’est important

    Cela vaut la peine d’être averti ici car cela vous fera gagner du temps. CCR a été fortement repensé au cours de son histoire, et presque tous les articles que vous trouvez dans une recherche décrivent la version obsolète.

    Dans les anciennes versions, la configuration était dans le fichier ~/.claude-code-router/config.json avec les blocs Providers et Router, et tout était lancé avec la commande `ccr code`. Maintenant, cela ne fonctionne plus ainsi. La version actuelle (3.x) stocke les paramètres dans la base de données SQLite et est gérée via une interface Web. L’ancien config.json est lu exactement une fois comme source de migration s’il n’y a pas encore de base de données – après cela, les modifications qui y sont apportées n’affectent rien.

    Autrement dit, si vous avez trouvé des instructions sur Internet pour éditer config.json et la commande `ccr code` et que rien n’a fonctionné pour vous, vous éditez un fichier que personne ne lit plus. Ce n’est pas ta faute.

    Installation

    Vous aurez besoin de Node.js 22 ou version ultérieure.

    npm install -g @musistudio/claude-code-router
    ccr ui
    

    La commande `ccr ui` fait apparaître le service en arrière-plan et ouvre l’interface de gestion dans le navigateur. Il est utile de connaître les autres commandes : `ccr start` démarre un service, `ccr stop` l’arrête, `ccr serve` fonctionne au premier plan et est pratique lorsque vous avez besoin de voir les journaux.

    Par défaut, l’interface de gestion réside sur le port 3458 et la passerelle elle-même pour les modèles réside sur le port 3456.

    Paramètres

    Tout se fait dans l’interface web, sans édition manuelle des fichiers :
    1. Dans la section Fournisseurs, ajoutez le fournisseur DeepSeek et spécifiez sa clé. Remarque : l’adresse complète jusqu’au point de discussion/d’achèvement est nécessaire ici, pas seulement le domaine.
    2. Dans la section Modèles, décrivez ce qu’est ce modèle – la description facilite le routage.
    3. Dans la section Agent Config, définissez le modèle par défaut.
    4. Dans la section Routage, configurez les règles : quel modèle répond à quelles requêtes.
    5. Sur la page Clés API, créez une clé client CCR – c’est ce que Claude Code utilisera, pas la clé DeepSeek.

    Après cela, il ne reste plus qu’à envoyer Claude Code à la passerelle : préciser l’adresse de la passerelle affichée dans l’interface comme adresse de base, et la clé client CCR comme token.

    Une bonne chose : les règles de routage peuvent être écrites non seulement avec des champs, mais également avec un script JavaScript, si la logique est plus complexe que la comparaison d’un champ.

    Est-ce que ça vaut la peine de l’utiliser

    Connecter DeepSeek à Claude Code est avant tout un moyen de réduire les coûts sans renoncer à un environnement d’agent pratique. Vous obtenez la même interface, les mêmes outils et le même workflow, mais sur un modèle différent. La configuration prend quelques minutes et est totalement réversible : il suffit de supprimer les variables d’environnement pour revenir aux modèles Anthropic.

    Les limites sont également claires : il n’y a pas de cache d’invite, une compatibilité incomplète en ce qui concerne les champs de l’API et la qualité du modèle peut différer pour des tâches architecturales complexes. Pour le travail de routine dans le référentiel – navigation, refactoring, exécution de tests – c’est plus que suffisant.

    Exemple : Oni-Extended

    Un exemple vivant d’une telle combinaison est mon projet Oni-Extended, un fork du portage du jeu Oni ​​(Bungie, 2001) pour Apple Silicon. Les sources du jeu sont écrites en C et existent depuis plus de vingt ans ; ils n’ont jamais fait l’objet de tests et la taille des fichiers est mesurée en dizaines de milliers de lignes. Cependant, de nouvelles fonctionnalités ont été ajoutées au projet via Claude Code de DeepSeek : sauvegarde et chargement rapides via F5/F9, un bloc de maintien de clé et un indicateur de lancement -nodamage qui désactive les dommages.

    C’est une bonne illustration de ce qui a été dit ci-dessus. Toutes les tâches concernent un travail de routine dans un grand référentiel : l’agent examine le code d’autres personnes, trouve des connexions entre les modules et teste des hypothèses, plutôt que de concevoir une architecture à partir de zéro. Le coût de telles sessions sur DeepSeek s’avère sensiblement inférieur à celui sur les modèles Anthropic, malgré le fait que le résultat est vérifié par la propre infrastructure du projet : assemblage, level run stand et tests hors ligne.

    Liens

    https://platform.deepseek.com/api_keys
    https://api-docs.deepseek.com
    https://docs.anthropic.com/en/docs/claude-code
    https://github.com/anthropics/claude-code
    https://github.com/musistudio/claude-code-router
    https://ccrdesk.top/en/guides/cli/
    https://github.com/zefir1990/Oni-Extended

    Sources

    https://api-docs.deepseek.com/guides/anthropic_api
    https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code
    https://ccrdesk.top/en/routing/
    https://code.claude.com/docs/en/vs-code
  • Donki Hills est officiellement sur Steam depuis plus d’un an !

    Donki Hills est sur Steam depuis plus d’un an maintenant !

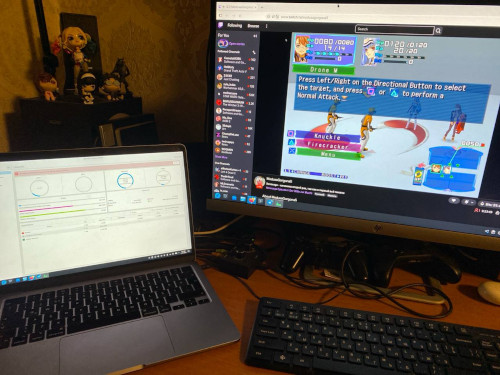
    Il y a exactement un an, le projet est apparu sur la page Steam, et depuis lors, le jeu a parcouru un long chemin. Pendant ce temps, il y a eu de nombreuses expériences, changements et recherches sur la direction même dans laquelle Donki Hills devrait se développer.

    Le travail sur le gameplay se poursuit, et désormais le projet acquiert progressivement son vrai visage. Donki Hills commence à devenir ce qu’il était censé être : une comédie à la première personne, un roguelike, une parodie de survie et d’horreur.

    Une aventure étrange où l’horreur rencontre l’humour, l’exploration et les situations inattendues. Vous devez vous rendre en ville, chercher des objets, résoudre des énigmes et découvrir progressivement le secret qui vous mènera à Maria.

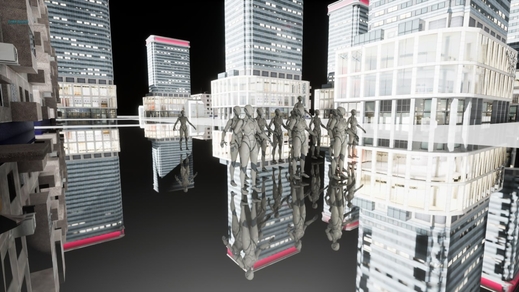
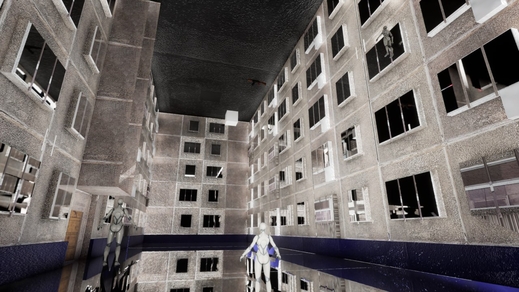
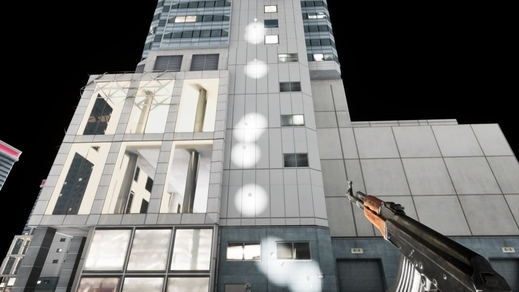
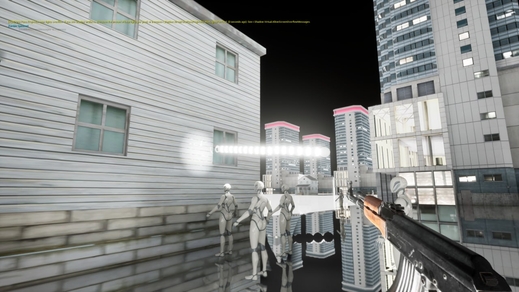
    Vous trouverez ci-dessous de nouvelles captures d’écran du prochain test de jeu du prototype. Ce n’est pas encore la version finale du jeu, mais vous pouvez déjà ressentir l’atmosphère de la ville et la direction dans laquelle évolue le projet.

    Très intéressé d’entendre votre réaction! 👀
    Comment aimez-vous la nouvelle direction ? Quelles sont vos impressions sur l’ambiance et les idées du jeu ?

    Merci à tous ceux qui ont ajouté Donki Hills à leur liste de souhaits, suivent le développement et soutiennent le projet ❤️

    Il y a encore de nombreuses expériences, de nouvelles mécaniques et d’étranges aventures à venir.

    https://store.steampowered.com/app/3476390/Donki_Hills/

  • Contourner la limitation sur les processeurs des ordinateurs portables de jeu

    Les fabricants d’ordinateurs portables de jeu modernes configurent souvent les systèmes de manière à ce que le processeur chauffe jusqu’à 90 degrés et atteigne même 100 degrés Celsius sous charge. Ce problème est particulièrement aigu en été lors de l’exécution de jeux exigeants ou de tâches lourdes.

    En raison d’un échauffement extrême, le throttling est activé (réinitialisation des fréquences du processeur pour éviter tout dommage physique), ce qui entraîne une forte perte de performances, des blocages et une baisse des FPS. Il existe de nombreuses façons de lutter contre la surchauffe (de l’utilisation de coussinets de refroidissement à la sous-tension), mais dans cet article, je décrirai la méthode la plus simple et la plus rapide pertinente pour Windows 11 et les versions antérieures du système d’exploitation.

    La méthode consiste à limiter l’état maximum du processeur via les paramètres d’alimentation :

    1. Ouvrez les Options d’alimentation via la recherche Windows ou le Panneau de configuration.
    2. Dans le plan d’alimentation actif, accédez à la section permettant de modifier des paramètres supplémentaires.
    3. Recherchez la branche Gestion de l’alimentation du processeur.
    4. Développez l’option État maximal du processeur.
    5. Pour Plugged In, modifiez la valeur de 100 % à 80 % ou moins.

    Après avoir appliqué ces paramètres, le processeur n’overclockera plus automatiquement à des fréquences extrêmes générant une chaleur excessive. Même si les performances maximales diminuent d’environ 20 %, le processeur ne surchauffera plus. Un fonctionnement stable à une fréquence réduite sans limitation est BEAUCOUP meilleur et plus confortable pour le système que des sauts de performances constants et brusques dus à une surchauffe à des températures inférieures à 100 degrés.

    Chaque ordinateur portable est unique, je recommande donc aux utilisateurs d’expérimenter et de trouver l’équilibre optimal (pourcentage) qui fournira les performances souhaitées sans surchauffe.

  • Portage du Surreal Engine C++ vers WebAssembly

    Dans cet article, je décrirai comment j’ai porté le moteur de jeu Surreal Engine vers WebAssembly.
    https://demensdeum.com/demos/SurrealEngine/”
    Moteur surréaliste – un moteur de jeu qui implémente la plupart des fonctionnalités de l’Unreal Engine 1, des jeux célèbres sur ce moteur – Unreal Tournament 99, Unreal, Deus Ex, Undying. Il fait référence aux moteurs classiques qui fonctionnaient principalement dans un environnement d’exécution monothread.
    Au départ, j’ai eu l’idée de me lancer dans un projet que je ne pouvais pas réaliser dans un délai raisonnable, montrant ainsi à mes abonnés Twitch qu’il y a des projets que même moi je ne peux pas réaliser. Lors de mon premier stream, j’ai soudainement réalisé que la tâche de porter Surreal Engine C++ vers WebAssembly à l’aide d’Emscripten était réalisable.

    Un mois plus tard, je peux faire une démonstration de mon ensemble fourche et moteur sur WebAssembly :
    https://demensdeum.com/demos/SurrealEngine/
    Le contrôle, comme dans l’original, s’effectue à l’aide des flèches du clavier. Ensuite, je prévois de l’adapter au contrôle mobile (tachi), en ajoutant un éclairage correct et d’autres fonctionnalités graphiques du rendu Unreal Tournament 99.

    Par où commencer ?

    La première chose que je veux dire est que n’importe quel projet peut être porté de C++ vers WebAssembly en utilisant Emscripten, la seule question est de savoir dans quelle mesure la fonctionnalité sera complète. Choisissez un projet dont les ports de bibliothèque sont déjà disponibles pour Emscripten ; dans le cas de Surreal Engine, vous avez beaucoup de chance, car le moteur utilise SDL 2, OpenAL – bibliothèques. ils sont tous deux portés sur Emscripten. Cependant, Vulkan est utilisé comme API graphique, qui n’est actuellement pas disponible pour HTML5, des travaux sont en cours pour implémenter WebGPU, mais il est également au stade de projet, et on ne sait pas non plus à quel point le port ultérieur de Vulkan vers WebGPU sera simple, une fois entièrement standardisé. Par conséquent, j’ai dû écrire mon propre moteur de rendu OpenGL-ES/WebGL de base pour Surreal Engine.

    Construire le projet

    Système de construction dans Surreal Engine – CMake, qui simplifie également le portage, car Emscripten fournit à ses constructeurs natifs – emcmake, emmake.
    Le portage de Surreal Engine était basé sur le code de mon dernier jeu en WebGL/OpenGL ES et C++ appelé Death-Mask, de ce fait le développement était beaucoup plus simple, j’avais tous les indicateurs de build nécessaires avec moi et des exemples de code.
    L’un des points les plus importants de CMakeLists.txt concerne les indicateurs de construction pour Emscripten. Vous trouverez ci-dessous un exemple tiré du fichier de projet :

    set(CMAKE_CXX_FLAGS "-s MIN_WEBGL_VERSION=2 
    -s MAX_WEBGL_VERSION=2 
    -s EXCEPTION_DEBUG 
    -fexceptions 
    --preload-file UnrealTournament/ 
    --preload-file SurrealEngine.pk3 
    --bind 
    --use-preload-plugins 
    -Wall 
    -Wextra 
    -Werror=return-type 
    -s USE_SDL=2 
    -s ASSERTIONS=1 
    -w 
    -g4 
    -s DISABLE_EXCEPTION_CATCHING=0 
    -O3 
    --no-heap-copy 
    -s ALLOW_MEMORY_GROWTH=1 
    -s EXIT_RUNTIME=1")
    

    Le script de build lui-même :

    clear
    emmake make -j 16
    cp SurrealEngine.data /srv/http/SurrealEngine/SurrealEngine.data
    cp SurrealEngine.js /srv/http/SurrealEngine/SurrealEngine.js
    cp SurrealEngine.wasm /srv/http/SurrealEngine/SurrealEngine.wasm
    cp ../buildScripts/Emscripten/index.html /srv/http/SurrealEngine/index.html
    

    Ensuite, préparons index.html, qui inclut le préchargeur du système de fichiers du projet. Pour télécharger sur le Web, j’ai utilisé Unreal Tournament Demo version 338. Comme vous pouvez le voir sur le fichier CMake, le dossier du jeu décompressé a été ajouté au répertoire de construction et lié en tant que fichier de préchargement pour Emscripten.

    Modifications du code principal

    Ensuite, nous avons dû changer la boucle de jeu du jeu, vous ne pouvez pas exécuter une boucle sans fin, cela conduit au blocage du navigateur, vous devez plutôt utiliser emscripten_set_main_loop, j’ai écrit à propos de cette fonctionnalité dans ma note de 2017 “Portage de jeux SDL C++ vers HTML5 (Emscripten)”
    Nous modifions le code pour quitter la boucle while en if, puis nous affichons la classe principale du moteur de jeu, qui contient la boucle de jeu, dans la portée globale, et écrivons une fonction globale qui appellera l’étape de boucle de jeu à partir de l’objet global :

    #if __EMSCRIPTEN__
    #include <emscripten.h>
    Engine *EMSCRIPTEN_GLOBAL_GAME_ENGINE = nullptr;
    void emscripten_game_loop_step() {
    	EMSCRIPTEN_GLOBAL_GAME_ENGINE->Run();
    }
    #endif
    

    Après cela, vous devez vous assurer qu’il n’y a pas de threads en arrière-plan dans l’application ; s’il y en a, préparez-vous à les réécrire pour une exécution monothread, ou utilisez la bibliothèque phtread dans Emscripten.
    Le fil d’arrière-plan de Surreal Engine est utilisé pour lire de la musique, les données proviennent du fil du moteur principal concernant la piste en cours, la nécessité de jouer de la musique ou son absence, puis le fil d’arrière-plan reçoit un nouvel état via un mutex et commence à jouer une nouvelle musique, ou fait une pause. Le fil d’arrière-plan est également utilisé pour mettre la musique en mémoire tampon pendant la lecture.
    Mes tentatives de création de Surreal Engine pour Emscripten avec pthread ont échoué, car les ports SDL2 et OpenAL ont été construits sans le support de pthread, et je ne voulais pas les reconstruire pour le plaisir de la musique. Par conséquent, j’ai transféré la fonctionnalité du flux de musique de fond vers une exécution monothread à l’aide d’une boucle. En supprimant les appels pthread du code C++, j’ai déplacé la mise en mémoire tampon et la lecture de musique vers le thread principal, afin qu’il n’y ait pas de retard, j’ai augmenté la mémoire tampon de quelques secondes.
    Ensuite, je décrirai des implémentations spécifiques des graphiques et du son.

    Vulkan n’est pas pris en charge !

    Oui, Vulkan n’est pas pris en charge en HTML5, bien que toutes les brochures marketing présentent le support multiplateforme et large plate-forme comme le principal avantage de Vulkan. Pour cette raison, j’ai dû écrire mon propre moteur de rendu graphique de base pour un type OpenGL simplifié – – ES, il est utilisé sur les appareils mobiles, parfois il ne contient pas les fonctionnalités à la mode de l’OpenGL moderne, mais il se porte très bien sur WebGL, ce qui est exactement ce qu’Emscripten implémente. L’écriture du rendu de tuiles de base, du rendu bsp, pour l’affichage GUI le plus simple et du rendu des modèles + cartes a été achevée en deux semaines. C’était peut-être la partie la plus difficile du projet. Il reste encore beaucoup de travail à faire pour implémenter toutes les fonctionnalités du rendu Surreal Engine, donc toute aide des lecteurs est la bienvenue sous forme de code et de demandes d’extraction.

    OpenAL pris en charge !

    La grande chance est que Surreal Engine utilise OpenAL pour la sortie audio. Après avoir écrit un simple hello world dans OpenAL et l’avoir assemblé dans WebAssembly à l’aide d’Emscripten, il m’est devenu clair à quel point tout était simple et j’ai commencé à porter le son.
    Après plusieurs heures de débogage, il est devenu évident que l’implémentation OpenAL d’Emscripten avait plusieurs bugs, par exemple, lors de l’initialisation de la lecture du nombre de canaux mono, la méthode a renvoyé un nombre infini, et après avoir essayé d’initialiser un vecteur de taille infinie, C++ plante avec l’exception vector::length_error.
    Nous avons réussi à contourner ce problème en codant en dur le nombre de canaux mono à 2048 :

    		alcGetIntegerv(alDevice, ALC_MONO_SOURCES, 1, &monoSources);
    		alcGetIntegerv(alDevice, ALC_STEREO_SOURCES, 1, &stereoSources);
    
    #if __EMSCRIPTEN__
    		monoSources = 2048; // for some reason Emscripten's OpenAL gives infinite monoSources count, bug?
    #endif


    Y a-t-il un réseau ?

    Surreal Engine ne prend actuellement pas en charge le jeu en ligne, le jeu avec des robots est pris en charge, mais nous avons besoin de quelqu’un pour écrire l’IA pour ces robots. Théoriquement, vous pouvez implémenter un jeu en réseau sur WebAssembly/Emscripten à l’aide de Websockets.

    Conclusion

    En conclusion, je voudrais dire que le portage de Surreal Engine s’est avéré assez fluide grâce à l’utilisation de bibliothèques pour lesquelles il existe des ports Emscripten, ainsi qu’à mon expérience passée dans l’implémentation d’un jeu en C++ pour WebAssembly sur Emscripten. Vous trouverez ci-dessous des liens vers des sources de connaissances et des référentiels sur le sujet.
    M-M-M-MONSTER KILL !
    Aussi, si vous souhaitez aider le projet, de préférence avec le code de rendu WebGL/OpenGL ES, alors écrivez-moi dans Telegram :
    https://t.me/demenscave

    Liens

    https://demensdeum.com/demos/SurrealEngine/

    https://github.com/demensdeum/SurrealEngine-Emscripten

    https://github.com/dpjudas/SurrealEngine

  • Redirection de port entre clients via Chisel : un tunnel épuré sans L3

    Lorsque deux appareils sont derrière un NAT ou un pare-feu strict et ne peuvent pas se « voir » directement, un VPN semble être la solution standard. Mais un tunnel L3 à part entière (comme WireGuard ou OpenVPN) est souvent redondant : il nécessite des droits root, la configuration d’interfaces virtuelles et peut entrer en conflit avec les routes existantes.

    Dans de tels cas, il est pratique d’utiliser Chisel – un tunnel TCP/UDP qui s’exécute sur HTTP et utilise WebSockets pour le transfert de données. Dans cette note, je vais montrer comment « transférer » un port d’un client à un autre via un serveur intermédiaire.

    Comment ça marche ?

    Imaginez la situation : vous disposez d’un Client A (par exemple, votre serveur domestique), d’un Client B (votre ordinateur portable de travail) et d’un VPS avec une adresse IP publique. Les clients A et B peuvent accéder au VPS, mais pas l’un à l’autre.

    Le schéma de transfert ressemblera à ceci :
    1. Le Client A se connecte au VPS et ouvre un port « inverse » sur le serveur. Désormais, tout ce qui arrive au port X du serveur va au port Y du client A.
    2. Le Client B se connecte au VPS et transfère le port Z de sa machine locale vers le port X du serveur.
    3. En conséquence, le client B accède à localhost:Z et se retrouve sur le client A:Y.

    Cette approche est l’une des solutions dans les cas où la communication avec un VPS n’implémente pas de couche L3 ou où il n’y a pas de possibilité de configurer le routage entre les clients. Nous travaillons exclusivement au niveau applicatif et portuaire.

    Étape 1 : Démarrez le serveur

    Sur votre VPS, exécutez simplement Chisel en mode serveur. L’indicateur --reverse est requis pour permettre aux clients d’ouvrir des ports côté serveur.

    chisel server --port 8080 --reverse
    

    Étape 2 : Connexion du client A (source)

    Disons que le client A souhaite ouvrir l’accès à son serveur Web local sur le port 3000. Il se connecte au VPS et dit : « réservez le port 2000 sur le serveur et transmettez-le-moi au 3000 ».

    chisel client vps-ip:8080 R:2000:127.0.0.1:3000
    

    Désormais, le port 2000 sur le VPS (sur l’interface de bouclage) mène au client A.

    Étape 3 : Connexion du client B (consommateur)

    Le client B souhaite désormais accéder à cette ressource. Il se connecte au même VPS et redirige son port local 8080 vers le port 2000 du serveur.

    chisel client vps-ip:8080 8080:127.0.0.1:2000
    

    Prêt! Désormais, lorsque vous ouvrez http://localhost:8080 sur le client B, vous verrez le service s’exécuter sur le client A.

    Sécurité et nuances

    Chisel prend en charge l’authentification via l’indicateur --auth, qui est fortement recommandé lorsque vous travaillez via des serveurs publics. Vous pouvez également utiliser des certificats TLS pour chiffrer le trafic.

    Le principal avantage de cette approche est qu’elle ne nécessite pas de périphériques TUN/TAP ni de tables de routage complexes. Il s’agit d’un tunnel simplifié qui fait exactement une chose : lier les ports via une connexion WebSocket. Cela fonctionne même via des proxys d’entreprise si vous configurez Chisel pour qu’il fonctionne via le port 443.

    Sortie

    Chisel est un utilitaire pour des tâches réseau spécifiques. Lorsque vous devez transférer des ports entre des nœuds isolés sans configurer un VPN à part entière, une combinaison de tunnels aller et retour via un serveur relais s’avère être une solution tout à fait viable.

    Liens

    https://github.com/jpillora/chisel

  • Pourquoi ne puis-je pas corriger le bug ?

    Vous passez des heures à travailler sur le code, à examiner des hypothèses, à ajuster les conditions, mais le bug est toujours reproduit. Cela vous semble familier ? Cet état de frustration est souvent appelé « chasse aux fantômes ». Le programme semble vivre sa propre vie, ignorant vos corrections.

    L’une des raisons les plus courantes – et la plus ennuyeuse – de cette situation est la recherche d’une erreur au mauvais endroit dans l’application.

    Le piège des « faux symptômes »

    Lorsque nous constatons une erreur, notre attention est attirée sur l’endroit où elle a « tiré ». Mais dans les systèmes complexes, l’apparition d’un bug (plantage ou valeur incorrecte) n’est que la fin d’une longue chaîne d’événements. Lorsque vous essayez de réparer la fin, vous combattez les symptômes, pas la maladie.

    C’est là qu’intervient le concept d’organigramme.

    Comment ça marche en réalité

    Bien sûr, il n’est pas nécessaire de dessiner (dessiner) directement un organigramme sur papier à chaque fois, mais il est important de l’avoir en tête ou à portée de main comme guide architectural. Un organigramme vous permet de visualiser le fonctionnement d’une application sous forme d’arbre de résultats.

    Sans comprendre cette structure, le développeur tâtonne souvent dans le noir. Imaginez la situation : vous modifiez la logique dans une branche de condition, tandis que l’application (en raison d’un certain ensemble de paramètres) va dans une branche complètement différente à laquelle vous n’avez même pas pensé.


    Résultat : vous passez des heures sur une correction de code « parfaite » dans une partie de l’algorithme, ce qui, bien sûr, ne fait rien pour résoudre le problème dans une autre partie de l’algorithme où il échoue réellement.

    Algorithme pour vaincre un bug

    Pour arrêter de frapper à porte fermée, vous devez changer votre approche du diagnostic :

    • Recherchez l’état dans l’arborescence des résultats :Avant d’écrire du code, vous devez déterminer exactement le chemin emprunté par l’application. À quel moment la logique a-t-elle pris une mauvaise tournure ? Quel État spécifique (État) est à l’origine du problème ?
    • La reproduction représente 80 % de réussite : elle est généralement effectuée par des testeurs et des tests automatisés. Si le bug est « flottant », le développement est impliqué dans le processus de recherche conjointe des conditions.
    • Utilisez autant d’informations que possible : les journaux, la version du système d’exploitation, les paramètres de l’appareil, le type de connexion (Wi-Fi/5G) et même un opérateur de télécommunications spécifique sont importants pour la localisation.

    « Photographie » du moment de l’erreur

    Idéalement, pour résoudre ce problème, vous devez obtenir l’état complet de l’application au moment où le bug a été reproduit. Les journaux d’interaction sont également d’une importance cruciale : ils montrent non seulement le point final, mais également l’intégralité du parcours utilisateur (quelles actions ont précédé l’échec). Cela aide à comprendre comment recréer à nouveau un état similaire.

    Conseil futur : si vous rencontrez un cas complexe, ajoutez des informations de journalisation de débogage étendues à cette section de code au cas où la situation se reproduirait.

    Le problème des États « insaisissables » à l’ère de l’IA

    Dans les systèmes modernes utilisant le LLM (Large Language Models), le déterminisme classique (« une entrée, une sortie ») est souvent violé. Vous pouvez transmettre exactement les mêmes données d’entrée, mais obtenir un résultat différent.

    Cela se produit en raison du non-déterminisme des systèmes de production modernes :

    • Parallélisme GPU : les opérations en virgule flottante GPU ne sont pas toujours associatives. En raison de l’exécution parallèle des threads, l’ordre dans lequel les nombres sont ajoutés peut légèrement changer, ce qui peut affecter le résultat.
    • Température et limitation du GPU : la vitesse d’exécution et la répartition de la charge peuvent dépendre de l’état physique du matériel. Dans les modèles volumineux, ces différences microscopiques s’accumulent et peuvent conduire à la sélection d’un jeton différent en sortie.
    • Lot dynamique : dans le cloud, votre demande est combinée avec d’autres. Différentes tailles de lots modifient les mathématiques des calculs dans les noyaux.

    Dans de telles conditions, il devient presque impossible de reproduire « ce même état ». Seule une approche statistique des tests peut vous sauver la vie.

    En cas d’échec de la logique : problèmes de mémoire

    Si vous travaillez avec des langages « non sécurisés » (C ou C++), le bug peut survenir en raison d’une corruption de la mémoire.

    Ce sont les cas les plus graves : une erreur dans un module peut « écraser » les données dans un autre. Cela conduit à des pannes totalement inexplicables et isolées qui ne peuvent pas être retracées à l’aide de la logique d’application normale.

    Comment se protéger au niveau architectural ?

    Pour éviter de tels bugs « mystiques », vous devez utiliser des approches modernes :

    • Modèles de programmation multithread : une synchronisation claire élimine les conditions de concurrence.
    • Langages thread-safe : outils garantissant la sécurité de la mémoire au moment de la compilation :
      • Rust : le système de propriété élimine les erreurs de mémoire.
      • Concurrency Swift 6 :Contrôles rigoureux de l’isolation des données.
      • Erlang : Isolation complète des processus grâce au modèle d’acteur.

    Résumé

    Corriger un bug ne consiste pas à écrire du nouveau code, mais à comprendre comment fonctionne l’ancien. N’oubliez pas : vous pourriez perdre du temps à éditer une branche à laquelle la direction ne touche même pas. Enregistrez l’état du système, tenez compte du facteur de non-déterminisme de l’IA et choisissez des outils sûrs.

  • Pourquoi la documentation est votre meilleure amie

    (et comment créer des solutions qui continuent de fonctionner après les mises à jour)

    “Les applications ne peuvent utiliser que des API publiques et doivent s’exécuter sur le système d’exploitation actuellement disponible.” Directives d’examen des applications Apple

    Si vous avez déjà commencé à travailler avec un nouveau framework et que vous vous êtes dit : « Maintenant, je vais tout comprendre moi-même, lire la documentation est trop long », vous n’êtes certainement pas seul. Beaucoup d’entre nous ont un instinct naturel d’investigation : essayez d’abord, et ensuite seulement regardez les instructions. Et c’est tout à fait normal.

    Cependant, à ce stade, il peut être facile de se laisser emporter et de se retrouver dans une situation où le code fonctionne très bien, mais repose peut-être sur des fonctionnalités non évidentes du système.

    Pourquoi ne suffit-il parfois pas simplement de « le découvrir par soi-même » ?

    Les frameworks, en particulier ceux fermés, sont des systèmes complexes et multicouches. Ils cachent souvent une logique interne et des optimisations qui :

    * ne sont pas décrits dans la documentation publique ;
    * ne garantissent pas que le comportement sera maintenu à l’avenir ;
    * peut changer avec la sortie de nouvelles versions ;
    * peut contenir des fonctionnalités connues des développeurs qui n’ont pas encore été corrigées.

    Lorsque nous agissons intuitivement, nous risquons de construire une architecture sur des observations aléatoires plutôt que sur des règles documentées. Cela peut rendre le code plus sensible aux mises à jour.

    La documentation n’est pas une limitation, mais un support fiable

    Les développeurs de framework créent des manuels pour nous aider. En agissant dans la documentation, nous obtenons :

    * stabilité ;
    * soutien;
    * comportement prévisible du système.

    En dépassant ces limites, on prend des risques supplémentaires, et la maintenance d’un tel code devient plus difficile.

    Des expériences ? Certainement. Mais avec une compréhension des limites.
    La curiosité est une grande qualité à avoir chez un développeur. Explorer et essayer de nouvelles choses est absolument essentiel. Mais voici un petit souhait :

    La manière la plus confortable d’expérimenter est de s’appuyer sur les meilleures pratiques.

    La documentation est une carte qui montre quels chemins sont les plus sécurisés et pris en charge par les créateurs.

    Un point de vue extérieur : conseils d’experts

    Nous apprenons souvent de collègues expérimentés :

    * ils dispensent des cours utiles,
    * prendre la parole lors de conférences,
    * écrire de merveilleux livres et blogs,
    *partager leur vision unique.

    Beaucoup d’entre eux partagent des expériences vraiment précieuses. Mais il convient de le rappeler : si les approches de l’auteur contredisent la documentation officielle, elles peuvent s’avérer fragiles.

    De tels « modèles empiriques » :

    * travailler uniquement sur une version spécifique du framework ;
    * sensible aux mises à jour ;
    * peut se comporter de manière imprévisible dans des situations inhabituelles.

    Apprendre de la communauté est formidable et enrichissant. Mais tout conseil, même le plus fiable, doit toujours être soigneusement vérifié avec les manuels officiels.

    Un peu de SOLID

    Trois idées issues des principes SOLID complètent parfaitement cette approche :

    * Principe ouvert/fermé : essayez d’étendre le comportement via des API publiques et, si possible, ne dépendez pas d’une implémentation cachée.
    * Principe de substitution de Liskov : comptez sur le contrat et non sur la mise en œuvre spécifique. Sinon, des changements sous le capot peuvent entraîner des difficultés inattendues.
    * Inversion des dépendances : créez des dépendances sur des abstractions, pas sur des détails.

    En pratique, cela signifie que le fait d’être lié à des détails internes non documentés du cadre rend le système fragile.
    Sur la base des interfaces et des contrats publics, nous obtenons :

    * une meilleure isolation du code des modifications apportées au framework ;
    * facilité de test ;
    * prévisibilité et fiabilité de l’architecture.

    Et s’il y a un bug ?

    Il arrive aussi que tout soit fait selon les règles, mais que le résultat ne soit pas à la hauteur des attentes. Les cadres évoluent et ne sont pas toujours parfaits. Dans de tels cas :

    * Construisez un exemple minimal qui reproduit le problème.
    * Assurez-vous que seules les API documentées sont utilisées.
    * Envoyez un rapport de bug – l’équipe de développement appréciera certainement votre travail et essaiera de vous aider.

    Si l’exemple repose sur des solutions de contournement, il sera beaucoup plus difficile pour les développeurs de fournir une assistance.

    Comment tirer le meilleur parti du framework

    *Se référer à la documentation.
    * Suivez les guides et recommandations des auteurs.
    * Expérimentez dans le cadre de la fonctionnalité décrite.
    * Vérifiez les conseils d’Internet auprès de sources officielles.
    * Localiser les bugs en respectant les contrats-cadres.

    Conclusion

    Les frameworks sont des outils puissants avec leurs propres règles du jeu. En les oubliant, nous risquons de rendre notre code trop vulnérable. Mais nous voulons tous que les produits créés durent longtemps et ne nécessitent pas de corrections urgentes après chaque mise à jour mineure.

    Les manuels et la documentation constituent un excellent support qui permet de créer des solutions véritablement fiables.

    Sources

    https://developer.apple.com/app-store/review/guidelines/
    https://en.wikipedia.org/wiki/SOLID
    https://en.wikipedia.org/wiki/API
    https://en.wikipedia.org/wiki/RTFM

  • Création d’une application C++ SDL pour iOS sous Linux

    Dans cette note, je décrirai la procédure pour créer une application C++ SDL pour iOS sous Linux, signer une archive ipa sans abonnement Apple Developer payant et l’installer sur un appareil propre (iPad) utilisant macOS sans Jailbreak.

    Tout d’abord, installons la chaîne d’outils de build pour Linux :
    https://github.com/tpoechtrager/cctools-port

    La chaîne d’outils doit être téléchargée depuis le référentiel, puis suivez les instructions sur le site Web Godot Engine pour terminer l’installation :
    https://docs.godotengine.org/ru/latest/development/compiling/cross-compiling_for_ios_on_linux.html

    Pour le moment, vous devez télécharger Xcode dmg et copier le SDK à partir de là pour créer le port cctools. Cette étape est plus facile à réaliser sur macOS ; copiez simplement les fichiers SDK nécessaires à partir du Xcode installé. Après un assemblage réussi, le terminal contiendra le chemin d’accès à la chaîne d’outils du compilateur croisé.
    Ensuite, vous pouvez commencer à créer l’application SDL pour iOS. Ouvrons cmake et ajoutons les modifications nécessaires pour construire le code C++ :

    SET(CMAKE_SYSTEM_NAME Darwin)
    SET(CMAKE_C_COMPILER arm-apple-darwin11-clang)
    SET(CMAKE_CXX_COMPILER arm-apple-darwin11-clang++)
    SET(CMAKE_LINKER arm-apple-darwin11-ld)


    Vous pouvez maintenant compiler en utilisant cmake et make, mais n’oubliez pas d’ajouter $PATH à la chaîne d’outils du compilateur croisé :

    
    PATH=$PATH:~/Sources/cctools-port/usage_examples/ios_toolchain/target/bin


    Pour un lien correct avec les frameworks et SDL, nous les écrivons dans cmake, dépendances du jeu Space Jaguar par exemple :

    
    target_link_libraries(
    ${FSEGT_PROJECT_NAME}
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libclang_rt.ios.a
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libSDL2.a
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libSDL2_mixer.a
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libSDL2_image.a
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreServices.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/ImageIO.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/Metal.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/AVFoundation.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/GameController.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreMotion.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreGraphics.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/AudioToolbox.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreAudio.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/QuartzCore.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/OpenGLES.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/UIKit.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/Foundation.framework"
    )


    Dans mon cas, les bibliothèques SDL, SDL_Image, SDL_mixer sont compilées à l’avance dans Xcode sur macOS pour les liaisons statiques ; Frameworks copiés depuis Xcode. La bibliothèque libclang_rt.ios.a a également été ajoutée, qui inclut des appels d’exécution spécifiques à iOS, par exemple isOSVersionAtLeast. Inclus une macro pour travailler avec OpenGL ES, désactivant les fonctions non prises en charge dans la version mobile, similaire à Android.
    Après avoir résolu tous les problèmes de construction, vous devriez obtenir le binaire assemblé pour arm. Ensuite, envisageons d’exécuter le binaire assemblé sur un appareil sans Jailbreak.
    Sur macOS, installez Xcode, inscrivez-vous sur le portail Apple, sans payer pour le programme développeur. Ajouter un compte dans Xcode -> Préférences -> Comptes, créez une application vierge et construisez sur un appareil réel. Lors de l’assemblage, l’appareil sera ajouté à votre compte développeur gratuit. Après l’assemblage et le lancement, vous devez créer l’archive ; pour ce faire, sélectionnez Appareil et produit iOS génériques -> Archive. Une fois l’archive créée, extrayez-en les fichiersembedded.mobileprovision et PkgInfo. Depuis le journal de build vers l’appareil, recherchez la ligne de codedesign avec la clé de signature correcte, le chemin d’accès au fichier de droits avec l’extension app.xcent, copiez-le.
    Copiez le dossier .app de l’archive, remplacez le binaire dans l’archive par un autre compilé par un compilateur croisé sous Linux (par exemple, SpaceJaguar.app/SpaceJaguar), puis ajoutez les ressources nécessaires au .app, vérifiez l’intégrité des fichiers PkgInfo et Embedded.mobileprovision dans le .app à partir de l’archive, copiez à nouveau si nécessaire. Nous re-signons le .app à l’aide de la commande codesign – le codedesign nécessite une clé d’entrée pour la signature, le chemin d’accès au fichier de droits (peut être renommé avec une extension .plist)
    Après la re-signature, créez un dossier Payload, déplacez-y le dossier avec l’extension .app, créez une archive zip avec Payload à la racine, renommez l’archive avec l’extension .ipa. Après cela, dans Xcode, ouvrez la liste des appareils et faites glisser le nouvel ipa vers la liste des applications de l’appareil ; L’installation via Apple Configurator 2 ne fonctionne pas pour cette méthode. Si la re-signature est effectuée correctement, alors l’application avec le nouveau binaire sera installée sur un appareil iOS (par exemple, iPad) avec un certificat de 7 jours, cela suffit pour la période de test.

    Sources

    https://github.com/tpoechtrager/cctools-port

    https://docs.godotengine.org/ru/latest/development/compiling/cross-compiling_for_ios_on_linux.html

    https://jonnyzzz.com/blog/2018/06/13/link-error-3/

    https://stackoverflow.com/questions/6896029/re-sign-ipa-iphone

    https://developer.apple.com/library/archive/documentation/Security/Conceptual/CodeSigningGuide/Procedures/Procedures.html

  • Construire pour Windows sous Ubuntu MinGW CMake

    Dans cet article, je décrirai le processus de création de bibliothèques et d’applications pour Windows à l’aide de la chaîne d’outils MinGW32 sur Ubuntu.
    Installez wine, mingw :

    sudo apt-get install wine mingw-w64
    

    Après cela, vous pouvez déjà créer des applications C/C++ pour Windows :

    # C
    i686-w64-mingw32-gcc helloWorld.c -o helloWorld32.exe      # 32-bit
    x86_64-w64-mingw32-gcc helloWorld.c -o helloWorld64.exe    # 64-bit
     
    # C++
    i686-w64-mingw32-g++ helloWorld.cc -o helloWorld32.exe     # 32-bit
    x86_64-w64-mingw32-g++ helloWorld.cc -o helloWorld64.exe   # 64-bit
    

    L’exe collecté peut être vérifié à l’aide de wine.
    Examinons ensuite les modifications apportées à la build CMake, le fichier CMakeLists.txt, en ajoutant des éléments spécifiques à MinGW au fichier de build :

    if (MINGW32)
    set(CMAKE_SYSTEM_NAME Windows)
    SET(CMAKE_C_COMPILER i686-w64-mingw32-gcc)
    SET(CMAKE_CXX_COMPILER i686-w64-mingw32-g++)
    SET(CMAKE_RC_COMPILER i686-w64-mingw32-windres)
    set(CMAKE_RANLIB i686-w64-mingw32-ranlib)
    endif()
    
    // для сборки shared dll
    elseif (MINGW32)
    add_library(FlameSteelEngineGameToolkit.dll SHARED ${SOURCE_FILES})
    else()
    
    // обязательно линкуем со всеми зависимостями
    if (MINGW32)
    target_link_libraries(
                            FlameSteelEngineGameToolkit.dll 
                            -static-libgcc
                            -static-libstdc++
                            SDL2 
                            SDL2_mixer 
                            /home/demensdeum/Sources/cube-art-project-bootstrap/FlameSteelFramework/FlameSteelCore/FlameSteelCore.dll
                            /home/demensdeum/Sources/cube-art-project-bootstrap/FlameSteelFramework/FlameSteelBattleHorn/FlameSteelBattleHorn.dll
                            /home/demensdeum/Sources/cube-art-project-bootstrap/FlameSteelFramework/FlameSteelCommonTraits/FlameSteelCommonTraits.dll)
    
    set_target_properties(FlameSteelEngineGameToolkit.dll PROPERTIES
            PREFIX ""
            SUFFIX ""
            LINK_FLAGS "-Wl,--add-stdcall-alias"
            POSITION_INDEPENDENT_CODE 0 # this is to avoid MinGW warning; 
            # MinGW generates position-independent-code for DLL by default
    )
    else()
    

    Nous collectons :

    cmake -DMINGW32=1 .
    make
    

    La sortie sera une DLL ou un exe, selon ce que vous collectez. Pour un exemple fonctionnel, vous pouvez consulter le référentiel du nouveau Cube-Art-Project et ses bibliothèques :
    https://gitlab.com/demensdeum/cube-art-project

    https://gitlab.com/demensdeum/FlameSteelEngineGameToolkitFSGL

    https://gitlab.com/demensdeum/cube-art-project-bootstrap

    Sources
    https://arrayfire.com/cross-compile-to-windows-from-linux/

  • Création d’applications macOS pour Ubuntu OSXCross CMake

    Dans cet article, je décrirai la création d’applications C++ multiplateformes pour macOS sur une machine de build Ubuntu à l’aide de CMake et osxcross.
    Tout d’abord, installez la chaîne d’outils osxcross :
    https://github.com/tpoechtrager/osxcross
    L’installation se déroule en 3 étapes, téléchargement des dépendances :

    cd tools
    ./get_dependencies.sh
    

    Téléchargez XCode.xip depuis le site officiel d’Apple, puis téléchargez le SDK depuis XCode :

    ./gen_sdk_package_pbzx.sh /media/demensdeum/2CE62A79E62A4404/LinuxSupportStorage/xcode111.xip
    

    J’espère que vous avez lu le contrat de licence XCode lors de la dernière étape ? Ensuite, créez la chaîne d’outils avec le préfixe requis :

    INSTALLPREFIX=/home/demensdeum/Apps/osxcross ./build.sh 
    

    Vous pouvez maintenant utiliser osxcross à partir du répertoire de préfixes de l’étape précédente. Ajoutons une nouvelle macro de build pour CMake et écrivons tout ce qui est nécessaire :

    if (OSXCROSS)
    SET(CMAKE_SYSTEM_NAME Darwin)
    SET(CMAKE_C_COMPILER o64-clang)
    SET(CMAKE_CXX_COMPILER o64-clang++)
    SET(CMAKE_C_COMPILER_AR x86_64-apple-darwin19-ar)
    SET(CMAKE_CXX_COMPILER_AR x86_64-apple-darwin19-ar)
    SET(CMAKE_LINKER x86_64-apple-darwin19-ld)
    SET(ENV{OSXCROSS_MP_INC} 1)
    endif()
    

    Les liens dynamiques n’ont pas réussi pour moi, nous exportons donc les bibliothèques de manière statique :

    if (OSXCROSS)
    add_library(FlameSteelCore STATIC ${SOURCE_FILES})
    else()
    

    Ensuite, vous serez peut-être confronté au fait que vous ne disposez pas des bibliothèques nécessaires pour osxcross, j’ai rencontré cela lors de l’utilisation de SDL2. osxcross prend en charge les packages de bibliothèques prêts à l’emploi – macports. Par exemple, en installant SDL2-mixer :

    osxcross-macports -v install libsdl2_mixer
    

    Après cela, vous pouvez commencer à créer des bibliothèques/applications comme d’habitude dans le lien cmake-make, n’oubliez pas de spécifier des liens statiques de bibliothèques si nécessaire.

    Assemblage manuel des bibliothèques

    Actuellement, j’ai rencontré le problème d’un archivage incorrect des bibliothèques lors de la liaison statique ; lors de la construction de l’application finale, je reçois l’erreur :

    file was built for archive which is not the architecture being linked (x86_64)
    

    Très similaire à ce ticket, nous avons réussi à implémenter une solution de contournement permettant à la construction de se terminer correctement. Décompressons la bibliothèque statique et recréons-la à l’aide de l’archiveur osxcross :

    ar x ../libFlameSteelCore.a
    rm ../libFlameSteelCore.a
    x86_64-apple-darwin19-ar rcs ../libFlameSteelCore.a *.o
    

    De plus, l’un des problèmes que je considère personnellement est le manque de possibilité d’exécuter des applications macOS directement sur Ubuntu (au moins avec une partie des fonctionnalités). Bien sûr, il existe un projet darling, mais le support laisse encore beaucoup à désirer.

    Sources

    https://github.com/tpoechtrager/osxcross

  • Génération d’images locales : modèle ComfyUI et FLUX

    De nos jours, vous n’avez plus besoin de recourir aux services cloud : vous pouvez générer des images de haute qualité entièrement sur votre propre matériel. Dans cet article, je vais décrire comment exécuter le modèle FLUX moderne localement sur votre ordinateur à l’aide de ComfyUI.

    ComfyUI utilise une architecture basée sur les nœuds. Cela vous permet de :
    – Contrôlez totalement chaque étape de la génération.
    – Partagez facilement des « workflows » prêts à l’emploi

    FLUX est un grand modèle, la configuration matérielle requise est donc supérieure à celle de SD 1.5 ou SDXL :
    – Carte vidéo (GPU) : Nvidia RTX avec 12 Go de VRAM ou plus (pour un travail confortable). Si vous disposez de 8 Go ou moins, vous devrez utiliser les versions quantifiées (GGUF ou NF4).
    – Mémoire vive (RAM) : minimum 16 Go (de préférence 32 Go et plus).
    – Espace disque : environ 20 à 50 Go pour les modèles et les composants.

    Le moyen le plus simple de démarrer FLUX est d’utiliser un modèle prêt à l’emploi. Recherchez simplement le texte de flux à image dans la fenêtre des flux de travail et installez-le.

    Écrivez une invite en anglais dans le nœud « Text to Image (Flux.1 Dev) », sélectionnez la résolution (FLUX fonctionne bien avec 1024 x 1024 et même plus) et appuyez sur RUN.

    La première génération peut prendre du temps car les modèles seront chargés dans la mémoire de la carte vidéo.

    https://github.com/comfyanonymous/ComfyUI

  • Codage Vibe local : LM Studio, VS Code et Continuer

    Si vous souhaitiez utiliser des réseaux de neurones pour vous aider à écrire du code (appelé codage Vibe) et que vous disposez d’un ordinateur assez puissant, par exemple avec une carte vidéo Nvidia RTX, alors vous pouvez déployer l’ensemble de l’environnement absolument gratuitement sur votre machine. Cela résout les problèmes liés aux abonnements payants et vous permet de travailler en toute sécurité avec des projets sous NDA, puisque votre code n’est envoyé nulle part. Dans cet article, je vais décrire comment assembler un bundle local de LM Studio, VS Code et l’extension Continue.

    Outils pour le codage Vibe local

    Pour un travail confortable, nous avons besoin de trois composants principaux :
    – LM Studio : une application pratique pour télécharger et exécuter des LLM locaux. Il prend en charge toute la complexité du travail avec les modèles GGUF et met en place un serveur local compatible avec l’API OpenAI.
    – VS Code : un éditeur de code populaire et familier.
    – Continuer : extension pour VS Code qui intègre les réseaux de neurones directement dans l’environnement de travail. Vous permet de discuter, de mettre en évidence le code pour la refactorisation et de prendre en charge la saisie semi-automatique.

    Exigences matérielles

    Les modèles de langage local sont gourmands en mémoire :
    – Carte vidéo (GPU) : Nvidia avec 8 Go de VRAM ou plus (pour un travail confortable avec des modèles avec 7 à 8 milliards de paramètres). Les modèles plus lourds nécessiteront 16 Go de VRAM.
    – Espace disque : environ 500 Go pour stocker les différents modèles téléchargés.

    Configurer le lien

    Le processus de configuration est assez simple et ne nécessite pas de manipulations complexes dans le terminal :
    1. Téléchargez et installez LM Studio. Utilisez la recherche intégrée pour trouver un modèle léger tel que Qwen Coder ou gemma3:12b.
    2. Dans LM Studio, accédez à l’onglet Serveur local et cliquez sur Démarrer le serveur. Par défaut, il démarrera sur `http://localhost:1234/v1`.
    3. Ouvrez VS Code et installez l’extension Continuer à partir du magasin de plugins.
    4. Ouvrez le fichier de configuration Continue et ajoutez un nouveau modèle, en spécifiant le fournisseur `openai` et l’adresse de votre serveur local depuis LM Studio.

    Vous pouvez ensuite communiquer avec votre LLM local directement dans la barre latérale Continuer, poser des questions sur votre code et générer de nouveaux composants.

    Pourquoi ça marche ?

    Comme je l’ai écrit plus tôt, les LLM réussissent mieux avec une structure plate et du code WET (Write Everything Twice). Les modèles de paramètres locaux peuvent être inférieurs aux géants comme GPT-4 lorsqu’il s’agit de concevoir des architectures complexes, mais ils sont plus que capables de générer du code passe-partout, de refactoriser des fonctions simples et de réaliser un prototypage rapide.

    De plus, grâce au codage Vibe local, votre code ne quitte jamais la machine. Cela rend cette combinaison idéale pour le développement d’entreprise et le travail avec des données sensibles.

    Sortie

    Les réseaux de neurones locaux ne sont pas capables de remplacer complètement un programmeur ou de concevoir un système complexe. Cependant, la combinaison de LM Studio + VS Code + Continue offre une indépendance par rapport aux services cloud et préserve la confidentialité. Il s’agit d’un outil auxiliaire entièrement fonctionnel pour les tâches de routine, si vous êtes prêt à supporter les limitations des petits modèles et à contrôler indépendamment l’architecture du projet.

    Liens

    https://code.visualstudio.com/
    https://lmstudio.ai/
    https://continue.dev/

    Sources

    https://youtu.be/IqqCwhG46jY
    https://www.youtube.com/watch?v=7AImkA96mE8

  • Génération vidéo locale : ComfyUI et LTX-2.3

    Auparavant, créer des vidéos à l’aide de réseaux de neurones était l’apanage des services cloud comme Runway ou Luma. Aujourd’hui, si vous disposez d’une carte graphique Nvidia moderne, vous pouvez générer des vidéos de haute qualité directement sur votre ordinateur. Dans cet article, je vais vous expliquer comment configurer la génération vidéo locale à l’aide de ComfyUI et du modèle efficace LTX-2.3.

    Outils de génération de vidéos

    Pour le travail, nous aurons besoin de :
    – ComfyUI : une interface puissante avec une architecture basée sur des nœuds qui vous permet de personnaliser de manière flexible le processus de génération.
    – LTX-2.3 : Un modèle moderne de Lightricks, optimisé pour créer des vidéos fluides et détaillées avec des besoins en mémoire vidéo relativement modérés.

    Exigences matérielles

    Générer une vidéo est un processus beaucoup plus gourmand en ressources que travailler avec des images :
    – Carte vidéo (GPU) : Nvidia RTX avec 8 Go de VRAM est le minimum requis pour une résolution de 768 x 512. Pour un fonctionnement confortable et des résolutions plus élevées, il est hautement souhaitable de disposer de 16 à 24 Go de VRAM.
    – Mémoire vive (RAM) : minimum 32 Go. Les modèles vidéo et les VAE prennent beaucoup de place lors du téléchargement.
    – Espace disque : environ 500 Go pour le modèle lui-même et les composants associés.

    Configuration et lancement

    Le processus de lancement de LTX-2.3 dans ComfyUI est le suivant :
    1. Mettre à jour ComfyUI : Le modèle est relativement nouveau, alors assurez-vous d’avoir installé la dernière version de l’interface.
    2. Installer le workflow : Le moyen le plus simple consiste à trouver un modèle JSON prêt à l’emploi pour LTX Video. Le modèle nécessite des nœuds spécifiques pour fonctionner avec l’espace latent vidéo.
    3. Invite et paramètres : Saisissez une description de la scène en anglais. Notez que le LTX-2.3 comprend bien le mouvement (par exemple « la caméra tourne autour », « mouvement rapide »).

    Pourquoi choisir LTX-2.3 ?

    LTX-2.3 est remarquable car il fournit des résultats comparables aux services cloud propriétaires, mais s’exécute localement. Cela vous donne :
    – Confidentialité totale : vos invites et vidéos générées ne sont pas transmises aux serveurs d’autres personnes.
    – Contrôle : vous pouvez expérimenter la fréquence d’images (FPS), la résolution et la force de l’invite sans avoir à payer pour chaque tentative.

    La génération vidéo locale est toujours en développement actif et LTX-2.3 constitue une excellente entrée dans le monde du « home Hollywood ».

    Liens

    https://github.com/comfyanonymous/ComfyUI
    https://huggingface.co/Lightricks/LTX-Video

  • Génération de musique locale : modèle ComfyUI et ACE-Step-1.5

    De nos jours, vous n’avez plus besoin de recourir aux services cloud pour créer du contenu : vous pouvez générer de la musique de haute qualité entièrement sur votre propre matériel. Dans cet article, je vais décrire comment exécuter le modèle ACE-Step-1.5 moderne localement sur votre ordinateur à l’aide de ComfyUI.

    ComfyUI utilise une architecture basée sur les nœuds. Cela vous permet de :
    – Contrôlez totalement chaque étape de la génération audio.
    – Partagez facilement des « workflows » prêts à l’emploi.

    ACE-Step-1.5 est un modèle avancé de génération de musique qui nécessite des ressources informatiques importantes. Les exigences matérielles sont supérieures à celles de nombreux synthétiseurs simples :
    – Carte vidéo (GPU) : Nvidia RTX avec 8 Go de VRAM ou plus (12 Go+ recommandés) pour un travail confortable et de haute qualité.
    – Mémoire vive (RAM) : minimum 16 Go (de préférence 32 Go et plus).
    – Processeur (CPU) : Processeur multicœur moderne avec une bonne prise en charge de l’informatique AVX/CUDA.
    – Espace disque : environ 20 à 50 Go pour les modèles et les composants.

    Le moyen le plus simple d’exécuter ACE-Step-1.5 consiste à utiliser un modèle de génération audio prêt à l’emploi. Recherchez simplement le texte musical en audio dans la fenêtre des flux de travail et installez-le.

    Écrivez une invite décrivant le genre et l’ambiance (par exemple, « piste synthwave inspirante avec des basses lourdes ») dans le nœud « Saisie d’invite ». Précisez la durée souhaitée et appuyez sur RUN.
    La première génération peut prendre du temps, car les modèles seront chargés dans la mémoire de la carte vidéo et traiteront des modèles acoustiques complexes.

    https://github.com/comfyanonymous/ComfyUI
    https://www.youtube.com/watch?v=UAlLD5fS7-c

  • Réseaux de neurones locaux utilisant ollama

    Si vous souhaitez lancer quelque chose comme ChatGPT et que vous disposez d’un ordinateur assez puissant, par exemple avec une carte vidéo Nvidia RTX, vous pouvez alors exécuter le projet ollama, qui vous permettra d’utiliser l’un des modèles LLM prêts à l’emploi sur votre machine locale, absolument gratuitement. ollama offre la possibilité de communiquer avec les modèles LLM, à la manière de ChatGPT ; également dans la dernière version, la possibilité de lire des images et de formater les données de sortie au format json a été annoncée.

    J’ai également exécuté le projet lui-même sur un MacBook équipé d’un processeur Apple M2 et je sais que les derniers modèles de cartes vidéo d’AMD sont pris en charge.

    Pour installer sur macOS, rendez-vous sur le site ollama :
    https://ollama.com/download/mac

    Cliquez sur “Télécharger pour macOS”, vous téléchargerez une archive du formulaire ollama-darwin.zip, à l’intérieur de l’archive il y aura Ollama.app qui doit être copié dans “Applications”. Après cela, lancez Ollama.app, le processus d’installation se produira probablement au premier lancement. Après cela, dans le plateau, vous avez vu l’icône ollama, le plateau se trouve en haut à droite à côté de l’horloge.

    Après cela, lancez un terminal macOS standard et tapez la commande pour télécharger, installer et exécuter n’importe quel modèle ollama. Une liste des modèles disponibles, leurs descriptions et leurs caractéristiques sont disponibles sur le site ollama :
    https://ollama.com/search

    Choisissez le modèle avec le moins de paramètres s’il ne rentre pas dans votre carte vidéo au lancement.

    Par exemple, la commande pour lancer le lama3.1:latest model :

    ollama run llama3.1:latest
    

    L’installation pour Windows et Linux est généralement similaire, dans un cas, il y aura un programme d’installation ollama et travaillerez ensuite avec lui via Powershell.
    Pour Linux, l’installation se fait à l’aide d’un script, mais je recommande d’utiliser la version de votre gestionnaire de packages spécifique. Sous Linux, ollama peut également être lancé via un terminal bash classique.

    Sources
    https://www.youtube.com/watch?v=Wjrdr0NU4Sk
    https://ollama.com

  • Stabilisation vidéo à l’aide de ffmpeg

    Si vous souhaitez stabiliser les vidéos et supprimer le bougé de l’appareil photo, l’outil « ffmpeg » offre une solution puissante. Grâce aux filtres intégrés « vidstabdetect » et « vidstabtransform », vous pouvez obtenir des résultats professionnels sans utiliser d’éditeurs vidéo complexes.

    Préparer le travail

    Avant de commencer, assurez-vous que votre `ffmpeg` prend en charge la bibliothèque `vidstab`. Sous Linux, vous pouvez vérifier cela avec la commande :

    bash  
    ffmpeg -filters | grep vidstab  
    

    Si la bibliothèque n’est pas installée, vous pouvez l’ajouter :

    sudo apt install ffmpeg libvidstab-dev  
    

    Installation pour macOS via Brew :

    brew install libvidstab
    brew install ffmpeg
    

    Passons maintenant au processus.

    Étape 1 : Analyse du mouvement

    Vous devez d’abord analyser le mouvement de la vidéo et créer un fichier avec les paramètres de stabilisation.

    ffmpeg -i input.mp4 -vf vidstabdetect=shakiness=10:accuracy=15 transfile=transforms.trf -f null -  
    

    Paramètres :

    tremblement : niveau de tremblement de la vidéo (par défaut 5, peut être augmenté à 10 pour les cas plus complexes).
    précision : précision de l’analyse (par défaut 15).
    transfile : Nom du fichier pour enregistrer les paramètres de mouvement.

    Étape 2 : Appliquer la stabilisation

    Vous pouvez maintenant appliquer la stabilisation à l’aide du fichier de transformation :

    ffmpeg -i input.mp4 -vf vidstabtransform=input=transforms.trf:zoom=5 output.mp4
    

    Paramètres :

    input : pointe vers le fichier avec les paramètres de transformation (créé lors de la première étape).
    zoom : facteur de zoom pour supprimer les bords noirs (par exemple 5 – zoom automatique jusqu’à ce que les artefacts soient supprimés).

  • Machines informatiques de Turing

    Je présente à votre attention une traduction des premières pages de l’article d’Alan Turing « SUR LES NUMÉROS COMPUTABLES AVEC UNE APPLICATION AU PROBLÈME DE RÉSOLUTION » de 1936. Les premiers chapitres contiennent une description des ordinateurs, qui sont devenus plus tard la base de l’informatique moderne.

    La traduction complète de l’article et l’explication peuvent être lues dans le livre du vulgarisateur américain Charles Petzold, intitulé « Reading Turing : A Journey through Turing’s Historical Article on Computability and Turing Machines » (ISBN 978-5-97060-231-7, 978-0-470-22905-7).

    Article original :
    https://www.astro.puc.cl/~rparra/tools/PAPERS/turing_1936.pdf

    SUR LES NOMBRES CALCULABLES AVEC APPLICATION AU PROBLEME DE RESOLUTION

    A. M. TURING

    [Reçu le 28 mai 1936 – Lu le 12 novembre 1936]

    Les nombres « calculables » peuvent être brièvement décrits comme des nombres réels dont les expressions sous forme de fractions décimales sont calculables d’un nombre fini de façons. Bien qu’à première vue cet article traite les nombres comme calculables, il est presque aussi simple de définir et d’explorer les fonctions calculables d’une variable entière, d’une variable réelle, d’une variable calculable, de prédicats calculables, etc. Cependant, les problèmes fondamentaux associés à ces objets calculables sont les mêmes dans chaque cas. Pour une considération détaillée, j’ai choisi les nombres calculables comme objet calculable car la méthode pour les considérer est la moins lourde. J’espère décrire bientôt la relation entre les nombres calculables et les fonctions calculables, etc. Parallèlement, des recherches seront menées dans le domaine de la théorie des fonctions d’une variable réelle exprimée en termes de nombres calculables. Selon ma définition, un nombre réel est calculable si sa représentation décimale peut être écrite par une machine.

    Aux paragraphes 9 et 10, je donne quelques arguments pour montrer que les nombres calculables incluent tous les nombres qui sont naturellement considérés comme calculables. En particulier, je montre que certaines grandes classes de nombres sont calculables. Ils comprennent, par exemple, les parties réelles de tous les nombres algébriques, les parties réelles des zéros des fonctions de Bessel, les nombres π, e et autres. Cependant, les nombres calculables n’incluent pas tous les nombres définissables, comme en témoigne l’exemple suivant d’un nombre définissable qui n’est pas calculable.

    Bien que la classe des nombres calculables soit très vaste et similaire à bien des égards à la classe des nombres réels, elle reste néanmoins dénombrable. Au §8, je considère certains arguments qui semblent soutenir le contraire. Lorsqu’un de ces arguments est correctement appliqué, on en tire des conclusions qui, à première vue, sont similaires à celles de Gödel*. Ces résultats ont des applications extrêmement importantes. En particulier, comme indiqué ci-dessous (§11), le problème de résolution ne peut pas avoir de solution.

    Dans un article récent, Alonzo Church a introduit l’idée de « calculabilité efficace », qui est équivalente à mon idée de « calculabilité » mais a une définition complètement différente. Church arrive également à des conclusions similaires concernant le problème de la résolution. La preuve de l’équivalence de « calculabilité » et « effectivement calculable » est présentée en annexe de cet article.

    1. Ordinateurs

    Nous avons déjà dit que les nombres calculables sont les nombres dont les décimales sont dénombrables par des moyens finis. Une définition plus claire est nécessaire ici. Cet article ne tentera pas réellement de justifier les définitions données ici avant d’arriver au §9. Pour l’instant, je noterai simplement que la justification (logique) (de cela) est que la mémoire humaine est, par nécessité, limitée.

    Comparons une personne en train de calculer un nombre réel avec une machine capable de remplir seulement un nombre fini de conditions q1, q2, …, qR ; Appelons ces conditions « m-configurations ». Cette machine (c’est-à-dire ainsi définie) est équipée d’un « ruban » (analogue au papier). Cette courroie traversant la machine est divisée en tronçons. Appelons-les « carrés ». Chacun de ces carrés peut contenir une sorte de « symbole ». À tout moment, il n’existe qu’un seul carré de ce type, disons le ième, contenant le symbole qui se trouve « dans cette machine ». Appelons un tel carré un « symbole numérisé ». Un “caractère scanné” est le seul caractère dont la machine est, pour ainsi dire, “directement consciente”. Cependant, en modifiant sa configuration m, la machine peut effectivement mémoriser certains des caractères qu’elle a “vus” (numérisés) précédemment. Le comportement possible de la machine à tout moment est déterminé par la configuration m qn et le symbole scanné***. Appelons cette paire de symboles qn, « configuration ». La configuration ainsi désignée détermine le comportement possible d’une machine donnée. Dans certaines de ces configurations dans lesquelles le carré scanné est vide (c’est-à-dire ne contient pas de caractère), la machine écrit un nouveau caractère sur le carré scanné, et dans d’autres de ces configurations, elle efface le caractère scanné. Cette machine est également capable de se déplacer pour scanner une autre case, mais de cette manière elle ne peut se déplacer que vers la case adjacente à droite ou à gauche. En plus de chacune de ces opérations, la configuration m de la machine peut être modifiée. Dans ce cas, certains des caractères écrits formeront une séquence de chiffres, qui constitue la partie décimale du nombre réel calculé. Le reste ne sera que des notes inexactes destinées à « aider la mémoire ». Dans ce cas, seules les marques inexactes mentionnées ci-dessus pourront être effacées.

    J’affirme que les opérations considérées ici incluent toutes les opérations utilisées dans le calcul. La justification de cette affirmation est plus facile à comprendre pour le lecteur qui a une compréhension de la théorie des machines. Par conséquent, dans la section suivante, je continuerai à développer la théorie en question, basée sur une compréhension de la signification des termes « machine », « bande », « scanné », etc.

    *Gödel « Sur les phrases formellement indécidables des Principia Mathematics (publié par Whitehead et Russell en 1910, 1912 et 1913) et des systèmes associés, partie I », Journal of Mathematics. Physique, bulletin mensuel en allemand n° 38 (pour 1931, pp. 173-198.
    ** Alonzo Church, « Un problème indécidable dans la théorie élémentaire des nombres », American J. of Math., n° 58 (1936), pp. 345-363.
    *** Alonzo Church, « Une note sur le problème de la résolution », J. of Symbolic Logic, n° 1 (1936), pp. 40-41