Category: Notes

  • Instalando Asahi Linux em um MacBook com processador M2

    Em um Mac com processador Apple Silicon, você não pode instalar o Linux da maneira usual: inicializar a partir de uma unidade flash é impossível aqui e o bootloader é assinado pela Apple. O projeto Asahi Linux se comprometeu a contornar isso – seus participantes usaram engenharia reversa para fazer o hardware M1 e M2 funcionar no Linux normal. Agora, a principal distribuição do projeto é o Fedora Asahi Remix, e funciona de forma bastante confiável no M2. Neste post irei descrever o passo a passo da instalação.
    O que é Asahi Linux

    O projeto começou em 2020, quando a Apple mudou para chips próprios e com eles veio um esquema de boot fechado: o aparelho roda apenas código assinado pela Apple. Os participantes do Asahi Linux escreveram seu bootloader m1n1, sobre o qual escreveram o U-Boot e um ambiente UEFI. Em seguida, o sistema ARM64 mais comum é carregado, mas com um kernel linux-asahi, ao qual são adicionados drivers para hardware não padrão da Apple: GPU, vídeo, som, unidades de câmera.

    Na prática, é assim: você executa o instalador do macOS, ele particiona o disco, instala a cadeia de boot e o sistema. O macOS permanece no lugar, você obtém inicialização dupla e escolhe seu sistema ao ligá-lo.

    Requisitos

    • Mac no chip M2 – MacBook Air, MacBook Pro 13″, bem como 14″ e 16″ com M2 Pro e M2 Max. Carros M1 também são suportados.
    • MacOS atual. O instalador requer a versão mais recente do sistema, portanto, atualize antes de começar.
    • Espaço livre. Mínimo de cerca de 30 GB, confortável – 100 GB ou mais. O espaço é cortado do contêiner APFS e não retornará sozinho.
    • Senha de administrador do macOS. Você precisará dela durante o particionamento e ao inicializar no modo de recuperação pela primeira vez.
    • Backup. O particionamento de disco é uma operação que é melhor iniciada com um novo backup.

    Etapa 1. Backup e atualização

    Faça uma cópia via Time Machine ou qualquer outro método. Atualize o macOS para a versão mais recente disponível e reinicie. Se o FileVault estiver ativado, a senha ainda será necessária no estágio de inicialização no modo de recuperação – o instalador precisa desbloquear a unidade.

    Etapa 2. Inicie o instalador

    Abra o Terminal no macOS e execute um comando:

    Este é o instalador oficial do projeto. Ele fará o download sozinho, verificará o modelo do seu Mac e se oferecerá para escolher uma distribuição. Também existe uma opção diretamente para o Fedora:

    A primeira opção é preferível: mostra quais sistemas estão disponíveis no momento e também oferece a opção de desktop.

    Etapa 3. Partição do disco

    O instalador solicitará a senha do administrador e mostrará o layout atual. Então o diálogo fica assim:

    • Pressione r para redimensionar a partição do macOS.
    • Insira o tamanho da nova partição Linux. Pode ser em gigabytes, como uma porcentagem do disco ou você pode escrever min – então o menor pedaço possível será cortado.
    • Confirme a marcação com a letra y. Esta etapa é a mais longa: o sistema move fisicamente os dados no contêiner APFS; em um disco grande, isso leva vários minutos.
    • Pressione f para apontar o instalador para a partição livre recém-criada.

    É importante entender o que está acontecendo: o Linux não está instalado dentro do APFS, mas em uma partição separada próxima a ele. É por isso que o macOS permanece intacto e a reversão se resume à exclusão desta seção.

    Etapa 4. Selecionando distribuição e desktop

    A seguir, o instalador oferecerá o sistema e o ambiente de desktop. O Fedora Asahi Remix vem com o KDE Plasma por padrão – é a opção principal que recebe atualizações primeiro. Uma alternativa é o GNOME, que tem uma aparência mais próxima do macOS. Também existe uma imagem mínima se você não precisar de um ambiente gráfico.

    Etapa 5. Primeira inicialização em modo de recuperação

    Após o particionamento, o instalador solicitará que você continue e o Mac será desligado. Aí vem a parte mais incomum:

    • Aguarde pelo menos 25 segundos – este é o requisito da Apple para entrar no modo de recuperação.
    • Mantenha pressionado o botão liga/desliga até que as opções de inicialização apareçam.
    • Selecione o volume de instalação e digite sua senha do macOS.

    Nesta etapa, a cadeia de boot é instalada na partição de serviço: ambiente m1n1, U-Boot e UEFI. Em seguida, a máquina será reinicializada novamente – mantenha pressionado o botão liga / desliga novamente e selecione um novo volume, desta vez para entrar no sistema. Haverá várias reinicializações, cada uma exigindo seleção manual: por padrão, o Mac continua a carregar o macOS.

    Etapa 6. Instalando o sistema

    Em seguida, o assistente de configuração inicial é iniciado: nome do sistema, usuário, senha, fuso horário, layout do teclado. Depois disso, começa a instalação propriamente dita, e já vem da Internet – você vai precisar de uma conexão estável, e com o tempo leva de quinze minutos a meia hora.

    Quando a instalação for concluída, reinicie e selecione Linux no menu de inicialização. Ao fazer login pela primeira vez, o sistema solicitará que você conclua a configuração e a atualização.

    O que funciona e o que não funciona

    Antes da instalação, você deve avaliar com sobriedade o que perderá. Nos laptops M2 a situação é a seguinte:

    Funciona:

    • Wi-Fi e Bluetooth – sem restrições.
    • Tela e gráficos integrados – acelerados por hardware, incluindo OpenGL e Vulkan.
    • Webcam, microfone e alto-falantes no MacBook Air e MacBook Pro.
    • Modo de suspensão – funciona normalmente.
    • Decodificação de vídeo por hardware – os players não carregam o processador.
    • Portas USB, incluindo USB 2 e USB 3 por meio de conectores Thunderbolt.

    Não funciona ou funciona parcialmente:

    • Touch ID. A impressão digital não está disponível no Linux – faça login com senha.
    • Thunderbolt (USB4). Status – em desenvolvimento. Infelizmente, os dispositivos que exigem especificamente Thunderbolt não funcionarão.
    • Monitor externo via USB-C. O DisplayPort Alt Mode também está em operação. Os laptops M2 não possuem uma porta HDMI, portanto você não pode conectar uma tela externa. Os modelos com M2 Pro e M2 Max possuem HDMI e funciona. Uma solução alternativa para USB-C está na seção principal do pó de fada abaixo.
    • A codificação de vídeo por hardware está nos planos, a decodificação já está em vigor.

    Simplificando, é um ótimo sistema para trabalhar com código, terminal, navegador e modelos locais, mas não para um dock de monitor externo.

    Monitor externo via núcleo de pó de fada

    A saída de imagem USB-C está disponível no branch experimental do kernel fairydust da equipe Asahi Linux. Leva muito tempo para montá-lo manualmente, então é mais fácil usar o script wrapper do projeto asahi-fairydust-display:

    cd asahi-fairydust-display
    chmod +x asahi-fairydust-build.sh
    ./asahi-fairydust-build.sh
    

    O script clona o branch fairydust, configura e monta o kernel, coloca-o próximo ao padrão e edita o GRUB. Você precisa de 15 GB de espaço livre, um adaptador USB-C → HDMI ou DisplayPort e 60–90 minutos para montar. Após a reinicialização, selecione o kernel denominado -fairydust no GRUB e insira o adaptador na porta USB-C mais frontal.

    Verifique após o download:

    glxinfo | grep "OpenGL renderer"
    xrandr
    

    O primeiro comando deve mostrar a versão com o sufixo -fairydust, o segundo deve mostrar o Apple M2, não llvmpipe, o terceiro deve mostrar a saída DP-1 conectada.

    Reservas. O ramo é experimental e não tem suporte oficial. A saída funciona apenas através de uma porta USB-C e nem sempre sobrevive à conexão a quente – é mais seguro reiniciar com o adaptador já inserido. O script não configura automaticamente a exibição: a etapa correspondente está desabilitada porque causou um loop de login no Wayland. A atualização do kernel padrão via dnf reorganiza o link simbólico /boot/dtb, e é por isso que a saída pode parar de funcionar silenciosamente – então a compilação deve ser repetida.

    O kernel padrão não é alterado: para retornar, basta selecioná-lo no menu GRUB.

    Unidade externa em vez de atualização

    Aqui está o lado bom. O MacBook não pode ser atualizado: a memória e o armazenamento são soldados na placa e sua capacidade é selecionada uma vez no momento da compra. No macOS, a unidade externa permanece externa – o sistema e os aplicativos não podem ser transferidos para ela.

    No Linux, essa limitação foi removida: um SSD externo via USB é um dispositivo de bloco normal e qualquer ponto de montagem pode ser transferido para ele via /etc/fstab. Se você deseja transferir seu diretório inicial, biblioteca Steam, imagens de máquinas virtuais ou modelos locais, faça-o. Acontece exatamente a atualização que este carro não possui.

    Parece assim. Primeiro, observe o UUID da partição desejada:

    sudo blkid
    

    Em seguida, adicione a linha ao /etc/fstab:

    A transferência em si é feita por cópia: os dados são movidos para um drive externo, após o qual são montados no ponto desejado. Na maioria das vezes, nem todo o /home é removido dessa maneira, mas diretórios pesados ​​individuais – dessa forma, há menos risco.

    Algumas advertências. Vale a pena definir o parâmetro nofail nas opções: sem ele o sistema não inicializará se o disco não estiver conectado. A velocidade de uma unidade USB ainda é inferior à do NVMe integrado, por isso é melhor deixar espaço no disco interno para operações de E/S frequentes. E não há necessidade de retirar o disco enquanto move os diretórios montados nele – primeiro desmonte-o.

    Como alternar entre sistemas

    Ao ligá-lo, mantenha pressionado o botão liga / desliga – o menu de inicialização aparecerá, conterá macOS e Linux. Você pode selecionar o sistema padrão no macOS: “Preferências do Sistema” → “Geral” → “Disco do Sistema”. O Linux também possui as configurações correspondentes, para que você possa alternar nas duas direções sem um terminal.

    Links

    https://asahilinux.org/fedora/
    https://asahilinux.org/docs/
    https://asahilinux.org/docs/platform/feature-support/m2/
    https://fedoraproject.org/asahi-remix
    https://github.com/bharambetejas/asahi-fairydust-display
    https://github.com/AsahiLinux/linux/tree/fairydust

    Fontes

    https://asahilinux.org/docs/platform/feature-support/m2/
    https://discussion.fedoraproject.org/t/fedora-asahi-remix-installation-guide/
    https://github.com/AsahiLinux/docs
    https://github.com/bharambetejas/asahi-fairydust-display/blob/main/README.md
    https://github.com/bharambetejas/asahi-fairydust-display/blob/main/asahi-fairydust-build.sh
  • Instalando o VirtualBox com adições de convidados em um Mac ARM

    Instruções para instalar o Ubuntu Server no VirtualBox em um Mac com processador ARM64 e conectar Guest Additions.

    Instalando o VirtualBox

    Baixe a versão ARM64 do VirtualBox, monte a imagem e transfira VirtualBox.app para Aplicativos.

    Configurando uma máquina virtual

    Criamos uma nova máquina, especificamos o tipo de Linux e a versão do Ubuntu (ARM de 64 bits). Nas configurações definimos:

    • TPM – desativar
    • UEFI – desabilitar
    • RAM – 4.096 MB.
    • Controlador gráfico – VMSVGA (para VBoxLinuxAdditions).
    • Processador – 4 núcleos.

    Instalando o Servidor Ubuntu

    Monte a imagem ISO do Ubuntu Server para ARM64 na unidade de CD-ROM. Na seção de download, coloque a unidade óptica em primeiro lugar na lista. Iniciamos a máquina e passamos pela instalação do Ubuntu Server.

    Instalando o xubuntu-desktop

    Instale o ambiente gráfico XFCE:

    sudo apt update
    sudo apt install -y xubuntu-desktop
    

    Na caixa de diálogo de seleção do gerenciador de login, selecione lightdm.

    Reinicie o sistema convidado:

    sudo reboot
    

    Adições de convidados

    Após a primeira inicialização, instale pacotes para construir módulos do kernel:

    sudo apt update
    sudo apt install -y build-essential linux-headers-$(uname -r)
    

    Montamos o disco com Guest Additions através do menu VirtualBox: Dispositivos → Montar imagem de disco do Guest Additions. O disco aparecerá dentro do convidado no diretório /media/$USER.

    Abra um terminal no Xubuntu, vá até o diretório do disco montado e execute o instalador:

    cd /media/$USER/*
    sudo ./VBoxLinuxAdditions-arm64.run
    

    Reinicie o sistema convidado:

    sudo reboot
    

    O que deve funcionar após a instalação

    Verificamos se os módulos do kernel estão carregados:

    lsmod | grep vbox
    

    A saída deve incluir vboxguest e vboxsf.

    Adicione uma pasta compartilhada nas propriedades da máquina e monte-a dentro do convidado:

    sudo mkdir -p /media/sf_shared
    sudo mount -t vboxsf shared /media/sf_shared
    

    Recursos de trabalho:

    • Pastas compartilhadas – o diretório host fica visível dentro do convidado via vboxsf.
    • Área de transferência compartilhada – copie o texto entre o host e o convidado.
    • Integração do mouse – o cursor se estende livremente para fora da janela da máquina.
    • Alteração automática da resolução – a tela do convidado se ajusta ao tamanho da janela.
    • Sincronização de horário – o horário do convidado é ajustado ao horário do anfitrião.

    Fontes

    https://www.virtualbox.org/manual/topics/guestadditions.html
    https://forums.virtualbox.org/viewtopic.php?t=112886

  • Como conectar o DeepSeek ao Claude Code

    Claude Code é um agente de console da Anthropic que pode ler arquivos de projeto, editar código, executar comandos e testes, pesquisar no repositório e trabalhar com git. O principal inconveniente de utilizá-lo é o custo: sessões longas e com muito contexto consomem rapidamente o orçamento da assinatura.

    Existe uma solução. DeepSeek fornece um endpoint compatível com a API Antrópica. Basta alterar o endereço base e o token, e Claude Code começará a funcionar nos modelos DeepSeek, sem necessidade de reinstalação ou patches. Neste post irei descrever como configurar isso no macOS, Linux e Windows.

    Por que isso é necessário

    Os motivos podem ser diferentes:
    – Preço. Os modelos DeepSeek são visivelmente mais baratos que o Claude, e para tarefas rotineiras do agente – navegar em um projeto, pequenas edições, executar testes – nem sempre é necessária qualidade superior.
    – Disponibilidade. Se você não possui uma assinatura ou o pagamento com cartão Antrópico não está disponível por algum motivo, o DeepSeek se torna uma opção funcional.
    – Experimentos. É interessante comparar como diferentes modelos lidam com a mesma base de código no mesmo ambiente.

    O que você precisa

    Você precisa do Claude Code instalado e da chave da API DeepSeek. Se o Claude Code ainda não estiver instalado, a ordem é a seguinte:
    1. Instale o Node.js 18 ou posterior. No Windows, você também precisará do Git para Windows.
    2. Instale o próprio Claude Code usando o comando abaixo.
    3. Verifique a instalação.

    npm install -g @anthropic-ai/claude-code
    claude --version
    

    Se a versão for exibida, a instalação foi bem-sucedida. A chave API é criada em sua conta pessoal DeepSeek na página de chaves.

    Configuração via variáveis ​​de ambiente

    Toda integração se resume a variáveis ​​de ambiente. Para macOS e Linux é assim:

    export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
    export ANTHROPIC_AUTH_TOKEN=ваш_ключ_deepseek
    
    export ANTHROPIC_MODEL=deepseek-flash[1m]
    export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
    export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
    export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
    export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
    
    export CLAUDE_CODE_EFFORT_LEVEL=max
    export CLAUDE_CODE_AUTO_COMPACT_WINDOW=786432
    

    Para Windows no PowerShell a sintaxe é diferente, mas os nomes das variáveis ​​são os mesmos:

    $env:ANTHROPIC_BASE_URL="https://api.deepseek.com/anthropic"
    $env:ANTHROPIC_AUTH_TOKEN="ваш_ключ_deepseek"
    $env:ANTHROPIC_MODEL="deepseek-flash[1m]"
    

    Vamos descobrir o que há aqui. A variável `ANTHROPIC_BASE_URL` redireciona solicitações de servidores Anthropic para DeepSeek. `ANTHROPIC_AUTH_TOKEN` substitui sua chave. As variáveis ​​restantes determinam qual modelo é usado em qual função. Existem modelos com o sufixo `[1m]` – esta é uma opção com uma janela de contexto de cerca de um milhão de tokens, o que permite ao agente armazenar significativamente mais arquivos de projeto por vez. Conseqüentemente, `CLAUDE_CODE_AUTO_COMPACT_WINDOW` é definido para o tamanho desta janela para que a compactação automática do histórico não funcione muito cedo.

    É conveniente não exportar variáveis ​​manualmente todas as vezes, mas registrá-las na configuração do Claude Code. Em seguida, as configurações serão selecionadas automaticamente na inicialização.

    {
      "env": {
        "ANTHROPIC_BASE_URL": "https://api.deepseek.com/anthropic",
        "ANTHROPIC_AUTH_TOKEN": "ваш_ключ_deepseek",
        "ANTHROPIC_MODEL": "deepseek-flash[1m]",
        "ANTHROPIC_DEFAULT_HAIKU_MODEL": "deepseek-flash",
        "CLAUDE_CODE_SUBAGENT_MODEL": "deepseek-flash"
      }
    }
    

    Depois disso, acesse o diretório do projeto e execute o agente:

    cd ваш_проект
    claude
    

    Código Claude no Código VS

    O Claude Code está disponível não apenas no terminal, mas também como uma extensão do VS Code. Ele é instalado normalmente: abra o painel de extensões usando Cmd+Shift+X, encontre “Claude Code” e clique em Instalar. A expansão é produzida pela própria Antrópica.

    A extensão contém sua própria cópia da CLI e lê o mesmo arquivo ~/.claude/settings.json da versão do terminal. As configurações da seção anterior também se aplicam aqui – mas com uma ressalva, que geralmente causa confusão.

    A verificação de entrada ocorre antes do lançamento

    Antes de começar, a extensão verifica as credenciais de sua própria configuração `claudeCode.environmentVariables`, e não de settings.json. Os valores de settings.json chegam ao processo em execução – ou seja, o endereço da API e os modelos selecionados são escolhidos corretamente – mas não passam na verificação de login da própria extensão. Se você vir a tela de login mesmo que tudo já esteja funcionando no terminal, esse é o motivo.

    Isso pode ser resolvido com algumas linhas nas configurações do VS Code: duplique as variáveis ​​em `claudeCode.environmentVariables` e desative a solicitação de login.

    {
      "claudeCode.environmentVariables": [
        { "name": "ANTHROPIC_BASE_URL", "value": "https://api.deepseek.com/anthropic" },
        { "name": "ANTHROPIC_AUTH_TOKEN", "value": "ваш_ключ_deepseek" },
        { "name": "ANTHROPIC_MODEL", "value": "deepseek-flash[1m]" }
      ],
      "claudeCode.disableLoginPrompt": true
    }
    

    nuance do macOS

    Se você iniciar o VS Code do Dock ou Finder, ele não herdará variáveis ​​de ambiente de ~/.zshrc. Este é o comportamento padrão do macOS e é discutido especificamente na documentação do Claude Code. Ou seja, `export ANTHROPIC_BASE_URL=…` em seu shell para a extensão simplesmente não funcionará – esta variável não estará em seu ambiente.

    Há duas conclusões disso. Primeiramente, as configurações em `claudeCode.environmentVariables` são mais confiáveis ​​que as variáveis ​​do shell. Em segundo lugar, se você ainda prefere um shell, inicie o editor a partir do terminal, onde as variáveis ​​já foram exportadas:

    code .
    

    O que não funciona

    Em um provedor terceirizado, alguns recursos de extensão não estão disponíveis porque exigem uma conta claude.ai:
    – não haverá barra de uso do plano, entrada de voz e aba Web para sessões na nuvem;
    – os comandos de logout não são mostrados no menu;
    – `/usage` mostrará o consumo e o número de tokens da sessão atual em vez dos limites do plano;
    – O Controle Remoto não funciona se o endereço base não for Antrópico.

    Este é o comportamento esperado e não um sinal de que a configuração falhou.

    Separadamente, gostaria de acrescentar que JetBrains possui seu próprio plugin, mas é projetado de forma diferente: não contém uma CLI integrada, mas inicia uma já instalada no terminal integrado. Não há configurações para variáveis ​​de ambiente, então você deve iniciar o IDE a partir do terminal com variáveis ​​já exportadas.

    Como o DeepSeek entende os nomes dos modelos de Claude

    Claude Code refere-se internamente a modelos por nomes como Claude-opus, Claude-sonnet e Claude-haiku. DeepSeek intercepta esses nomes e os substitui pelos seus próprios:
    – tudo que começa com claude-opus vai para deepseek-v4-pro;
    – tudo que começa com claude-sonnet ou claude-haiku vai para deepseek-flash;
    – o nome do modelo desconhecido também é reduzido para deepseek-flash.

    Isso significa que mesmo sem especificar explicitamente os modelos, a integração funcionará – mas é melhor controlar explicitamente quais modelos e a que tarifa atenderão a solicitação. É por isso que nas configurações acima todas as funções são escritas manualmente.

    No que prestar atenção

    A compatibilidade está incompleta e você deve saber disso com antecedência. DeepSeek simplesmente ignora alguns dos recursos da API Antrópica:

    – Prompts de cache. O campo `cache_control` não é suportado. Claude Code usa ativamente o cache para não pagar a mais pelo envio repetido do mesmo contexto. Isso não acontecerá aqui, portanto, sessões longas são mais caras do que você esperaria do preço por token. Inicie periodicamente um novo diálogo em vez de continuar indefinidamente o antigo.
    – Thinking Budget. O parâmetro `thinking` é suportado, mas os `budget_tokens` dentro dele são ignorados.
    – Diversos. Os campos `top_k`, `service_tier`, `container` e a conexão dos servidores MCP da API também são ignorados.
    – MCP. O mecanismo integrado do servidor MCP no lado do DeepSeek não funciona, embora as ferramentas usuais do agente – leitura de arquivos, edição, execução de comandos, pesquisa – funcionem normalmente.

    Separadamente, vale a pena mencionar os proxies. Existem projetos na comunidade como `ds-cc-proxy`, que são colocados entre Claude Code e DeepSeek e assumem a tarefa de suavizar pequenas incompatibilidades, bem como separar a sessão principal e os subagentes em diferentes modelos. Se a configuração padrão se comportar de forma instável, essa camada intermediária pode ajudar.

    Roteador Código Claude

    O método descrito acima coloca um modelo em todas as tarefas. Mas o agente faz coisas muito diferentes: entende a estrutura do projeto, corrige pequenas coisas e às vezes resolve um problema verdadeiramente complexo. É lógico que diferentes modelos sejam utilizados para diferentes tipos de trabalho. Isso é exatamente o que o roteador de código claude (CCR) pode fazer – um gateway local que fica entre o Código Claude e os provedores modelo.

    O que isso oferece

    – Roteamento por regras. Você pode definir qual modelo atende a sessão principal, qual atende tarefas em segundo plano, qual atende o modo de agendamento. Faz sentido usar um modelo caro apenas para raciocínios complexos e ceder a rotina a um modelo barato.
    – Opções de backup. Se o provedor retornar um erro, a solicitação vai para o próximo modelo na cadeia, em vez de descartar a sessão.
    – Observabilidade. A interface mostra o log de solicitações, atrasos, consumo de token e custo – algo que você só pode adivinhar com uma conexão direta.
    – Um endereço para vários agentes. Provedores, chaves e regras residem em um só lugar e os clientes se conectam a um endereço local.

    Primeiro sobre versões – isso é importante

    Vale a pena avisar aqui porque você economizará tempo. O CCR foi fortemente redesenhado ao longo de sua história, e quase todos os artigos que você encontra em uma pesquisa descrevem a versão desatualizada.

    Nas versões mais antigas, a configuração estava no arquivo ~/.claude-code-router/config.json com os blocos Provedores e Roteadores, e tudo era iniciado com o comando `ccr code`. Agora não funciona mais assim. A versão atual (3.x) armazena configurações no banco de dados SQLite e é gerenciada por meio de uma interface web. O antigo config.json é lido exatamente uma vez como fonte de migração se ainda não houver banco de dados – depois disso, as edições nele não afetam nada.

    Ou seja, se você encontrou instruções na Internet com a edição do config.json e do comando `ccr code` e nada funcionou para você, você está editando um arquivo que ninguém lê mais. Não é sua culpa.

    Instalação

    Você precisará do Node.js 22 ou posterior.

    npm install -g @musistudio/claude-code-router
    ccr ui
    

    O comando `ccr ui` traz o serviço em segundo plano e abre a interface de gerenciamento no navegador. É útil conhecer os outros comandos: `ccr start` inicia um serviço, `ccr stop` o interrompe, `ccr serve` funciona em primeiro plano e é conveniente quando você precisa ver logs.

    Por padrão, a interface de gerenciamento reside na porta 3458, e o próprio gateway para modelos reside na porta 3456.

    Configurações

    Tudo é feito na interface web, sem edição manual de arquivos:
    1. Na seção Provedores, adicione o provedor DeepSeek e especifique sua chave. Observação: aqui é necessário o endereço completo até o chat/ponto de conclusão, não apenas o domínio.
    2. Na seção Modelos, descreva o que é esse modelo – a descrição ajuda no roteamento.
    3. Na seção Configuração do agente, defina o modelo padrão.
    4. Na seção Roteamento, configure as regras: qual modelo responde a quais solicitações.
    5. Na página API Keys, crie uma chave de cliente CCR – é isso que Claude Code usará, não a chave DeepSeek.

    Depois disso, resta enviar o Código Claude ao gateway: especificar o endereço do gateway mostrado na interface como endereço base e a chave do cliente CCR como token.

    Uma coisa boa: as regras de roteamento podem ser escritas não apenas com campos, mas também com um script JavaScript, se a lógica for mais complexa do que comparar um campo.

    Vale a pena usá-lo

    Conectar o DeepSeek ao Claude Code é principalmente uma forma de reduzir custos sem abrir mão de um ambiente de agente conveniente. Você obtém a mesma interface, as mesmas ferramentas e o mesmo fluxo de trabalho, mas em um modelo diferente. A configuração leva alguns minutos e é totalmente reversível: basta remover as variáveis ​​de ambiente para retornar aos modelos Antrópicos.

    As limitações também são claras: não há cache de prompt, compatibilidade incompleta com relação aos campos da API e a qualidade do modelo pode diferir para tarefas arquitetônicas complexas. Para trabalho rotineiro no repositório – navegação, refatoração, execução de testes – isso é mais que suficiente.

    Exemplo: Oni-Extendido

    Um exemplo vivo dessa combinação é meu projeto Oni-Extended, um fork do port do jogo Oni (Bungie, 2001) para Apple Silicon. As fontes do jogo são escritas em C e existem há mais de vinte anos; nunca houve nenhum teste neles e os tamanhos dos arquivos são medidos em dezenas de milhares de linhas. No entanto, novos recursos foram adicionados ao projeto por meio de Claude Code do DeepSeek: salvamento e carregamento rápido via F5/F9, um bloco de retenção de tecla e um sinalizador de lançamento -nodamage que desativa os danos.

    Esta é uma boa ilustração do que foi dito acima. Todas as tarefas estão relacionadas ao trabalho rotineiro em um grande repositório – o agente examina o código de outras pessoas, encontra conexões entre módulos e testa hipóteses, em vez de projetar uma arquitetura do zero. O custo dessas sessões no DeepSeek acaba sendo visivelmente menor do que nos modelos Antrópicos, apesar de o resultado ser verificado pela própria infraestrutura do projeto: montagem, bancada de nível e testes offline.

    Links

    https://platform.deepseek.com/api_keys
    https://api-docs.deepseek.com
    https://docs.anthropic.com/en/docs/claude-code
    https://github.com/anthropics/claude-code
    https://github.com/musistudio/claude-code-router
    https://ccrdesk.top/en/guides/cli/
    https://github.com/zefir1990/Oni-Extended

    Fontes

    https://api-docs.deepseek.com/guides/anthropic_api
    https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code
    https://ccrdesk.top/en/routing/
    https://code.claude.com/docs/en/vs-code

  • Donki Hills está oficialmente no Steam há mais de um ano!

    Donki Hills está no Steam há mais de um ano!

    Há exatamente um ano o projeto apareceu na página do Steam e, desde então, o jogo já percorreu um longo caminho. Durante esse tempo, houve muitos experimentos, mudanças e buscas pela direção em que Donki Hills deveria se desenvolver.

    O trabalho na jogabilidade continua e agora o projeto está gradualmente adquirindo sua verdadeira face. Donki Hills está começando a se transformar no que deveria ser – Comédia em primeira pessoa Roguelike Parody Survival Horror.

    Uma estranha aventura onde o terror encontra o humor, a exploração e situações inesperadas. Você tem que ir até a cidade, procurar objetos, resolver enigmas e aos poucos desvendar o segredo que o levará até Maria.

    Abaixo estão novas capturas de tela do próximo teste do protótipo. Este ainda não é o visual final do jogo, mas já dá para sentir o clima da cidade e o rumo que o projeto está tomando.

    Muito interessado em ouvir sua reação! 👀
    O que você acha da nova direção? Quais são suas impressões sobre a atmosfera e ideias do jogo?

    Obrigado a todos que adicionaram Donki Hills à sua lista de desejos, acompanham o desenvolvimento e apoiam o projeto ❤️

    Ainda há muitos experimentos, novas mecânicas e estranhas aventuras pela frente.

    https://store.steampowered.com/app/3476390/Donki_Hills/

  • Ignorando o afogamento em processadores de laptops para jogos

    Os fabricantes de laptops para jogos modernos geralmente configuram os sistemas para que o processador aqueça até 90 graus e até atinja 100 graus Celsius sob carga. Este problema é especialmente grave no verão, durante a execução de jogos exigentes ou tarefas de trabalho pesadas.

    Devido ao aquecimento extremo, o afogamento é ativado (redefinindo as frequências do processador para evitar danos físicos), o que leva a uma perda acentuada de desempenho, congelamentos e queda no FPS. Há muitas maneiras de combater o superaquecimento (desde o uso de placas de resfriamento até a subvoltagem), mas neste artigo descreverei o método mais simples e rápido que é relevante para o Windows 11 e versões anteriores do sistema operacional.

    O método consiste em limitar o estado máximo do processador por meio das configurações da fonte de alimentação:

    1. Abra Opções de energia por meio da Pesquisa do Windows ou do Painel de controle.
    2. No plano de energia ativo, vá para a seção de alteração de parâmetros adicionais.
    3. Encontre a ramificação Gerenciamento de energia do processador.
    4. Expanda a opção Estado máximo do processador.
    5. Para Conectado, altere o valor de 100% para 80% ou menos.

    Depois de aplicar essas configurações, o processador não fará mais overclock automático para frequências extremas que geram excesso de calor. Embora o desempenho máximo máximo diminua em aproximadamente 20%, o processador não superaquecerá mais. A operação estável em uma frequência reduzida sem estrangulamento é MUITO melhor e mais confortável para o sistema do que saltos bruscos e constantes no desempenho devido ao superaquecimento em temperaturas abaixo de 100 graus.

    Cada laptop é único, por isso recomendo que os usuários experimentem e encontrem o equilíbrio ideal (porcentagem) que fornecerá o desempenho desejado sem superaquecimento.

  • Portando Surreal Engine C++ para WebAssembly

    Neste post irei descrever como portei o motor de jogo Surreal Engine para WebAssembly.
    https://demensdeum.com/demos/SurrealEngine/”
    Motor Surreal – um motor de jogo que implementa a maior parte das funcionalidades do Unreal Engine 1, jogos famosos neste motor – Torneio Unreal 99, Unreal, Deus Ex, Imortal. Refere-se a mecanismos clássicos que funcionavam principalmente em um ambiente de execução de thread único.
    Originalmente tive a ideia de assumir um projeto que não conseguiria concluir em um prazo razoável, mostrando assim aos meus seguidores do Twitch que existem projetos que nem eu consigo realizar. Durante minha primeira transmissão, de repente percebi que a tarefa de portar o Surreal Engine C++ para WebAssembly usando Emscripten era viável.

    Um mês depois, posso demonstrar meu conjunto de garfo e motor no WebAssembly:
    https://demensdeum.com/demos/SurrealEngine/
    O controle, como no original, é feito por meio das setas do teclado. A seguir, pretendo adaptá-lo para controle móvel (tachi), adicionando iluminação correta e outros recursos gráficos da renderização do Unreal Tournament 99.

    Por onde começar?

    A primeira coisa que quero dizer é que qualquer projeto pode ser portado de C++ para WebAssembly usando Emscripten, a única dúvida é quão completa será a funcionalidade. Escolha um projeto cujas portas de biblioteca já estejam disponíveis para Emscripten; no caso do Surreal Engine, você tem muita sorte, pois o motor usa o SDL 2, OpenAL – bibliotecas. ambos foram portados para o Emscripten. No entanto, Vulkan é usado como uma API gráfica, que atualmente não está disponível para HTML5, o trabalho está em andamento para implementar WebGPU, mas também está em fase de rascunho, e também não se sabe quão simples será a porta adicional de Vulkan para WebGPU, depois de totalmente padronizada. Portanto, tive que escrever meu próprio renderizador básico OpenGL-ES/WebGL para Surreal Engine.

    Construindo o projeto

    Construir sistema no Surreal Engine – CMake, que também simplifica a portabilidade, porque o Emscripten fornece aos seus construtores nativos – recursos de atualização. emcmake, emmake.
    O porte do Surreal Engine foi baseado no código do meu último jogo em WebGL/OpenGL ES e C++ chamado Death-Mask, por isso o desenvolvimento foi muito mais simples, eu tinha todos os build flags necessários comigo e exemplos de código.
    Um dos pontos mais importantes em CMakeLists.txt são os flags de construção do Emscripten, abaixo está um exemplo do arquivo do projeto:

    set(CMAKE_CXX_FLAGS "-s MIN_WEBGL_VERSION=2 
    -s MAX_WEBGL_VERSION=2 
    -s EXCEPTION_DEBUG 
    -fexceptions 
    --preload-file UnrealTournament/ 
    --preload-file SurrealEngine.pk3 
    --bind 
    --use-preload-plugins 
    -Wall 
    -Wextra 
    -Werror=return-type 
    -s USE_SDL=2 
    -s ASSERTIONS=1 
    -w 
    -g4 
    -s DISABLE_EXCEPTION_CATCHING=0 
    -O3 
    --no-heap-copy 
    -s ALLOW_MEMORY_GROWTH=1 
    -s EXIT_RUNTIME=1")
    

    O próprio script de construção:

    clear
    emmake make -j 16
    cp SurrealEngine.data /srv/http/SurrealEngine/SurrealEngine.data
    cp SurrealEngine.js /srv/http/SurrealEngine/SurrealEngine.js
    cp SurrealEngine.wasm /srv/http/SurrealEngine/SurrealEngine.wasm
    cp ../buildScripts/Emscripten/index.html /srv/http/SurrealEngine/index.html
    

    A seguir, vamos preparar index.html, que inclui o pré-carregador do sistema de arquivos do projeto. Para fazer upload para a web, usei o Unreal Tournament Demo versão 338. Como você pode ver no arquivo CMake, a pasta do jogo descompactada foi adicionada ao diretório de construção e vinculada como um arquivo de pré-carregamento para Emscripten.

    Alterações principais no código

    Então tivemos que mudar o loop do jogo, você não pode executar um loop infinito, isso leva ao congelamento do navegador, em vez disso você precisa usar emscripten_set_main_loop, escrevi sobre esse recurso em minha nota de 2017 “Portando jogos SDL C++ para HTML5 (Emscripten)”
    Alteramos o código para sair do loop while para if, então exibimos a classe principal do mecanismo de jogo, que contém o loop do jogo, no escopo global, e escrevemos uma função global que chamará a etapa do loop do jogo do objeto global:

    #if __EMSCRIPTEN__
    #include <emscripten.h>
    Engine *EMSCRIPTEN_GLOBAL_GAME_ENGINE = nullptr;
    void emscripten_game_loop_step() {
    	EMSCRIPTEN_GLOBAL_GAME_ENGINE->Run();
    }
    #endif
    

    Depois disso, você precisa ter certeza de que não há threads em segundo plano no aplicativo; se houver, prepare-se para reescrevê-los para execução de thread único ou use a biblioteca phtread no Emscripten.
    O thread de segundo plano no Surreal Engine é usado para reproduzir música, os dados vêm do thread do mecanismo principal sobre a faixa atual, a necessidade de tocar música ou sua ausência, então o thread de segundo plano recebe um novo estado por meio de um mutex e começa a reproduzir uma nova música ou faz uma pausa. O thread de fundo também é usado para armazenar música em buffer durante a reprodução.
    Minhas tentativas de construir o Surreal Engine para Emscripten com pthread não tiveram sucesso, porque as portas SDL2 e OpenAL foram construídas sem suporte para pthread e eu não queria reconstruí-las por causa da música. Portanto, transferi a funcionalidade do fluxo de música de fundo para execução de thread único usando um loop. Ao remover as chamadas pthread do código C++, movi o buffer e a reprodução de música para o thread principal, para que não houvesse atrasos, aumentei o buffer em alguns segundos.
    A seguir, descreverei implementações específicas de gráficos e som.

    Vulkan não é compatível!

    Sim, Vulkan não é compatível com HTML5, embora todos os folhetos de marketing apresentem suporte multiplataforma e amplo suporte de plataforma como a principal vantagem do Vulkan. Por esse motivo, tive que escrever meu próprio renderizador gráfico básico para um tipo OpenGL simplificado – – ES, é usado em dispositivos móveis, às vezes não contém os recursos modernos do OpenGL moderno, mas porta muito bem para WebGL, que é exatamente o que o Emscripten implementa. A escrita da renderização básica de blocos, renderização bsp, para a exibição da GUI mais simples e renderização de modelos + mapas foi concluída em duas semanas. Esta foi talvez a parte mais difícil do projeto. Ainda há muito trabalho pela frente para implementar todas as funcionalidades da renderização do Surreal Engine, portanto, qualquer ajuda dos leitores é bem-vinda na forma de código e solicitações pull.

    OpenAL suportado!

    A grande sorte é que o Surreal Engine usa OpenAL para saída de áudio. Depois de escrever um hello world simples em OpenAL e montá-lo em WebAssembly usando Emscripten, ficou claro para mim como tudo era simples e comecei a portar o som.
    Após várias horas de depuração, ficou óbvio que a implementação OpenAL do Emscripten possui vários bugs, por exemplo, ao inicializar a leitura do número de canais mono, o método retornava um número infinito, e após tentar inicializar um vetor de tamanho infinito, C++ trava com a exceção vector::length_error.
    Conseguimos contornar isso codificando o número de canais mono para 2048:

    		alcGetIntegerv(alDevice, ALC_MONO_SOURCES, 1, &monoSources);
    		alcGetIntegerv(alDevice, ALC_STEREO_SOURCES, 1, &stereoSources);
    
    #if __EMSCRIPTEN__
    		monoSources = 2048; // for some reason Emscripten's OpenAL gives infinite monoSources count, bug?
    #endif


    Existe uma rede?

    Atualmente, o Surreal Engine não suporta jogos online, o jogo com bots é compatível, mas precisamos de alguém para escrever IA para esses bots. Teoricamente, você pode implementar um jogo em rede no WebAssembly/Emscripten usando Websockets.

    Conclusão

    Concluindo, gostaria de dizer que a portabilidade do Surreal Engine acabou sendo bastante tranquila devido ao uso de bibliotecas para as quais existem portas Emscripten, bem como à minha experiência anterior na implementação de um jogo em C++ para WebAssembly em Emscripten. Abaixo estão links para fontes de conhecimento e repositórios sobre o tema.
    M-M-M-MATANÇA DE MONSTRO!
    Além disso, se você quiser ajudar o projeto, de preferência com código de renderização WebGL/OpenGL ES, escreva para mim no Telegram:
    https://t.me/demenscave

    Links

    https://demensdeum.com/demos/SurrealEngine/

    https://github.com/demensdeum/SurrealEngine-Emscripten

    https://github.com/dpjudas/SurrealEngine

  • Encaminhamento de porta entre clientes via Chisel: um túnel simplificado sem L3

    Quando dois dispositivos estão protegidos por NAT ou firewalls rígidos e não podem “ver” um ao outro diretamente, uma VPN parece ser a solução padrão. Mas um túnel L3 completo (como WireGuard ou OpenVPN) é muitas vezes redundante: requer direitos de root, configuração de interfaces virtuais e pode entrar em conflito com rotas existentes.

    Nesses casos, é conveniente usar Chisel – um túnel TCP/UDP que roda sobre HTTP e usa WebSockets para transferência de dados. Nesta nota mostrarei como “encaminhar” uma porta de um cliente para outro através de um servidor intermediário.

    Como funciona?

    Imagine a situação: você tem o Cliente A (por exemplo, seu servidor doméstico), o Cliente B (seu laptop de trabalho) e um VPS com endereço IP público. Os clientes A e B podem acessar o VPS, mas não um ao outro.

    O esquema de encaminhamento ficará assim:
    1. O Cliente A conecta-se ao VPS e abre uma porta “reversa” no servidor. Agora tudo que chega na porta X do servidor vai para a porta Y do Cliente A.
    2. O Cliente B conecta-se ao VPS e encaminha a porta Z de sua máquina local para a porta X do servidor.
    3. Como resultado, o Cliente B acessa localhost:Z e termina em Cliente A:Y.

    Esta abordagem é uma das soluções nos casos em que a comunicação com um VPS não implementa uma camada L3 ou não há capacidade de configurar o roteamento entre clientes. Trabalhamos exclusivamente a nível de aplicação e porto.

    Etapa 1: iniciar o servidor

    No seu VPS, basta executar o Chisel no modo servidor. O sinalizador --reverse é necessário para permitir que os clientes abram portas no lado do servidor.

    chisel server --port 8080 --reverse
    

    Etapa 2: Conectando o Cliente A (Fonte)

    Digamos que o Cliente A queira abrir o acesso ao seu servidor web local na porta 3000. Ele se conecta ao VPS e diz: “reserve a porta 2000 no servidor e encaminhe para mim para 3000”.

    chisel client vps-ip:8080 R:2000:127.0.0.1:3000
    

    Agora a porta 2000 no VPS (na interface de loopback) leva ao Cliente A.

    Etapa 3: Conectando o Cliente B (Consumidor)

    Agora o Cliente B deseja acessar este recurso. Ele se conecta ao mesmo VPS e encaminha sua porta local 8080 para a porta 2000 do servidor.

    chisel client vps-ip:8080 8080:127.0.0.1:2000
    

    Preparar! Agora, ao abrir http://localhost:8080 no Cliente B, você verá o serviço em execução no Cliente A.

    Segurança e nuances

    Chisel suporta autenticação através do sinalizador --auth, que é altamente recomendado ao trabalhar através de servidores públicos. Você também pode usar certificados TLS para criptografar o tráfego.

    A principal vantagem desta abordagem é que não há necessidade de dispositivos TUN/TAP e tabelas de roteamento complexas. Este é um túnel simplificado que faz exatamente uma coisa: vincula portas por meio de uma conexão WebSocket. Isso funciona até mesmo por meio de proxies corporativos se você configurar o Chisel para funcionar pela porta 443.

    Saída

    Chisel é um utilitário para tarefas específicas de rede. Quando você precisa encaminhar portas entre nós isolados sem configurar uma VPN completa, uma combinação de túneis de encaminhamento e reverso através de um servidor de retransmissão acaba sendo uma solução completamente viável.

    Links

    https://github.com/jpillora/chisel

  • Por que não consigo corrigir o bug?

    Você passa horas trabalhando no código, analisando hipóteses, ajustando as condições, mas o bug ainda é reproduzido. Parece familiar? Esse estado de frustração costuma ser chamado de “caça aos fantasmas”. O programa parece viver sua própria vida, ignorando suas correções.

    Um dos motivos mais comuns – e mais irritantes – para essa situação é procurar um erro no lugar completamente errado do aplicativo.

    A armadilha dos “falsos sintomas”

    Quando vemos um erro, nossa atenção é atraída para o local onde ele “disparou”. Mas em sistemas complexos, onde ocorre um bug (travamento ou valor incorreto) é apenas o fim de uma longa cadeia de eventos. Ao tentar consertar o final, você está lutando contra os sintomas, não contra a doença.

    É aqui que entra o conceito de fluxograma.

    Como funciona na realidade

    Claro, não é necessário desenhar (desenhar) diretamente um fluxograma no papel todas as vezes, mas é importante tê-lo em mente ou em mãos como um guia arquitetônico. Um fluxograma permite visualizar a operação de um aplicativo como uma árvore de resultados.

    Sem compreender essa estrutura, o desenvolvedor muitas vezes fica tateando no escuro. Imagine a situação: você edita a lógica em uma ramificação de condição, enquanto a aplicação (devido a um determinado conjunto de parâmetros) vai para uma ramificação completamente diferente na qual você nem pensou.

    Resultado: você gasta horas em uma correção de código “perfeita” em uma parte do algoritmo, o que, é claro, não faz nada para corrigir o problema em outra parte do algoritmo onde ele realmente falha.


    Algoritmo para derrotar um bug

    Para parar de bater em uma porta fechada, você precisa mudar sua abordagem ao diagnóstico:

    • Encontre o estado na árvore de resultados:Antes de escrever o código, você precisa determinar exatamente o caminho que o aplicativo seguiu. Em que ponto a lógica tomou o rumo errado? Qual estado específico (Estado) levou ao problema?
    • A reprodução tem 80% de sucesso: Isso geralmente é feito por testadores e testes automatizados. Se o bug estiver “flutuante”, o desenvolvimento estará envolvido no processo de busca conjunta de condições.
    • Use o máximo de informações possível: registros, versão do sistema operacional, parâmetros do dispositivo, tipo de conexão (Wi-Fi/5G) e até mesmo uma operadora de telecomunicações específica são importantes para a localização.

    “Fotografia” do momento do erro

    Idealmente, para corrigi-lo, você precisa obter o estado completo do aplicativo no momento em que o bug foi reproduzido. Os logs de interação também são extremamente importantes: eles mostram não apenas o ponto final, mas também todo o caminho do usuário (quais ações precederam a falha). Isso ajuda a entender como recriar um estado semelhante novamente.

    Dica futura: se você encontrar um caso complexo, adicione informações estendidas de registro de depuração a esta seção do código, caso a situação aconteça novamente.


    O problema dos estados “indescritíveis” na era da IA

    Em sistemas modernos que usam LLM (Large Language Models), o determinismo clássico (“uma entrada, uma saída”) é frequentemente violado. Você pode passar exatamente os mesmos dados de entrada, mas obter um resultado diferente.

    Isso acontece devido ao não determinismo dos sistemas de produção modernos:

    • Paralelismo de GPU: as operações de ponto flutuante da GPU nem sempre são associativas. Devido à execução paralela de threads, a ordem em que os números são adicionados pode mudar ligeiramente, o que pode afetar o resultado.
    • Temperatura e aceleração da GPU: a velocidade de execução e a distribuição de carga podem depender do estado físico do hardware. Em modelos enormes, essas diferenças microscópicas se acumulam e podem levar à seleção de um token diferente na saída.
    • Lote dinâmico: Na nuvem, sua solicitação é combinada com outras. Diferentes tamanhos de lote alteram a matemática dos cálculos nos kernels.

    Sob tais condições, torna-se quase impossível reproduzir “esse mesmo estado”. Somente uma abordagem estatística aos testes pode salvá-lo aqui.


    Quando a lógica falha: problemas de memória

    Se você estiver trabalhando com linguagens “inseguras” (C ou C++), o bug pode ocorrer devido a corrupção de memória.

    Esses são os casos mais graves: um erro em um módulo pode “sobrescrever” dados em outro. Isso leva a falhas completamente inexplicáveis ​​e isoladas que não podem ser rastreadas usando a lógica normal do aplicativo.

    Como se proteger no nível arquitetônico?

    Para evitar esses bugs “místicos”, você deve usar abordagens modernas:

    • Padrões de programação multithread:a sincronização clara elimina condições de corrida.
    • Linguagens thread-safe: Ferramentas que garantem a segurança da memória em tempo de compilação:
      • Rust: o sistema de propriedade elimina erros de memória.
      • Simultaneidade Swift 6:fortes verificações de isolamento de dados.
      • Erlang: isolamento completo do processo por meio do modelo de ator.

    Resumo

    Consertar um bug não é escrever um novo código, mas entender como o antigo funciona. Lembre-se: você pode estar perdendo tempo editando uma filial que a administração nem sequer toca. Registre o estado do sistema, leve em consideração o fator de não determinismo da IA ​​e escolha ferramentas seguras.

  • Por que a documentação é sua melhor amiga

    (e como criar soluções que continuem funcionando após as atualizações)

    “Os aplicativos só podem usar APIs públicas e devem ser executados no sistema operacional atualmente enviado.” Diretrizes de revisão de aplicativos da Apple

    Se você já começou a trabalhar com um novo framework e se pegou pensando: “Agora vou entender tudo sozinho, ler a documentação é muito longo”, você definitivamente não está sozinho. Muitos de nós temos um instinto investigativo natural: tente primeiro e só depois leia as instruções. E isso é completamente normal.

    No entanto, nesta fase pode ser fácil deixar-se levar e acabar numa situação em que o código funciona muito bem, mas talvez dependa de características não óbvias do sistema.

    Por que às vezes não é suficiente simplesmente “descobrir por conta própria”?

    Frameworks, especialmente os fechados, são sistemas complexos e de múltiplas camadas. Freqüentemente, eles ocultam lógica interna e otimizações que:

    * não estão descritos em documentação pública;
    * não garantem que o comportamento será mantido no futuro;
    *pode sofrer alterações com o lançamento de novas versões;
    * pode conter recursos conhecidos pelos desenvolvedores que ainda não foram corrigidos.

    Quando agimos intuitivamente, existe o risco de construirmos arquitetura com base em observações aleatórias e não em regras documentadas. Isso pode tornar o código mais sensível a atualizações.

    A documentação não é uma limitação, mas um suporte confiável

    Os desenvolvedores de frameworks criam manuais para nos ajudar. Atuando dentro da documentação, obtemos:

    * estabilidade;
    * apoiar;
    * comportamento previsível do sistema.

    Ao ultrapassar esses limites, assumimos riscos adicionais e a manutenção desse código torna-se mais difícil.

    Experimentos? Certamente. Mas com uma compreensão dos limites.
    A curiosidade é uma ótima característica para se ter em um desenvolvedor. Explorar e experimentar coisas novas é absolutamente essencial. Mas aqui está um pequeno desejo:

    A maneira mais confortável de experimentar é confiar nas melhores práticas.

    A documentação é um mapa que mostra quais caminhos são mais seguros e suportados pelos criadores.

    Uma perspectiva externa: aconselhamento especializado

    Muitas vezes aprendemos com colegas experientes:

    * eles conduzem cursos úteis,
    * falar em conferências,
    * escrever livros e blogs maravilhosos,
    * compartilhe sua visão única.

    Muitos deles compartilham experiências verdadeiramente valiosas. Mas vale lembrar: se as abordagens do autor contrariarem a documentação oficial, podem revelar-se frágeis.

    Esses “padrões empíricos” às vezes:

    * trabalhar apenas em uma versão específica do framework;
    * sensível a atualizações;
    * pode se comportar de maneira imprevisível em situações incomuns.

    Aprender com a comunidade é ótimo e gratificante. Mas qualquer conselho, mesmo o mais confiável, deve sempre ser cuidadosamente verificado nos manuais oficiais.

    Um pouco sobre SOLID

    Três ideias dos princípios SOLID complementam perfeitamente esta abordagem:

    * Princípio Aberto/Fechado: Tente estender o comportamento por meio de APIs públicas e, se possível, não dependa de implementação oculta.
    * Princípio da Substituição de Liskov: Confie no contrato, não na implementação específica. Caso contrário, as mudanças ocultas podem levar a dificuldades inesperadas.
    * Inversão de Dependências: crie dependências em abstrações, não em detalhes.

    Na prática, isso significa que estar vinculado a detalhes internos e não documentados da estrutura torna o sistema frágil.
    Com base em interfaces públicas e contratos, obtemos:

    * melhor isolamento do código de mudanças na estrutura;
    * facilidade de teste;
    * previsibilidade e confiabilidade da arquitetura.

    E se houver um bug?

    Acontece também que tudo é feito de acordo com as regras, mas o resultado não atende às expectativas. Os frameworks evoluem e nem sempre são perfeitos. Nesses casos:

    * Construa um exemplo mínimo que reproduza o problema.
    * Certifique-se de que apenas APIs documentadas sejam usadas.
    * Envie um relatório de bug – a equipe de desenvolvimento certamente apreciará seu trabalho e tentará ajudar.

    Se o exemplo depender de soluções alternativas, será muito mais difícil para os desenvolvedores fornecerem suporte.

    Como aproveitar ao máximo a estrutura

    *Consulte a documentação.
    * Siga os guias e recomendações dos autores.
    * Experimente a funcionalidade descrita.
    * Verifique conselhos da Internet com fontes oficiais.
    * Localize bugs respeitando os contratos-quadro.

    Conclusão

    Frameworks são ferramentas poderosas com suas próprias regras de jogo. Ao esquecê-los, corremos o risco de tornar nosso código excessivamente vulnerável. Mas todos nós queremos que os produtos criados durem muito tempo e não exijam correções urgentes após cada pequena atualização.

    Manuais e documentação são um excelente suporte que ajuda a criar soluções verdadeiramente confiáveis.

    Fontes

    https://developer.apple.com/app-store/review/guidelines/
    https://en.wikipedia.org/wiki/SOLID
    https://en.wikipedia.org/wiki/API
    https://en.wikipedia.org/wiki/RTFM

  • Construindo um aplicativo C++ SDL para iOS no Linux

    Nesta nota, descreverei o procedimento para construir um aplicativo C++ SDL para iOS no Linux, assinar um arquivo ipa sem uma assinatura paga do Apple Developer e instalá-lo em um dispositivo limpo (iPad) usando macOS sem Jailbreak.

    Primeiro, vamos instalar o conjunto de ferramentas de compilação para Linux:
    https://github.com/tpoechtrager/cctools-port

    O conjunto de ferramentas precisa ser baixado do repositório e siga as instruções no site do Godot Engine para concluir a instalação:
    https://docs.godotengine.org/ru/latest/development/compiling/cross-compiling_for_ios_on_linux.html

    No momento, você precisa baixar o Xcode dmg e copiar o SDK de lá para construir o cctools-port. Esta etapa é mais fácil de concluir no macOS; basta copiar os arquivos SDK necessários do Xcode instalado. Após a montagem bem-sucedida, o terminal conterá o caminho para o conjunto de ferramentas do compilador cruzado.
    A seguir, você pode começar a construir o aplicativo SDL para iOS. Vamos abrir o cmake e adicionar as alterações necessárias para construir o código C++:

    SET(CMAKE_SYSTEM_NAME Darwin)
    SET(CMAKE_C_COMPILER arm-apple-darwin11-clang)
    SET(CMAKE_CXX_COMPILER arm-apple-darwin11-clang++)
    SET(CMAKE_LINKER arm-apple-darwin11-ld)


    Agora você pode compilar usando cmake e make, mas não se esqueça de adicionar $PATH ao conjunto de ferramentas do compilador cruzado:

    
    PATH=$PATH:~/Sources/cctools-port/usage_examples/ios_toolchain/target/bin


    Para correta vinculação com frameworks e SDL, escrevemos eles em cmake, dependências do jogo Space Jaguar por exemplo:

    
    target_link_libraries(
    ${FSEGT_PROJECT_NAME}
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libclang_rt.ios.a
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libSDL2.a
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libSDL2_mixer.a
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libSDL2_image.a
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreServices.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/ImageIO.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/Metal.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/AVFoundation.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/GameController.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreMotion.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreGraphics.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/AudioToolbox.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreAudio.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/QuartzCore.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/OpenGLES.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/UIKit.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/Foundation.framework"
    )


    No meu caso, as bibliotecas SDL, SDL_Image, SDL_mixer são compiladas antecipadamente no Xcode no macOS para vinculação estática; Frameworks copiados do Xcode. Também foi adicionada a biblioteca libclang_rt.ios.a, que inclui chamadas de tempo de execução específicas do iOS, por exemplo isOSVersionAtLeast. Incluída macro para trabalhar com OpenGL ES, desabilitando funções não suportadas na versão mobile, semelhante ao Android.
    Depois de resolver todos os problemas de construção, você deverá obter o binário montado para arm. A seguir, vamos considerar a execução do binário montado em um dispositivo sem Jailbreak.
    No macOS, instale o Xcode, cadastre-se no portal da Apple, sem pagar pelo programa do desenvolvedor. Adicione uma conta no Xcode -> Preferências -> Contas, crie um aplicativo em branco e construa em um dispositivo real. Durante a montagem, o dispositivo será adicionado à sua conta de desenvolvedor gratuita. Após a montagem e lançamento, você precisa construir o arquivo; para fazer isso, selecione Dispositivo e produto iOS genérico -> Arquivo. Depois que o arquivo for compilado, extraia os arquivos incorporados.mobileprovision e PkgInfo dele. No log de construção do dispositivo, encontre a linha de codesign com a chave de assinatura correta, o caminho para o arquivo de direitos com a extensão app.xcent e copie-o.
    Copie a pasta .app do arquivo, substitua o binário no arquivo por um compilado por um compilador cruzado no Linux (por exemplo, SpaceJaguar.app/SpaceJaguar) e, em seguida, adicione os recursos necessários ao .app, verifique a integridade dos arquivos PkgInfo e incorporado.mobileprovision no .app do arquivo, copie novamente se necessário. Assinamos novamente o .app usando o comando codesign – codesign requer uma chave de entrada para assinar, o caminho para o arquivo de direitos (pode ser renomeado com uma extensão .plist)
    Após assinar novamente, crie uma pasta Payload, mova a pasta com a extensão .app para lá, crie um arquivo zip com Payload na raiz, renomeie o arquivo com a extensão .ipa. Depois disso, no Xcode, abra a lista de dispositivos e arraste e solte o novo ipa na lista de aplicativos do dispositivo; A instalação via Apple Configurator 2 não funciona para este método. Se a nova assinatura for feita corretamente, o aplicativo com o novo binário será instalado em um dispositivo iOS (por exemplo, iPad) com certificado de 7 dias, o que é suficiente para o período de teste.

    Fontes

    https://github.com/tpoechtrager/cctools-port

    https://docs.godotengine.org/ru/latest/development/compiling/cross-compiling_for_ios_on_linux.html

    https://jonnyzzz.com/blog/2018/06/13/link-error-3/

    https://stackoverflow.com/questions/6896029/re-sign-ipa-iphone

    https://developer.apple.com/library/archive/documentation/Security/Conceptual/CodeSigningGuide/Procedures/Procedures.html

  • Construa para Windows no Ubuntu MinGW CMake

    Neste post irei descrever o processo de construção de bibliotecas e aplicações para Windows usando o conjunto de ferramentas MinGW32 no Ubuntu.
    Instale o vinho, mingw:

    sudo apt-get install wine mingw-w64
    

    Depois disso, você já pode construir aplicativos C/C++ para Windows:

    # C
    i686-w64-mingw32-gcc helloWorld.c -o helloWorld32.exe      # 32-bit
    x86_64-w64-mingw32-gcc helloWorld.c -o helloWorld64.exe    # 64-bit
     
    # C++
    i686-w64-mingw32-g++ helloWorld.cc -o helloWorld32.exe     # 32-bit
    x86_64-w64-mingw32-g++ helloWorld.cc -o helloWorld64.exe   # 64-bit
    

    O exe coletado pode ser verificado usando vinho.
    A seguir, vamos dar uma olhada nas alterações na compilação do CMake, no arquivo CMakeLists.txt, adicionando coisas específicas do MinGW ao arquivo de compilação:

    if (MINGW32)
    set(CMAKE_SYSTEM_NAME Windows)
    SET(CMAKE_C_COMPILER i686-w64-mingw32-gcc)
    SET(CMAKE_CXX_COMPILER i686-w64-mingw32-g++)
    SET(CMAKE_RC_COMPILER i686-w64-mingw32-windres)
    set(CMAKE_RANLIB i686-w64-mingw32-ranlib)
    endif()
    
    // для сборки shared dll
    elseif (MINGW32)
    add_library(FlameSteelEngineGameToolkit.dll SHARED ${SOURCE_FILES})
    else()
    
    // обязательно линкуем со всеми зависимостями
    if (MINGW32)
    target_link_libraries(
                            FlameSteelEngineGameToolkit.dll 
                            -static-libgcc
                            -static-libstdc++
                            SDL2 
                            SDL2_mixer 
                            /home/demensdeum/Sources/cube-art-project-bootstrap/FlameSteelFramework/FlameSteelCore/FlameSteelCore.dll
                            /home/demensdeum/Sources/cube-art-project-bootstrap/FlameSteelFramework/FlameSteelBattleHorn/FlameSteelBattleHorn.dll
                            /home/demensdeum/Sources/cube-art-project-bootstrap/FlameSteelFramework/FlameSteelCommonTraits/FlameSteelCommonTraits.dll)
    
    set_target_properties(FlameSteelEngineGameToolkit.dll PROPERTIES
            PREFIX ""
            SUFFIX ""
            LINK_FLAGS "-Wl,--add-stdcall-alias"
            POSITION_INDEPENDENT_CODE 0 # this is to avoid MinGW warning; 
            # MinGW generates position-independent-code for DLL by default
    )
    else()
    

    Nós coletamos:

    cmake -DMINGW32=1 .
    make
    

    A saída será uma dll ou exe, dependendo do que você está coletando. Para um exemplo prático, você pode dar uma olhada no repositório do novo Cube-Art-Project e suas bibliotecas:
    https://gitlab.com/demensdeum/cube-art-project

    https://gitlab.com/demensdeum/FlameSteelEngineGameToolkitFSGL

    https://gitlab.com/demensdeum/cube-art-project-bootstrap

    Fontes
    https://arrayfire.com/cross-compile-to-windows-from-linux/

  • Construindo aplicativos macOS para Ubuntu OSXCross CMake

    Nesta postagem, descreverei a construção de aplicativos C++ multiplataforma para macOS em uma máquina de compilação Ubuntu usando CMake e osxcross.
    Primeiro, instale o conjunto de ferramentas osxcross:
    https://github.com/tpoechtrager/osxcross
    A instalação ocorre em 3 etapas, baixando as dependências:

    cd tools
    ./get_dependencies.sh
    

    Baixe o XCode.xip do site oficial da Apple e, em seguida, baixe o SDK do XCode:

    ./gen_sdk_package_pbzx.sh /media/demensdeum/2CE62A79E62A4404/LinuxSupportStorage/xcode111.xip
    

    Espero que você tenha lido o contrato de licença do XCode na última etapa. A seguir, construa o conjunto de ferramentas com o prefixo necessário:

    INSTALLPREFIX=/home/demensdeum/Apps/osxcross ./build.sh 
    

    Agora você pode usar osxcross do diretório de prefixos da etapa anterior. Vamos adicionar uma nova macro de construção para o CMake e escrever tudo o que for necessário:

    if (OSXCROSS)
    SET(CMAKE_SYSTEM_NAME Darwin)
    SET(CMAKE_C_COMPILER o64-clang)
    SET(CMAKE_CXX_COMPILER o64-clang++)
    SET(CMAKE_C_COMPILER_AR x86_64-apple-darwin19-ar)
    SET(CMAKE_CXX_COMPILER_AR x86_64-apple-darwin19-ar)
    SET(CMAKE_LINKER x86_64-apple-darwin19-ld)
    SET(ENV{OSXCROSS_MP_INC} 1)
    endif()
    

    A vinculação dinâmica não foi bem-sucedida para mim, então exportamos as bibliotecas estaticamente:

    if (OSXCROSS)
    add_library(FlameSteelCore STATIC ${SOURCE_FILES})
    else()
    

    Em seguida, você pode se deparar com o fato de não ter as bibliotecas necessárias para osxcross. Encontrei isso ao usar SDL2. osxcross oferece suporte a pacotes de bibliotecas prontos – macports. Por exemplo, instalando o mixer SDL2:

    osxcross-macports -v install libsdl2_mixer
    

    Depois disso, você pode começar a construir bibliotecas/aplicativos normalmente no link cmake-make, não se esqueça de especificar a vinculação estática de bibliotecas, se necessário.

    Montagem manual de bibliotecas

    Atualmente, encontrei o problema de arquivamento incorreto de bibliotecas durante a vinculação estática; ao construir o aplicativo final, recebo o erro:

    file was built for archive which is not the architecture being linked (x86_64)
    

    Muito semelhante a este ticket, conseguimos implementar uma solução alternativa que resultou na conclusão correta da compilação. Vamos descompactar a biblioteca estática e construí-la novamente usando o arquivador osxcross:

    ar x ../libFlameSteelCore.a
    rm ../libFlameSteelCore.a
    x86_64-apple-darwin19-ar rcs ../libFlameSteelCore.a *.o
    

    Além disso, um dos problemas que considero pessoalmente é a falta de capacidade de executar aplicativos macOS diretamente no Ubuntu (pelo menos com parte da funcionalidade). Claro, existe um projeto querido, mas o suporte ainda deixa muito a desejar.

    Fontes

    https://github.com/tpoechtrager/osxcross

  • Geração de imagem local: modelo ComfyUI e FLUX

    Hoje em dia, você não precisa depender de serviços em nuvem: você pode gerar imagens de alta qualidade inteiramente no seu próprio hardware. Neste post, descreverei como executar o modelo FLUX moderno localmente em seu computador usando o ComfyUI.

    ComfyUI usa arquitetura baseada em nós. Isso permite que você:
    – Controle totalmente todas as etapas da geração.
    – Compartilhe facilmente “fluxos de trabalho” prontos

    FLUX é um modelo grande, portanto os requisitos de hardware são superiores a SD 1.5 ou SDXL:
    – Placa de vídeo (GPU): Nvidia RTX com 12 GB VRAM ou superior (para um trabalho confortável). Se você tiver 8 GB ou menos, terá que usar as versões quantizadas (GGUF ou NF4).
    – Memória de acesso aleatório (RAM): mínimo 16 GB (de preferência 32 GB e superior).
    – Espaço em disco: Aproximadamente 20–50 GB para modelos e componentes.

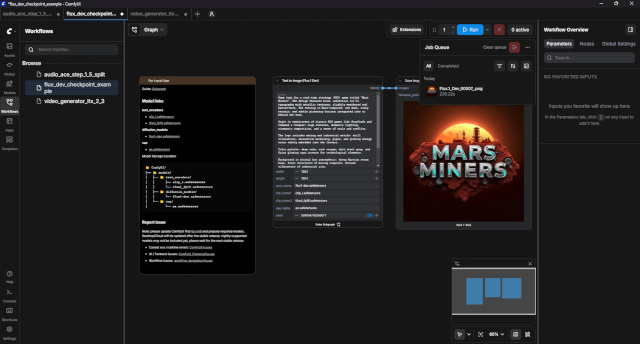
    A maneira mais fácil de iniciar o FLUX é usar um modelo pronto. Basta procurar por fluxo de texto para imagem na janela de fluxos de trabalho e instalar.

    Escreva um prompt em inglês no nó `Text to Image (Flux.1 Dev)`, selecione a resolução (FLUX funciona bem com 1024×1024 e até superior) e pressione RUN.

    A primeira geração pode demorar, pois os modelos serão carregados na memória da placa de vídeo.

    https://github.com/comfyanonymous/ComfyUI

  • Codificação local Vibe: LM Studio, VS Code e Continue

    Se você deseja usar redes neurais para ajudar a escrever código (a chamada codificação Vibe) e possui um computador bastante poderoso, por exemplo, com uma placa de vídeo Nvidia RTX, você pode implantar todo o ambiente de forma absolutamente gratuita em sua máquina. Isso resolve problemas com assinaturas pagas e permite que você trabalhe com segurança com projetos sob NDA, já que seu código não é enviado para lugar nenhum. Neste post irei descrever como montar um pacote local de LM Studio, VS Code e a extensão Continue.

    Ferramentas para codificação local do Vibe

    Para um trabalho confortável, precisamos de três componentes principais:
    – LM Studio: um aplicativo conveniente para baixar e executar LLMs locais. Assume toda a complexidade de trabalhar com modelos GGUF e disponibiliza um servidor local compatível com a API OpenAI.
    – VS Code: um editor de código popular e familiar.
    – Continue: extensão para VS Code que integra redes neurais diretamente no ambiente de trabalho. Permite conversar, destacar código para refatoração e oferece suporte ao preenchimento automático.

    Requisitos de hardware

    Os modelos de idioma local consomem muita memória:
    – Placa de vídeo (GPU): Nvidia com 8 GB VRAM ou superior (para trabalho confortável com modelos com 7 a 8 bilhões de parâmetros). Modelos mais pesados ​​exigirão 16 GB de VRAM.
    – Espaço em disco: cerca de 500 GB para armazenar vários modelos baixados.

    Configurando o link

    O processo de configuração é bastante simples e não requer manipulações complexas no terminal:
    1. Baixe e instale o LM Studio. Use a pesquisa integrada para encontrar um modelo leve como Qwen Coder ou gemma3:12b.
    2. No LM Studio, vá para a guia Servidor Local e clique em Iniciar Servidor. Por padrão, ele começará em `http://localhost:1234/v1`.
    3. Abra o VS Code e instale a extensão Continue da loja de plugins.
    4. Abra o arquivo de configuração Continue e adicione um novo modelo, especificando o provedor `openai` e o endereço do seu servidor local do LM Studio.

    Você pode então se comunicar com seu LLM local diretamente na barra lateral Continuar, fazer perguntas sobre seu código e gerar novos componentes.

    Por que isso funciona?

    Como escrevi anteriormente, os LLMs se saem melhor com estrutura plana e código WET (Write Everything Twice). Os modelos de parâmetros locais podem ser inferiores a gigantes como o GPT-4 quando se trata de projetar arquiteturas complexas, mas são mais do que capazes de gerar código padrão, refatorar funções simples e prototipagem rápida.

    Além disso, com a codificação local do Vibe, seu código nunca sai da máquina. Isso torna essa combinação ideal para desenvolvimento corporativo e trabalho com dados confidenciais.

    Saída

    As redes neurais locais não são capazes de substituir totalmente um programador ou projetar um sistema complexo. No entanto, a combinação de LM Studio + VS Code + Continue proporciona independência dos serviços em nuvem e mantém a privacidade. Esta é uma ferramenta auxiliar totalmente funcional para tarefas rotineiras, se você estiver disposto a suportar as limitações de pequenos modelos e controlar de forma independente a arquitetura do projeto.

    Links

    https://code.visualstudio.com/
    https://lmstudio.ai/
    https://continue.dev/

    Fontes

    https://youtu.be/IqqCwhG46jY
    https://www.youtube.com/watch?v=7AImkA96mE8

  • Geração de vídeo local: ComfyUI e LTX-2.3

    Anteriormente, a criação de vídeos usando redes neurais era prerrogativa de serviços em nuvem como Runway ou Luma. Hoje, se você possui uma placa gráfica Nvidia moderna, pode gerar vídeos de alta qualidade diretamente no seu computador. Neste post, vou explicar como configurar a geração de vídeo local usando ComfyUI e o modelo LTX-2.3 efetivo.

    Ferramentas para geração de vídeo

    Para trabalhar, precisaremos de:
    – ComfyUI: uma interface poderosa com uma arquitetura baseada em nós que permite personalizar de forma flexível o processo de geração.
    – LTX-2.3: Um modelo moderno da Lightricks, otimizado para criar vídeos suaves e detalhados com requisitos de memória de vídeo relativamente moderados.

    Requisitos de hardware

    Gerar vídeo é um processo que consome muito mais recursos do que trabalhar com imagens:
    – Placa de vídeo (GPU): Nvidia RTX com 8 GB VRAM é o mínimo necessário para uma resolução de 768×512. Para uma operação confortável e resoluções mais altas, é altamente desejável ter de 16 a 24 GB de VRAM.
    – Memória de acesso aleatório (RAM): mínimo 32 GB. Modelos de vídeo e VAEs ocupam muito espaço durante o download.
    – Espaço em disco: cerca de 500 GB para o próprio modelo e componentes relacionados.

    Configuração e inicialização

    O processo de lançamento do LTX-2.3 no ComfyUI é o seguinte:
    1. Atualize o ComfyUI: O modelo é relativamente novo, portanto, certifique-se de ter a versão mais recente da interface instalada.
    2. Fluxo de trabalho de instalação: A maneira mais fácil é encontrar um modelo JSON pronto para vídeo LTX. O modelo requer nós específicos para trabalhar com espaço latente de vídeo.
    3. Prompt e parâmetros: Insira uma descrição da cena em inglês. Observe que o LTX-2.3 entende bem o movimento (por exemplo, “a câmera orbita”, “movimento rápido”).

    Por que escolher LTX-2.3?

    O LTX-2.3 é notável porque oferece resultados comparáveis ​​aos serviços de nuvem proprietários, mas é executado localmente. Isso lhe dá:
    – Privacidade total: seus prompts e vídeos gerados não vão para servidores de outras pessoas.
    – Controle: você pode experimentar a taxa de quadros (FPS), a resolução e a intensidade do prompt sem ter que pagar por cada tentativa.

    A geração de vídeo local ainda está em desenvolvimento ativo e o LTX-2.3 é uma excelente entrada no mundo da “Hollywood doméstica”.

    Links

    https://github.com/comfyanonymous/ComfyUI
    https://huggingface.co/Lightricks/LTX-Video

  • Geração de música local: modelo ComfyUI e ACE-Step-1.5

    Hoje em dia, você não precisa depender de serviços em nuvem para criar conteúdo: você pode gerar música de alta qualidade inteiramente em seu próprio hardware. Neste post, descreverei como executar o modelo moderno ACE-Step-1.5 localmente em seu computador usando o ComfyUI.

    ComfyUI usa arquitetura baseada em nós. Isso permite que você:
    – Controle totalmente todas as etapas da geração de áudio.
    – Compartilhe facilmente “fluxos de trabalho” prontos.

    ACE-Step-1.5 é um modelo avançado para geração de música que requer recursos computacionais significativos. Os requisitos de hardware são superiores aos de muitos sintetizadores simples:
    – Placa de vídeo (GPU): Nvidia RTX com 8 GB VRAM ou superior (12 GB+ recomendado) para um trabalho confortável com alta qualidade.
    – Memória de acesso aleatório (RAM): mínimo 16 GB (de preferência 32 GB e superior).
    – Processador (CPU): Processador multi-core moderno com bom suporte para computação AVX/CUDA.
    – Espaço em disco: Aproximadamente 20–50 GB para modelos e componentes.

    A maneira mais fácil de executar o ACE-Step-1.5 é usar um modelo de geração de áudio pronto. Basta pesquisar texto musical em áudio na janela de fluxos de trabalho e instalar.

    Escreva um prompt descrevendo o gênero e o clima (por exemplo, “faixa de synthwave edificante com baixo pesado”) no nó `Prompt Input`. Especifique a duração desejada e pressione RUN.
    A primeira geração pode levar algum tempo, pois os modelos serão carregados na memória da placa de vídeo e processarão padrões acústicos complexos.

    https://github.com/comfyanonymous/ComfyUI
    https://www.youtube.com/watch?v=UAlLD5fS7-c

  • Redes neurais locais usando ollama

    Se você deseja lançar algo como ChatGPT e possui um computador bastante potente, por exemplo com uma placa de vídeo Nvidia RTX, então você pode executar o projeto ollama, que permitirá que você use um dos modelos LLM prontos em sua máquina local, totalmente gratuito. ollama oferece a capacidade de se comunicar com modelos LLM, na forma de ChatGPT; também na versão mais recente, foi anunciada a capacidade de ler imagens e formatar os dados de saída no formato json.

    Também executei o projeto em um MacBook com processador Apple M2 e sei que os modelos mais recentes de placas de vídeo da AMD são suportados.

    Para instalar no macOS, acesse o site da ollama:
    https://ollama.com/download/mac

    Clique em “Baixar para macOS”, você baixará um arquivo no formato ollama-darwin.zip, dentro do arquivo estará Ollama.app que precisa ser copiado para “Aplicativos”. Depois disso, inicie o Ollama.app, provavelmente o processo de instalação ocorrerá na primeira inicialização. Depois disso, na bandeja você viu o ícone ollama, a bandeja fica no canto superior direito ao lado do relógio.

    Depois disso, inicie um terminal macOS normal e digite o comando para baixar, instalar e executar qualquer modelo ollama. Uma lista de modelos disponíveis, descrições e suas características podem ser conferidas no site da ollama:
    https://ollama.com/search

    Escolha o modelo com menos parâmetros caso ele não caiba na sua placa de vídeo no lançamento.

    Por exemplo, o comando para iniciar o modelo llama3.1:latest:

    ollama run llama3.1:latest
    

    A instalação para Windows e Linux é geralmente semelhante, em um caso haverá um instalador ollama e trabalharemos posteriormente com ele via Powershell.
    Para Linux, a instalação é feita por script, mas recomendo usar a versão do seu gerenciador de pacotes específico. No Linux, ollama também pode ser iniciado através de um terminal bash normal.

    Fontes
    https://www.youtube.com/watch?v=Wjrdr0NU4Sk
    https://ollama.com

  • Estabilização de vídeo usando ffmpeg

    Se você deseja estabilizar vídeos e remover o tremor da câmera, a ferramenta `ffmpeg` oferece uma solução poderosa. Graças aos filtros integrados `vidstabdetect` e `vidstabtransform`, você pode obter resultados profissionais sem usar editores de vídeo complexos.

    Preparando-se para o trabalho

    Antes de começar, certifique-se de que seu `ffmpeg` suporta a biblioteca `vidstab`. No Linux você pode verificar isso com o comando:

    bash  
    ffmpeg -filters | grep vidstab  
    

    Se a biblioteca não estiver instalada, você poderá adicioná-la:

    sudo apt install ffmpeg libvidstab-dev  
    

    Instalação para macOS via brew:

    brew install libvidstab
    brew install ffmpeg
    

    Agora vamos passar para o processo.

    Etapa 1: análise de movimento

    Primeiro você precisa analisar o movimento do vídeo e criar um arquivo com parâmetros de estabilização.

    ffmpeg -i input.mp4 -vf vidstabdetect=shakiness=10:accuracy=15 transfile=transforms.trf -f null -  
    

    Parâmetros:

    tremor: Nível de vibração do vídeo (padrão 5, pode ser aumentado para 10 para casos mais complexos).
    precisão: Precisão da análise (padrão 15).
    transfile: Nome do arquivo para salvar os parâmetros de movimento.

    Passo 2: Aplicar Estabilização

    Agora você pode aplicar a estabilização usando o arquivo de transformação:

    ffmpeg -i input.mp4 -vf vidstabtransform=input=transforms.trf:zoom=5 output.mp4
    

    Parâmetros:

    input: Aponta para o arquivo com parâmetros de transformação (criados na primeira etapa).
    zoom: Fator de zoom para remover bordas pretas (por exemplo, 5 – zoom automático até que os artefatos sejam removidos).

  • Máquinas de computação de Turing

    Apresento a sua atenção uma tradução das primeiras páginas do artigo de Alan Turing “ON COMPUTABLE NUMBERS WITH AN APPLICATION TO THE PROBLEM OF RESOLUTION” de 1936. Os primeiros capítulos contêm uma descrição dos computadores, que mais tarde se tornaram a base da computação moderna.

    A tradução completa do artigo e a explicação podem ser lidas no livro do popularizador americano Charles Petzold, intitulado “Reading Turing: A Journey through Turing’s Historical Article on Computability and Turing Machines” (ISBN 978-5-97060-231-7, 978-0-470-22905-7)

    Artigo original:
    https://www.astro.puc.cl/~rparra/tools/PAPERS/turing_1936.pdf

    SOBRE NÚMEROS COMPUTÁVEIS COM APLICAÇÃO AO PROBLEMA DE RESOLUÇÃO

    AM TURING

    [Recebido em 28 de maio de 1936 – lido em 12 de novembro de 1936]

    Os números “computáveis” podem ser brevemente descritos como números reais cujas expressões como frações decimais são calculáveis ​​de um número finito de maneiras. Embora à primeira vista este artigo trate os números como computáveis, é quase tão fácil definir e explorar funções computáveis ​​de uma variável inteira, uma variável real, uma variável computável, predicados computáveis ​​e similares. Contudo, os problemas fundamentais associados a estes objetos computáveis ​​são os mesmos em cada caso. Para uma consideração detalhada, escolhi números computáveis ​​como objeto computável porque o método de considerá-los é o menos complicado. Espero descrever em breve a relação entre números computáveis ​​e funções computáveis ​​e assim por diante. Paralelamente, serão realizadas pesquisas no campo da teoria das funções de uma variável real expressa em termos de números computáveis. Pela minha definição, um número real é computável se a sua representação decimal puder ser escrita por uma máquina.

    Nos parágrafos 9 e 10 apresento alguns argumentos para mostrar que os números computáveis ​​incluem todos os números que são naturalmente considerados computáveis. Em particular, mostro que algumas grandes classes de números são computáveis. Incluem, por exemplo, as partes reais de todos os números algébricos, as partes reais dos zeros das funções de Bessel, os números π, e e outros. No entanto, os números computáveis ​​não incluem todos os números definíveis, como evidenciado pelo seguinte exemplo de um número definível que não é computável.

    Embora a classe dos números computáveis ​​seja muito grande e em muitos aspectos semelhante à classe dos números reais, ela ainda é enumerável. No §8 considero certos argumentos que parecem argumentar o contrário. Quando um destes argumentos é aplicado corretamente, tiram-se conclusões que, à primeira vista, são semelhantes às de Gödel*. Esses resultados têm aplicações extremamente importantes. Em particular, como mostrado abaixo (§11), o problema de resolução não pode ter solução.

    Num artigo recente, Alonzo Church introduziu a ideia de “calculabilidade efectiva”, que é equivalente à minha ideia de “computabilidade”, mas tem uma definição completamente diferente. Church também chega a conclusões semelhantes em relação ao problema da resolução. A prova da equivalência entre “computabilidade” e “efetivamente calculável” é apresentada no apêndice deste artigo.

    1. Computadores

    Já dissemos que números computáveis ​​são aqueles números cujas casas decimais são contáveis ​​por meios finitos. Uma definição mais clara é necessária aqui. Este artigo não fará nenhuma tentativa real de justificar as definições aqui dadas até chegarmos ao §9. Por enquanto, observarei apenas que a justificativa (lógica) (para isso) é que a memória humana é, por necessidade, limitada.

    Comparemos uma pessoa no processo de cálculo de um número real com uma máquina que é capaz de cumprir apenas um número finito de condições q1, q2, …, qR; Vamos chamar essas condições de “m-configurações”. Esta máquina (isto é, assim definida) está equipada com uma “fita” (análoga ao papel). Esta correia que passa pela máquina é dividida em seções. Vamos chamá-los de “quadrados”. Cada um desses quadrados pode conter algum tipo de “símbolo”. Em qualquer momento, existe apenas um desses quadrados, digamos o enésimo, contendo o símbolo que está “nesta máquina”. Vamos chamar esse quadrado de “símbolo digitalizado”. Um “caractere digitalizado” é o único caractere do qual a máquina está, por assim dizer, “diretamente consciente”. No entanto, ao alterar sua configuração m, a máquina pode efetivamente lembrar alguns dos caracteres que “viu” (digitalizou) anteriormente. O possível comportamento da máquina a qualquer momento é determinado pela configuração m qn e pelo símbolo digitalizado***. Vamos chamar esse par de símbolos de qn, “configuração”. A configuração assim designada determina o comportamento possível de uma determinada máquina. Em algumas dessas configurações em que o quadrado digitalizado está em branco (ou seja, não contém nenhum caractere), a máquina escreve um novo caractere no quadrado digitalizado e em outras configurações apaga o caractere digitalizado. Esta máquina também é capaz de se mover para escanear outro quadrado, mas desta forma só pode se mover para o quadrado adjacente à direita ou à esquerda. Além de qualquer uma destas operações, a configuração m da máquina pode ser alterada. Neste caso, alguns dos caracteres escritos formarão uma sequência de dígitos, que é a parte decimal do número real que está sendo calculado. O restante nada mais será do que marcas imprecisas para “ajudar a memória”. Neste caso, apenas as marcas imprecisas acima mencionadas podem ser apagadas.

    Afirmo que as operações aqui consideradas incluem todas as operações usadas no cálculo. A justificativa para esta afirmação é mais fácil de entender para o leitor que conhece a teoria das máquinas. Portanto, na próxima seção continuarei a desenvolver a teoria em questão, com base na compreensão do significado dos termos “máquina”, “fita”, “digitalizado”, etc.

    *Gödel “Sobre as Sentenças Formalmente Indecidíveis dos Principia Mathematics (publicado por Whitehead e Russell em 1910, 1912 e 1913) e Sistemas Relacionados, Parte I,” Journal of Mathematics. Física, boletim mensal em alemão nº 38 (para 1931, pp. 173-198.
    ** Alonzo Church, “Um problema indecidível na teoria elementar dos números”, American J. of Math., No.
    *** Alonzo Church, “Uma nota sobre o problema da resolução”, J. of Symbolic Logic, No. 1 (1936), pp.