Category: Notes

  • Strata – 您计算机上强大的人工智能

    Strata 是一个开源引擎,用于在商用硬件上运行大型语言模型。该项目有一个简单的目标:让强大的模型在本地运行,无需云,无需帐户,无需支付代币。安装减少为一个安装程序,启动后您可以聊天、使用代码,甚至在计算机上接收图像。

    在底层,Strata 拥有自己的推理引擎,并在外部在本地地址公开与 OpenAI 和 Anthropic 兼容的 API。这意味着您可以将您最喜欢的工具连接到它 – Claude Code、Codex CLI、OpenCode 和其他代理 – 他们会认为他们正在与云提供商交谈。数据不会离开您的机器。

    在这篇文章中,我将详细介绍 Strata 的功能、支持哪些型号、如何安装以及如何将其连接到您的仪器。

    这是什么

    Strata 是 MIT 许可下的免费项目。它解决了三个问题:

    • 本地启动模型。该引擎专为消费类视频卡和组合内存而设计,而不是为服务器加速器而设计。
    • 单一接口。从外部来看,这是本地主机上兼容 OpenAI 和 Anthropic 的 API,因此几乎所有可以使用这些协议的东西都可以连接。
    • 简单。桌面应用程序和终端安装程序从源中消除了依赖项、驱动程序和程序集的工作。

    另外,值得注意的是图像的可选输入。该模型不仅可以处理文本,还可以处理图片,这使得本地聊天对于解析屏幕截图和文档更加有用。

    模型

    主要推荐的项目是Qwen3.8-Flash-Next。不同的供应商为其提供了几种量化集:

    • ISTA-DASLab – 推荐选项:Q2_0、IQ2_XS、IQ3_XXS、IQ3_S,以及单独的编码器 IQ1_M。
    • 不懒惰 – UD-IQ4_XS、UD-Q4_K_XL、UD-Q5_K_XL、UD-Q6_K_XL、Q8_0。
    • 来自agentionai的陀螺仪 – Gyro-S和Gyro-M:内存更少,但速度较慢。

    除旗舰型号外,还支持Qwen3.6-35B-A3B和DeepSeekV4.1-Flash-1017。后者很有趣,因为模型中不适合内存的部分是直接从 SSD 读取的,因此需要大量可用磁盘空间。有 239、257 和 274 GB 的选项,以及大约 191 GB 的轻量级 Coder 版本,其中一半的专家已被删除。

    从终端启动 DeepSeek 如下所示:

    strata launch --family deepseek41 --model ist-das-2.00bpw --plan
    

    –plan 标志显示下载开始之前的启动计划。对于大型集合,这很有用:您可以立即看到需要多少内存和磁盘。

    硬件要求

    Strata 支持多种设备:

    • NVIDIA GeForce RTX 20、30、40 和 50 系列。
    • AMD Radeon RX 7700、7800、7900、RX 9060、9070 和 AI PRO R9700。
    • AMD Radeon RX 6800 和 6900 – 实验性。
    • 适用于 Linux 的英特尔 Arc。
    • Apple Silicon,来自 M1 及更新版本。
    • AMD Ryzen AI Max(Strix Halo)。
    • 适用于 Linux 的 NVIDIA DGX Spark。

    作为参考,以下是 DeepSeekV4.1-Flash 在 2.00 bpw 装置上的一些测量结果。在“输出”列中 – 生成响应的速度,在“提示”列中 – 读取输入的速度。

    • RTX 5070 12 GB、64 GB RAM – 4–6 个令牌/秒,提示约 110 个令牌/秒。
    • RTX 3060 12 GB、46 GB RAM – 9–11 个令牌/秒,提示约 155 个令牌/秒。
    • 1x Radeon AI PRO R9700,251 GB RAM – 21–25 个令牌/秒,提示 320–360 个令牌/秒。
    • 4x Radeon AI PRO R9700 – 74–77 个令牌/秒,提示 400–450 个令牌/秒。
    • Ryzen AI Max+ 395 (Strix Halo),128 GB 组合内存 – 代码上每秒 19–21 个令牌,聊天上每秒 11 个令牌。

    如果您不确定什么适合,该项目有一个单独的指南,用于根据内存量选择型号。

    安装桌面应用程序

    最简单的方法是从发布页面下载现成的安装程序。每个系统都有自己的文件:

    Strata-0.2.13-windows-x64-setup.exe
    Strata-0.2.13-linux-x86_64.AppImage
    Strata-0.2.13-macos-arm64.dmg
    

    安装应用程序,选择型号并开始通信。当您首次启动该应用程序时,它会自动下载适用于您的视频卡的引擎。无需单独配置驱动程序或从源代码编译任何内容。

    在应用程序窗口中,聊天、文件和实时代码预览位于附近,这在处理项目时很方便。

    在终端中安装

    如果您更喜欢控制台,请使用安装脚本安装 Strata,然后运行 ​​strata launch 命令。

    在 Linux 和 macOS 上:

    curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh && sh install.sh
    

    在 Windows PowerShell 中:

    irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex
    

    在 Windows 上安装后,打开一个新的终端窗口并运行:

    strata launch
    

    该程序将提出问题,下载所需的模型并启动它。在运行过程中,会显示模型的活动、速度、内存消耗和最新请求 – 方便了解硬件发生的情况。

    对于那些想要自己构建所有内容的人,可以从源代码构建、通过 Docker 的选项和详细的安装指南。

    连接仪器

    Strata 的主要优势在于它公开了与 OpenAI 和 Anthropic 兼容的本地 API。因此,流行的代理工具可以连接到它:Claude Code、Codex CLI、OpenCode、oh-my-pi、pi.dev、Hermes Agent、OpenClaw等。

    要了解如何配置特定工具,只需运行:

    strata connect
    

    The team will show ready-made instructions for your application.然后一切都与常规云提供商相同:本地端点 Strata 被指定为基地址,引擎生成的内容被指定为密钥。 No Internet is required for inference.

    需要注意什么

    在本地运行是一种权衡,值得提前了解。

    • 速度取决于硬件。在较弱的显卡上,大型模型的响应速度会很慢,尤其是从磁盘读取部分权重时。上面的测量给出了一个粗略的想法。
    • 模型仍然很大。磁盘和内存是主要限制因素。 DeepSeek 需要数百 GB 的可用空间。
    • 量化质量。高度压缩的集可节省内存,但可能会降低质量。如果您的硬件允许,请选择更高 bpw 的选项。
    • 初始下载。首次启动时,引擎和模型权重都会下载,因此您需要稳定的连接和磁盘空间。

    同时,您可以获得完全控制:没有限制、订阅或数据泄漏。一切都取决于您的机器。

    这是给谁的?

    如果您想将工作数据保留在本地、不依赖云计划,或者只是想尝试本地人工智能,那么 Strata 是有意义的。对于程序员来说,这也是将熟悉的代理连接到附近工作的模型的一种方法,没有网络延迟,也无需为每个请求付费。

    该项目正在积极开发:数以万计的star、数千个fork、频繁的发布以及每种类型硬件的详细文档。最简单的开始方法是使用桌面应用程序,然后,如果您愿意,可以转到终端并连接您的工具。

    链接

    https://github.com/niko1221/strata
    https://github.com/Niko1221/Strata/releases/latest
    https://github.com/Niko1221/Strata/blob/main/docs/INSTALL.md
    https://github.com/Niko1221/Strata/blob/main/docs/MODELS.md
    https://github.com/Niko1221/Strata/blob/main/docs/TERMINAL_LAUNCH.md
    https://github.com/Niko1221/Strata/blob/main/docs/DEEPSEEK41.md
    https://github.com/Niko1221/Strata/blob/main/docs/HOW_IT_WORKS.md
    https://github.com/Niko1221/Strata/blob/main/docs/TROUBLESHOOTING.md

    来源

    https://github.com/niko1221/strata
    https://github.com/Niko1221/Strata/blob/main/README.md
    https://github.com/Niko1221/Strata/blob/main/docs/INSTALL.md
    https://github.com/Niko1221/Strata/blob/main/docs/MODELS.md
    https://github.com/Niko1221/Strata/blob/main/docs/DEEPSEEK41.md
    https://github.com/Niko1221/Strata/blob/main/docs/AMD_HIP.md
    https://github.com/Niko1221/Strata/blob/main/docs/STRIX_HALO.md
  • REA 和 OpenCode:安装和初步调查

    REA(逆向工程任何东西)是一种 MCP 服务器,可让您实时对软件应用程序、二进制文件和行为进行逆向工程。该工具涵盖了从应用程序行为到机器代码的路径,并且可以方便地使用OpenCode作为管理它的代理。

    OpenCode 是一个位于终端中的开放编程代理。它读取项目文件、编辑代码、运行命令和测试,最重要的是,它开箱即用地支持 MCP,因此 REA 可以直接连接到它。

    REA 的独特之处

    REA 在逆向工程领域脱颖而出,全面支持多种平台和分析类型:

    • 本机二进制文件:用于反汇编和反编译的 Hopper、Ghidra、IDA 或 Kuna
    • JavaScript 应用程序和 Electron:Electron 模块、导入和边界的静态分析
    • 托管代码:分析 .NET 程序集
    • 实时分析:监控进程行为
    • 网络流量:捕获和分析 HTTP/S 请求和响应
    • 移动应用程序:分析 Android 和 iOS 的 APK 和 IPA 文件
    • 嵌入式软件:嵌入式系统和物联网设备分析
    • 模型文件:提取 GGUF 和安全张量元数据
    • GPU 代码对象:CUDA 和 HIP 内核分析
    • 保存游戏:恢复游戏逻辑和可执行文件

    基本架构和哲学

    REA 遵循三步研究流程,使开发人员能够进行逆向工程:

    1. 检查:REA 连接到分析工具并检查目标(二进制文件、应用程序、网站)
    2. 分析:跟踪代码,确定规则和行为
    3. 恢复:代理使用结果来解释行为并构建或测试实现

    这个过程允许AI代理回答复杂的问题,例如:“了解Notes应用程序中的搜索如何工作,向我展示证据,并为我的项目创建类似的功能。”

    实际使用示例

    1。移动应用分析

    REA 可以分析 Android APK 文件进行恢复:

    • 清单中的声明和权限;
    • 类方法和依赖项;
    • 指向本机库的链接;
    • 网络端点和数据流。

    例如,对 Aegis Authenticator 的分析显示了六位授权代码如何每 30 秒更改一次:它检查了基于时间的代码生成 (TOTP) 的工作原理。

    2。桌面应用功能提取

    对 Windows 计算器中 % 按钮的分析展示了 REA 的功能:

    • 根据上下文定义不同的行为(+ 或 × 之后);
    • 解析汇编指令以理解逻辑;
    • 提取并解释数学运算;
    • 恢复规则:“+之后:第一个数字的10%”和“×之后:将10%转换为0.1。”

    3。恢复Web应用程序API

    REA 可以记录浏览器会话并将其重建为 RL 环境,其中 AI 代理执行诸如处理文件夹之类的任务,而无需运行原始应用程序。

    4。恢复游戏逻辑

    DX-Ball 案例展示了 REA 如何通过逆向工程 C 代码来恢复 1996 年 Windows 游戏的声景计算,该代码运行了 3,205 个测试用例并与原始编译代码相匹配。

    技术能力

    本机分析

    • 与 Hopper、Ghidra、IDA 或 Kuna 配合使用,进行深度二进制文件分析
    • 支持 ELF、PE、Mach-O 等可执行文件格式
    • 提取伪代码、汇编程序、符号和调用
    • 无需启动原始工具即可执行离线分析

    JavaScript 分析

    • 分析 Node.js 和 Electron 应用程序
    • 跟踪模块导入和依赖项
    • 通过浏览器连接实时捕获行为
    • Извлекает source maps и минифицированный код

    安全

    • PE 证书的静态分析(Authenticode)
    • 防御机制分析(PIE、NX、RELRO、CFG)
    • 映射导入和 DLL
    • 崩溃报告分析 (Apple IPS)

    REA 返回什么

    REA不会无缘无故地给代理人现成的结论。每个查询的结果都是调查结果及其所依据的证据。根据目的,响应包括:

    • 代码链接 – 实现所研究功能的特定文件和行。
    • 伪代码和汇编器 – 用于本机二进制文件:反编译函数、指令和调用之间的连接。
    • 应用程序结构 – 适用于 JavaScript 和 Electron:模块、导入、路由、IPC 以及与本机插件的连接。
    • 元数据和事实 – 清单、证书、签名、格式标头和其他静态数据。
    • 限制 – 无法解决的地方,并附有关于到底什么仍然未知的注释。

    代理使用这些数据来解释行为、回答澄清问题或组装和测试其实现。正是证据的存在和明确的限制将 REA 结果与模型的简单猜测区分开来。

    开始之前

    假设已经安装了 OpenCode 并且模型已连接到它。 REA 本身需要 Node.js 22.23.4+、24.22.1+ 或 26.12.1+,因此请检查版本:

    node -v
    

    第 1 步:将 REA 连接到 OpenCode

    REA 在 OpenCode 中注册为 MCP 服务器。在终端中运行:

    npx rea-agents@latest setup
    

    要直接指定 OpenCode,请使用其标识符 opencode:

    npx rea-agents@latest setup --client opencode
    

    设置的作用:

    • 将 REA 注册为 MCP 服务器;
    • 添加工作流程说明;
    • 制作现有配置的备份副本;
    • 在应用更改之前要求确认。

    重点:
    对于第一个实验,您可以跳过可选的 Hopper 安装。设置完成后,重新启动 OpenCode:退出会话并再次运行 opencode。

    检查连接:

    npx -y rea-agents@latest doctor --client opencode --json
    

    成功结果:"healthy": true。

    然后询问代理:

    “检查 REA 是否已连接,并告诉我您可以使用哪些 REA 工具。”

    第 2 步:首次调查

    REA 可以在不启动应用程序的情况下分析它们。

    1. 下载示例:
      Download https://rea.tools/examples/notes-example.zip
      

      将存档解压到 notes-example.

    2. 文件夹中

    3. 为代理分配任务:

      “使用 REA 检查 /absolute/path/to/notes-example 处的应用程序。了解当我单击“导出笔记”时会发生什么。显示notes.csv 的写入位置、包含哪些字段以及相关文件和行。”

    预期响应:

    “按钮发送 notes:export 消息。主进程将注释格式化为 CSV 并将 notes.csv 写入用户的下载文件夹中。列是 id 和 title。”

    第3步:Ghidra安装和原生分析

    为了分析本机二进制文件(可执行文件和库),REA 使用分析提供程序。最实惠的免费选项是 NSA 的 Ghidra。该工具在运行 REA 的计算机上安装一次。

    你需要什么

    • 64 位 JDK 21 或更高版本,包括 Java 编译器 (javac)。
    • 发布页面上的 Ghidra 存档。

    安装

    1. 安装 64 位 JDK 21 或更高版本。选择适合您的计算机架构的软件包。
    2. 从发布页面的资产列表中下载 Ghidra 并解压缩 ghidra_…_PUBLIC_….zip 存档。获取发布存档,而不是“源代码”。
    3. 找到包含 ghidraRun 或 ghidraRun.bat 的解压文件夹。 GHIDRA_INSTALL_DIR 变量需要此路径。

    看看Java。第一个命令打印 java.home – JAVA_HOME 需要此路径。第二个确认编译器已安装:

    java -XshowSettings:properties -version
    javac -version
    

    Ghidra 连接

    Windows(PowerShell):

    $env:GHIDRA_INSTALL_DIR = "C:/tools/ghidra_12.1.4_PUBLIC"
    $env:JAVA_HOME = "C:/tools/jdk-21"
    npx -y rea-agents@latest doctor --provider ghidra --json
    npx -y rea-agents@latest setup
    

    macOS / Linux:

    export GHIDRA_INSTALL_DIR="/absolute/path/to/ghidra_12.1.4_PUBLIC"
    export JAVA_HOME="/absolute/path/to/jdk-21"
    npx -y rea-agents@latest doctor --provider ghidra --json
    npx -y rea-agents@latest setup
    

    将路径替换为您自己的路径。将命令保留在一个终端会话中:设置环境变量后,重新运行安装程序,确认配置更新并重新启动 OpenCode。

    提供商检查应返回成功的报告:

    npx -y rea-agents@latest doctor --provider ghidra --json
    

    原生分析示例

    为代理提供可执行文件的完整路径并指定提供程序:

    “使用 REA 和已配置的提供程序来探索 /absolute/path/to/program。列出函数和行,然后解释处理用户输入的部分,并参考代码。”

    或者直接从终端运行命令:

    npx -y rea-agents@latest function "/absolute/path/to/program" main --provider ghidra --json
    

    将 main 替换为目标程序函数列表中的函数名称或地址。结果包含伪代码、汇编程序和调用之间的引用。

    另一类软件分析

    选择目标软件类别:

    • JavaScript / Electron – 需要 Node.js 和 npm。 指南。
    • 网站 – 需要 Chrome、Chromium 或 Edge 浏览器。 指南。
    • Android APK – 需要 JADX 和 JDK 17+。 手册。
    • 本机可执行文件 – 需要 Hopper、Ghidra 或 IDA。 指南。
    • .NET 程序集 – 需要 Node.js 和 npm。 手册。

    从终端使用 REA

    JavaScript/Electron 应用程序的静态分析

    npx -y rea-agents@latest analyze-javascript-application "/absolute/path/to/app" --json
    

    将路径替换为包含应用程序或 .asar 文件的文件夹。

    在哪里可以找到 Electron 应用程序 .asar 文件:

    • Windows: C:\Users\<you>\AppData\Local\Programs\<App>\resources\app.asar
    • macOS: /Applications/<App>.app/Contents/Resources/app.asar
    • Linux: /opt/<App>/resources/app.asar

    全局安装rea命令

    npm install --global rea-agents
    

    此后,rea –help 命令可用。

    通过curl安装(macOS / Linux)

    curl -fsSL https://raw.githubusercontent.com/morluto/rea/main/install.sh | bash
    

    安装后,按照说明配置代理。如果未出现设置菜单,请运行rea setup。

    更新和删除

    REA 更新

    npx rea-agents@latest setup
    

    对于全局安装:rea update

    删除 REA

    npx rea-agents@latest uninstall
    

    获取帮助

    典型问题

    OpenCode 没有看到 REA

    设置后重新启动 OpenCode。使用doctor命令测试连接:

    npx -y rea-agents@latest doctor --client opencode --json
    

    提供商需要配置

    对于 Ghidra 运行:

    npx -y rea-agents@latest doctor --provider ghidra --json
    

    该报告将显示失败的测试和建议的下一步。

    Windows、WSL 和带空格的路径

    • 对 Windows 客户端使用 PowerShell
    • 如果代理在 WSL 内运行,请在该 Linux 系统内安装 Node.js 和 REA 并使用 Linux 路径
    • 在终端中,将带有空格的路径用引号引起来

    在 macOS 上设置 Hopper

    如果 macOS 要求您允许自动化,请在系统偏好设置中允许运行 REA 的应用程序:系统偏好设置 → 隐私和安全 → 自动化,然后重试。

    链接

    https://github.com/morluto/rea
    https://rea.tools/
    https://rea.tools/get-started/
    https://rea.tools/guides/
    https://opencode.ai/
    https://opencode.ai/docs/
    https://opencode.ai/docs/mcp-servers/

  • DemensDeum Telegram 频道:软件、游戏和 vivicoding

    博客和网站并不是发布笔记和新闻的唯一地方。大多数材料会立即出现在 Telegram 中:更方便地接收有关新帖子、版本和流的通知,并且您还可以直接在聊天中提出问题。现在该项目有三个站点,每个站点都有自己的角色。在这篇文章中,我将简要告诉您发布的内容以及您应该在哪里订阅。

    DemensDeum – 软件和游戏

    这是主要的俄语频道。以下是新博客文章和程序发布的公告:本地图像、视频和音乐生成器、用于处理视频和音乐的工具、Flutter 和 React Native 中的应用程序,以及来自 Donki Hills 和 Flame Steel 等游戏的新闻。如果您正在阅读俄语博客并且不想手动检查该网站,这是确保您不会错过任何内容的最简单方法。

    https://t.me/demensdeum_channel

    DemensDeum – 软件与游戏

    这是主频道的英文版。此处重复了相同的公告,但将文章和说明翻译成英文。该频道对于那些更喜欢用英语阅读的人以及那些想要与英语受众分享材料的人来说非常有用:每个条目都有一个指向该帖子相应英文版本的链接。

    https://t.me/demensdeum_channel_en

    Vibecoding 聊天

    用于讨论人工智能开发的独立平台。在这里您可以询问当地的模型和代理,分享您使用OpenCode、Claude Code、DeepSeek等工具的经验,讨论vibecoding的设置、提示和陷阱。这不是一个发布公告的频道,而是一个聊天频道:沟通、提问和交流调查结果。

    https://t.me/justvibecode

    选择什么

    如果您只需要俄语的新闻和发布,主频道就足够了。如果您以英语阅读或运行英语项目,请订阅英语版本。如果您对人工智能开发的实时讨论感兴趣,而不仅仅是公告,请访问振动编码员聊天室。频道之间并不完全重复,所以最完整的体验是主频道加聊天。

    链接

    https://t.me/demensdeum_channel
    https://t.me/demensdeum_channel_en
    https://t.me/justvibecode
    https://demensdeum.com/

  • DeepSeek 上 OpenCode 中的 MCP:如何连接外部工具

    MCP(模型上下文协议)是一种开放协议,描述如何将外部工具和数据源连接到语言模型:文件系统、文档、任务跟踪器、错误跟踪器或您自己的服务。您无需将每个工具嵌入到代理中,而是设置一个单独的 MCP 服务器,然后代理根据标准方案与其进行通信。

    OpenCode 支持开箱即用的 MCP:本地服务器(由子进程启动)和远程服务器(可通过 HTTP 访问)。重要的一点是,整个MCP层是在OpenCode本身一侧实现的,而不是在模型提供者一侧实现的。因此,DeepSeek 在请求中将 MCP 工具作为正常功能接收,不需要了解协议本身的任何信息。

    在这篇文章中,我将介绍如何添加本地和远程服务器、如何获得授权、如何不被令牌淹没,以及使用 DeepSeek 模型时要考虑的事项。

    你需要什么

    要工作,你需要三样东西:

    • 已安装 OpenCode。如果尚未配置代理,我会在单独的说明中讨论安装和连接 DeepSeek 的过程。
    • Node.js 和 npx。对于本地 MCP 服务器是必需的,它们作为 npm 包分发。
    • 访问密钥。仅适用于需要授权的远程服务器。像 Context7 这样的公共服务器无需密钥即可工作,但限制较低。

    它是如何工作的

    服务器在 mcp 块中的 OpenCode 配置中进行描述。每个服务器都有一个唯一的名称,可以通过该名称在请求中提及它。服务器工具使用此名称前缀注册,因此不同服务器之间不会发生冲突。

    连接后,MCP 工具以及内置工具可供模型使用:读取文件、编辑代码和运行命令。从 DeepSeek 的角度来看,这些是代理可以调用​​的普通函数 – 这就是该捆绑包在模型 API 端无需任何 MCP 支持的情况下工作的原因。

    本地服务器

    熟悉该机制的最简单方法是测试服务器@modelcontextprotocol/server-everything。让我们将其添加到项目根目录中的 opencode.json 文件中:

    {
      "$schema": "https://opencode.ai/config.json",
      "mcp": {
        "mcp_everything": {
          "type": "local",
          "command": ["npx", "-y", "@modelcontextprotocol/server-everything"]
        }
      }
    }
    

    command 字段是服务器启动命令及其数组形式的参数。重新启动 OpenCode 后,这些工具将出现在会话中,并且可以明确要求:

    используй инструмент mcp_everything, чтобы сложить 3 и 4
    

    本地服务器还有几个更有用的字段。 environment 设置进程环境变量,cwd – 工作目录,timeout – 请求超时(以毫秒为单位),enabled 允许您临时禁用服务器而不将其从配置中删除。

    远程服务器

    远程服务器更方便:您不需要在本地运行任何内容,并且可以通过 URL 访问它们。 Context7 就是一个很好的例子,它会查找最新的库文档。它无需密钥即可连接:

    {
      "$schema": "https://opencode.ai/config.json",
      "mcp": {
        "context7": {
          "type": "remote",
          "url": "https://mcp.context7.com/mcp"
        }
      }
    }
    

    如果您有免费的 Context7 帐户,关键是提高限制。标头通过 headers 块传输,将密钥本身保存在环境变量中很方便:

    {
      "$schema": "https://opencode.ai/config.json",
      "mcp": {
        "context7": {
          "type": "remote",
          "url": "https://mcp.context7.com/mcp",
          "headers": {
            "CONTEXT7_API_KEY": "{env:CONTEXT7_API_KEY}"
          }
        }
      }
    }
    

    {env:NAME} 构造在加载配置时替换环境变量的值,因此密钥不会最终出现在存储库中。在启动代理之前,必须在终端中导出变量。

    另一个有用的公共服务器是 Vercel 的 Grep,在 GitHub 上搜索代码示例:

    {
      "$schema": "https://opencode.ai/config.json",
      "mcp": {
        "gh_grep": {
          "type": "remote",
          "url": "https://mcp.grep.app"
        }
      }
    }
    

    通过 OAuth 授权

    某些远程服务器需要 OAuth。 OpenCode 本身可以经历这个场景:它注意到 401 响应,触发授权并保存令牌。对于 Sentry,只需指定服务器:

    {
      "$schema": "https://opencode.ai/config.json",
      "mcp": {
        "sentry": {
          "type": "remote",
          "url": "https://mcp.sentry.dev/mcp",
          "oauth": {}
        }
      }
    }
    

    之后,可以手动启动授权 – 浏览器将打开:

    opencode mcp auth sentry
    

    服务命令在日常工作中也很有用。 opencode mcp list 显示服务器和授权状态,opencode mcp logout 删除存储的令牌,opencode mcp debug 检查特定服务器的网络连接和 OAuth 发现。令牌本地存储在文件 ~/.local/share/opencode/mcp-auth.json 中。

    如果服务器不使用 OAuth,而是使用常规 API 密钥,则应禁用自动授权,否则 OpenCode 将尝试在不需要的地方传递 OAuth:

    {
      "$schema": "https://opencode.ai/config.json",
      "mcp": {
        "my-api-key-server": {
          "type": "remote",
          "url": "https://mcp.example.com/mcp",
          "oauth": false,
          "headers": {
            "Authorization": "Bearer {env:MY_API_KEY}"
          }
        }
      }
    }
    

    工具管理

    MCP 工具使用上下文:每个服务器将其功能的描述添加到请求中。因此,最好关闭很少需要的服务器。这可以通过 tools 块全局完成:

    {
      "$schema": "https://opencode.ai/config.json",
      "mcp": {
        "my-mcp-foo": {
          "type": "local",
          "command": ["npx", "-y", "my-mcp-command-foo"]
        },
        "my-mcp-bar": {
          "type": "local",
          "command": ["npx", "-y", "my-mcp-command-bar"]
        }
      },
      "tools": {
        "my-mcp*": false
      }
    }
    

    my-mcp* 模板禁用名称以此前缀开头的所有工具。如果有很多服务器,则更有意义的是全局禁用它们并为特定代理在本地启用它们:

    {
      "$schema": "https://opencode.ai/config.json",
      "mcp": {
        "my-mcp": {
          "type": "local",
          "command": ["npx", "-y", "my-mcp-command"],
          "enabled": true
        }
      },
      "tools": {
        "my-mcp*": false
      },
      "agent": {
        "my-agent": {
          "tools": {
            "my-mcp*": true
          }
        }
      }
    }
    

    DeepSeek 功能

    与 DeepSeek 的连接之所以有效,是因为模型支持调用函数,并且它们的 MCP 工具看起来像普通函数。 DeepSeek 本身不连接 MCP 服务器,也不应该连接:连接由 OpenCode 处理。

    您应该注意什么:

    • 选择模型。对于常规和小型编辑,deepseek-flash 就足够了。对于需要在头脑中保留大量上下文并仔细选择工具的任务,最好使用 deepseek-v4-pro。
    • 上下文大小。 像 GitHub MCP 这样的重型服务器会添加大量令牌,再加上大型项目,很容易达到限制。仅在特定任务期间打开它们。
    • 成本工具架构随每个请求一起发送,因此包含的服务器越多,每次迭代的成本就越高。您直接向提供商付款,因此额外的服务器费用会在您的账单上显而易见。
    • 对代理的提示。不要依赖模型的独创性,而是直接在请求中命名服务器或在 AGENTS.md 中编写规则会更安全。

    AGENTS.md 的规则示例,以便代理本身访问所需的源:

    Когда нужно посмотреть документацию библиотеки, используй инструменты context7.
    

    实用食谱

    对于日常工作,两台服务器通常就足够了:Context7 用于文档,一台窄服务器用于特定任务 – 例如,用于分析错误的 Sentry 或用于搜索代码示例的 Grep。最好将其余部分关闭并根据需要打开。

    我的过程如下:我将服务器添加到 opencode.json,重新启动 OpenCode,通过 opencode mcp list 检查列表,然后提出一个明确提及服务器的测试问题。如果未调用该工具,我会查看 opencode mcp debug 和超时 – 缓慢的服务器可能没有时间在分配的 30 秒内响应。

    需要注意什么

    几个实际要点。 MCP 服务器是受信任的代码:本地服务器以您的权限在您的计算机上运行,​​并且您将请求数据发送到远程服务器。因此,从 Internet 安装随机服务器时应像任何第三方 CLI 一样谨慎。

    将密钥和令牌保存在环境变量中,并且不要提交到存储库。 OpenCode 在本地存储 OAuth 令牌,但在共享计算机上,这也值得考虑:opencode mcp logout 在不再需要访问时删除它们。

    还有一件事:不要一次打开所有东西。 MCP 为上下文添加了工具,而上下文就是金钱和响应质量。两到三台真正必要的服务器比为了以防万一而连接的十台服务器要好得多。

    链接

    https://opencode.ai/docs/mcp-servers/
    https://opencode.ai/docs/config/
    https://modelcontextprotocol.io/
    https://github.com/upstash/context7
    https://mcp.sentry.dev
    https://mcp.grep.app
    https://github.com/anomalyco/opencode

    来源

    https://opencode.ai/docs/mcp-servers/
    https://modelcontextprotocol.io/
    https://api-docs.deepseek.com/
    https://api-docs.deepseek.com/quick_start/agent_integrations/opencode

  • DeepSeek Harness:安装、功能和首次启动

    DeepSeek Harness,简称 dsh,是 DeepSeek AI 的开源 AI 代理工具。如果模型回答了问题,那么该工具就会为她提供帮助:读取和编辑文件、运行命令、保持会话、显示执行轨迹并允许使用插件进行扩展。该项目根据 MIT 许可证分发,并处于公共预览状态。

    DeepSeek Harness 的主要思想被表述为“一切都是插件”——字面意思是“一切都是插件”。整个产品都是建立在这个之上的:模型适配器、工具注册表、会话日志、接口,甚至代理周期本身。它基于 Cordis 框架,因此开发人员不仅可以添加新命令,还可以在不分叉内核的情况下替换代理的整个行为。

    您可以通过多种方式使用 dsh:通过本地 Web 界面、通过桌面应用程序、从无头模式下的命令行或从 Python SDK。以下是安装、首次启动和功能概述。

    你需要什么

    Web 界面和 CLI 需要 Node.js。该项目有严格的要求:

    • 22.x 系列中的 Node.js 22.19.0 或更高版本。
    • 24.x 行中的 Node.js 24.0.0 或更高版本。
    • 任何补丁都不支持 Node.js 23.x:该产品线不是 LTS,并且已停止使用。

    除了 Node.js 之外,您还需要 DeepSeek API 密钥。它是在 platform.deepseek.com 上的您的个人帐户中创建的。桌面应用程序不需要 Node.js – 环境已经打包在那里。

    您可以使用以下命令检查版本:

    node -v
    

    通过 npx 安装

    了解该项目的最快方法是根本不全局安装任何东西。只需运行:

    npx @deepseek-ai/dsh web
    

    该命令将从 npm 下载 @deepseek-ai/dsh 包,设置本地 Web 服务器并在浏览器中打开界面。默认情况下它监听地址:

    如果您不需要打开浏览器(例如在远程计算机上),请添加 –no-open 标志:

    npx @deepseek-ai/dsh web --no-open
    

    通过 SSH 启动时,dsh 会打印地址,但不会尝试打开浏览器:本地地址由 SSH 客户端或编辑器拥有。

    全局安装

    如果您经常需要某个工具,那么全局安装会更方便。该软件包提供了 dsh 二进制文件:

    npm install -g @deepseek-ai/dsh
    dsh web
    

    此后,可以从任何目录使用 dsh 命令。更新以通常的方式执行:

    npm install -g @deepseek-ai/dsh@latest
    

    桌面应用程序

    对于那些不想持有终端和 Node.js 的人,DeepSeek 发布了桌面版本。它们可以在官方下载页面上找到:

    • macOS – Apple Silicon、macOS 13 或更高版本,DMG 格式。
    • Windows – 64 位程序集,EXE 格式。

    该应用程序使用相同的本地文件,可以在后台执行任务,并以与网络版本相同的方式存储会话。当您不想每次都手动升起服务器时,这对于日常工作来说是一个方便的选择。

    从源代码构建

    如果您需要完全控制代码、您自己的补丁或插件开发,可以从存储库中收集项目。您将需要 pnpm,并且存储库修复了特定版本,因此您应该首先启用 Corepack:

    corepack enable
    git clone https://github.com/deepseek-ai/deepseek-harness.git
    cd deepseek-harness
    pnpm install
    pnpm run build
    pnpm dsh web
    

    pnpm run build 命令准备包和前端工件,pnpm dsh web 运行已构建的版本而不重建。对于开发,有一种模式 pnpm run dev:web:它会在源更改时构建、启动服务器并重建客户端捆绑包。

    首次启动

    启动Web界面后,流程如下。

    首先,打开设置 → 模型并输入 DeepSeek API 密钥。该密钥保存在文件 $DSH_HOME/.credentials.yaml 中,并且设置中仅保留指向它的链接。设置页面收到已屏蔽的秘密描述,因此无法从界面读回密钥。模型更改从下一个请求开始应用;无需重新启动服务器。

    然后通过选择工作区选择您的工作文件夹。当未选择工作区时,任务输入字段将保持灰显状态。这是有意这样做的:代理必须了解允许读取和更改文件的边界。

    之后,您可以提交第一个任务。例如:

    Summarize this repository and identify its main packages.
    

    代理将阅读项目、制定计划、调用必要的工具并显示结果。对于需要根据当前访问策略进行确认的操作,dsh 会在执行前进行询问。

    模型和提供商

    DeepSeek 一步连接:设置中的提供商卡仅包含 API 密钥字段。此外,您可以添加第三方服务。内置目录知道诸如 anthropic、openai、moonshotai(Kimi)和 zai(GLM)之类的标识符。

    对于您自己的网关、公司代理或本地服务器,有一种自定义模型 API 模式。它问:

    • 永久提供商标识符;
    • 显示名称;
    • API基地址;
    • 协议:OpenAI 聊天完成、OpenAI 响应或人择消息;
    • 密钥和型号列表。

    协议很重要:一个提供商讲一种协议。如果网关同时支持 OpenAI 和 Anthropic,则必须由两个提供商对其进行描述。对于模型,您可以指定上下文窗口的大小、输出标记的最大数量以及支持的输入数据类型(包括图像)。

    DeepSeek 模型具有关闭、低、高和最大推理级别。在模型旁边的Effort菜单中选择级别。对于存储库中的例行任务,快速模型就足够了,但对于复杂的架构任务,增加工作量或采用更高级别的模型是有意义的。

    插件和创建者模式

    插件是 DeepSeek Harness 的主要功能。通过它们,可以添加工具、技能、界面元素和整个应用程序。该界面有一个插件管理器,包含官方和实验集:代理命令、自动确认、计划任务、语音输入、终端、子代理。

    创作者模式单独脱颖而出。在这种模式下,你可以直接在聊天中要求客服人员编写插件。它将下载 Cordis 插件开发技能,创建包结构,编写代码,安装插件并检查其状态。官方项目页面上有一个例子,浮动番茄计时器就是这样组装的。

    插件也可以从命令行安装。对于 Web 配置文件,命令如下所示:

    dsh plugin --profile web add some-dsh-plugin
    

    支持 Npm 包、github:owner/repo 等链接、本地目录和 tgz 存档。安装后,检查插件层是否确实包含在配置中非常有用:

    dsh --profile web --dump-config
    

    该命令在不启动服务器的情况下打印组装的插件树。如果没有新层,则捆绑包很可能没有声明 dsh.bundle 清单并作为常规库安装,而不是作为包含的插件安装。

    实验设置包括自定义插件市场。这是一个索引 JSON 文件,其中包含插件列表、版本、图标和来源。通过启用该集,您可以在插件页面上获得发现选项卡以及连接第三方市场的能力。与任何第三方来源一样,只有当您信任其作者时才应添加这样的市场。

    轨迹和审核

    对于每个会话,dsh 都会写入一个仅附加事件日志 – Trajectory。它存储系统提示、推理、工具调用及其结果、子代理调度和上下文插入。会话恢复、分叉、搜索和重放都建立在该日志之上。

    实际的好处是对话不再是一个黑匣子。在界面中,您可以打开轨迹并查看调用了哪些工具、每个步骤花费了多长时间、更改了哪些文件以及请求花费了多少令牌。如果客服人员行为异常,原因通常可以在此处看到,而不是在聊天中的简短回答中。

    会话以 JSONL 日志的形式位于 ~/.dsh/sessions 中。您可以阅读它们、搜索它们并构建您自己的分析。这也使得准确计算常规 API 账单中不可见的费用和缓存命中成为可能。

    后台任务和时间表

    DeepSeek Harness 不仅可以在“询问并接收答案”模式下工作。任务可以在后台启动并计划。例如,要求代理商每周五 17:00 从项目笔记中收集周报。在界面中,此类任务是单独可见的:您可以检查状态、查看历史记录和打开执行详细信息。

    有一个用于自动化的无头配置文件。它启动一个会话,打印最终响应,然后退出:

    dsh --profile headless "run the tests"
    

    此模式对于不需要 Web 界面的 CI、cron 和脚本来说很方便。除了 headless 之外,还提供 sdk 和 acp 配置文件:第一个通过 JSON-RPC 为 SDK 客户端提供服务,第二个通过 ACP stdio 为自动化客户端提供服务。

    子代理、MCP 和技能

    复杂的任务可以分解为子代理。主要代理负责规划工作,各个子代理则在各自的领域内工作。这有助于保持上下文紧凑,而不是将整个历史记录拖到每个请求中。

    外部工具和数据源通过 MCP 连接。该文档包括内存 MCP 的单独指南,以及 GitHub 审查会议等集成。技能描述了代理根据需要加载的可重复过程,而不是始终将所有指令保留在系统提示中。

    配置文件、捆绑包和补丁

    dsh 配置由三层组装而成。 Bundle 是一组配置行和插件代码,即一个现成的功能。 Profile 是捆绑包的命名组合,存储在 $DSH_HOME/profiles/ 中。 Patch 是一个 YAML 文件,它通过标识符更改已加载的行、禁用它们或添加新行。

    应用程序的顺序如下:首先是配置文件顺序中的捆绑包,然后是配置文件补丁,然后是常规补丁$DSH_HOME/cordis.patch.yml,最后是通过–patch传输的覆盖层。这意味着几乎任何设置都可以被覆盖,而无需触及捆绑包源。您可以使用以下命令查看生成的树:

    dsh --profile web --dump-config
    

    标准 Web 配置文件称为 web,无服务器配置文件称为 headless。它们的设置文件位于 $DSH_HOME/profiles/web/cordis.patch.yml 和 $DSH_HOME/profiles/headless/cordis.patch.yml 中。这是 dsh 写入通过设置界面所做的更改的位置。

    Python SDK

    Python 项目有一个官方 SDK。它安装在虚拟环境中,并自带原生运行时,因此正常工作不需要系统 Node.js:

    python -m venv .venv
    .venv\Scripts\Activate.ps1
    python -m pip install deepseek-harness-sdk
    

    一个最小的启动示例如下所示:

    from pathlib import Path
    
    from deepseek_harness import DeepSeekHarness
    
    workspace = Path("C:/work/disposable-workspace").resolve()
    dsh_home = Path("C:/work/example-dsh-home").resolve()
    
    with DeepSeekHarness(
        provider="deepseek-official",
        model="deepseek-v4-flash",
        max_tokens=49_152,
        cwd=str(workspace),
        dsh_home=str(dsh_home),
        profile="sdk-minimal",
    ) as harness:
        result = harness.run(
            "Inspect the repository and fix the failing tests.",
            session_id="example-001",
        )
    
    print(result.final_response)
    

    SDK 使用 sdk-minimal 配置文件启动捆绑的 dsh 进程,并在退出上下文管理器之前重用它。最小配置文件是有意限制的:它具有 bash 或 pwsh、图像读取和工作目录,但没有 Web 工具、子代理或某些文件工具。对于一次性任务来说,这是一个优点:需要控制的表面更少。

    需要注意什么

    DeepSeek Harness 是开发者预览版本 0.1.0-rc.x。自述文件明确警告兼容性将被破坏。对于实验、个人项目和自动化来说,这很好,但对于现在赚钱的流程来说,值得权衡风险并保留备用计划。

    第二点是Node.js。如果您使用的是 22.18 或 23.x,安装将崩溃或行为不可预测。提前检查版本:该项目使用node:sqlite和TypeScript内置的需要新分支的类型擦除。

    第三点是沙箱和权限。默认情况下,代理以接近工作区写入的策略运行:它可以更改所选文件夹中的文件,并且潜在危险的操作需要确认。危险全通模式给予了更多的自由,但风险也更高。在尝试真正的存储库之前,进行提交或备份很有用。

    第四点是成本。 DSH 本身是免费的,但为了推断,您需要向提供商支付代币费用。对于长会话,前缀缓存很重要:dsh 组合请求,以便历史记录和工具架构尽可能长时间保持不变。如果分数高于预期,不仅要查看每个代币的价格,还要查看轨迹中现金命中的份额。

    值得尝试吗

    DeepSeek Harness 主要是那些不仅想要“与模特再次聊天”,而且想要为代理提供受控环境的人感兴趣的人。有一个透明的轨迹、文件和命令的正常工作、后台任务、子代理以及通过插件的真正深度扩展。用自己的代理循环替换代理循环的能力很少见,并且对于研究和自定义编排可能非常有用。

    如果您需要一个稳定的工具来进行日常有偿工作,那么现在更明智的做法是将 dsh 视为主要代理旁边的第二个代理:在个人项目上尝试它,比较任务的成本和质量,然后才将其转移到工作流程中。

    链接

    https://www.deepseek.com/harness/
    https://www.deepseek.com/download/
    https://github.com/deepseek-ai/deepseek-harness
    https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart
    https://deepseek-harness.github.io/deepseek-harness/en/guide/providers
    https://deepseek-harness.github.io/deepseek-harness/en/guide/python-sdk
    https://platform.deepseek.com/

    来源

    https://github.com/deepseek-ai/deepseek-harness/blob/master/README.md
    https://github.com/deepseek-ai/deepseek-harness/blob/master/apps/cli/README.md
    https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart
    https://deepseek-harness.github.io/deepseek-harness/en/guide/providers
    https://deepseek-harness.github.io/deepseek-harness/en/guide/python-sdk
    https://deepseek-harness.github.io/deepseek-harness/en/guide/plugin-market
    https://dshdocs.com/getting-started/installation/
    https://dshdocs.com/concepts/profiles-bundles-patches/
    https://dshdocs.com/guides/dsh-vs-claude-code/

  • Ollama 中的 Jev 解决方案模型:实际使用 /v1/systemone

    从版本 0.35 开始,Ollama 支持基于 TypeSafe 的 Jev API 构建的决策模型。这些不是通常意义上的聊天模型:它们不编写文本,而是回答一组有关转移状态的键入问题。对于分类、路由、审核和分类,这比要求常规 LLM 返回 JSON 然后解析其响应更快、更可靠。

    在这篇文章中,我将介绍什么是决策模型、它们如何在 HTTP 级别工作、哪些模型已经可用,以及如何将它们构建到现有代码中,以便常规生成模型继续工作。

    决策模型与常规模型有何不同

    常规的 LLM 会收到提示并逐个生成文本标记。即使你让她用一个词来回答,生成仍然发生在里面,而答案的格式必须由图表、说明和后续验证来控制。决策模型的工作方式有所不同:您通过类型传递状态和问题,模型返回概率和选定的选项。没有自由文本,没有从响应中解析 JSON。

    新端点称为 /v1/systemone。在一个请求中,您可以同时提出多个问题,模型将回答所有问题。这对于需要做出多个相关决策的任务非常方便:例如,确定团队、是否需要返回以及票证的紧急程度。

    有哪些型号可供选择

    现在您可以通过 Ollama 运行三个决策模型:

    • nimble 是来自 Bespoke Labs 的开放模型,拥有 90 亿个参数。它是现有的最大且最准确的。
    • tev1 是来自 Together AI 的一个实验模型,拥有 40 亿个参数。
    • tev1:0.8b 是来自 Together AI 的具有 8 亿个参数的实验模型。最快、最简单。

    它们都在本地工作,不需要付款,也不将数据发送到外部服务。支持 Ollama 0.35 及更高版本。

    安装

    首先查看Ollama版本:

    ollama --version
    

    然后下载所需的模型。对于最简单的一个:

    ollama pull tev1:0.8b
    

    对于 tev1 的完整版本:

    ollama pull tev1
    

    对于敏捷:

    ollama pull nimble
    

    nimble 模型占用约 9.5 GB 的磁盘空间,因此最好在下载之前清理一些空间。 tev1:0.8b 占用不到 1 GB。

    通过curl发出的第一个请求

    最简单的例子是判断一段文字是否是招聘广告:

    curl http://localhost:11434/v1/systemone -d '{
      "model": "tev1:0.8b",
      "state": {
        "message": "Senior Swift developer, Berlin, remote friendly"
      },
      "questions": {
        "isJob": {
          "type": "noul",
          "instructions": "Does the message advertise a job posting that someone can apply to?"
        }
      }
    }'
    

    答案看起来像这样:

    {
      "model": "tev1:0.8b",
      "answers": {
        "isJob": {
          "type": "noul",
          "noul": 0.921
        }
      },
      "usage": {
        "input_tokens": 42,
        "output_tokens": 0
      }
    }
    

    noul字段是从0到1的概率。通过与阈值(通常为0.5)比较来做出决定。与生成模型不同,不需要请求 JSON 格式的响应,然后检查模型是否没有破坏它。

    问题类型

    决策模型支持三种类型的问题。

    noul 是一个二元问题。返回语句为真的概率:

    {
      "questions": {
        "refund": {
          "type": "noul",
          "instructions": "Does the customer explicitly ask for a refund?"
        }
      }
    }
    

    选择 – 从给定的集合中选择一个选项。返回所选选项、所有选项的概率和置信度:

    {
      "questions": {
        "team": {
          "type": "choice",
          "instructions": "Which team should handle this ticket?",
          "criteria": {
            "billing": "Payments and refunds",
            "technical": "Bugs and integrations",
            "other": "None of the above"
          }
        }
      }
    }
    

    分数 – 等级评分。返回每个比例点的数字、图例和概率:

    {
      "questions": {
        "urgency": {
          "type": "score",
          "instructions": "How urgent is this ticket?",
          "criteria": ["Routine", "Soon", "Urgent"]
        }
      }
    }
    

    一个请求可以同时包含多个不同类型的问题。这就是决策模型便于分类的原因:一种操作,一种状态,几个独立的决策。

    无需额外库的 Python

    对于请求来说,标准的urllib就足够了;不需要单独的 SDK:

    import json
    from urllib.request import Request, urlopen
    
    OLLAMA_DECISION_URL = "http://localhost:11434/v1/systemone"
    
    def ask_decision(state, questions, model="tev1:0.8b"):
        payload = {
            "model": model,
            "state": state,
            "questions": questions,
        }
        request = Request(
            OLLAMA_DECISION_URL,
            data=json.dumps(payload).encode(),
            headers={"Content-Type": "application/json"},
            method="POST",
        )
        with urlopen(request, timeout=3600) as response:
            return json.loads(response.read().decode())["answers"]
    

    用法:

    answers = ask_decision(
        {"message": "Senior Swift developer, Berlin, remote friendly"},
        {
            "isJob": {
                "type": "noul",
                "instructions": "Does the message advertise a job posting that someone can apply to?"
            }
        },
    )
    
    probability = answers["isJob"]["noul"]
    is_job = probability >= 0.5
    

    如果您需要官方的Python SDK,它称为typesafe-sdk。对于本地主机,可以使用环境变量 TYPESAFE_BASE_URL、TYPESAFE_API_KEY 和 TYPESAFE_DEFAULT_MODEL 将其定向到 Ollama。但对于简单的任务,直接 HTTP 请求就足够了。

    如何理解模型支持决策

    决策模型无法通过 /api/generate 或 /api/chat 进行响应。如果您发送此类请求,Ollama 将返回 400 错误,其中包含如下文本:

    "tev1:0.8b" does not support generate
    

    如果您已经拥有通过 /api/generate 处理常规模型的代码,这一点很重要:如果您将模型更改为决策模型,它将停止工作。最好通过 /api/show 提前了解模型的能力,并选择合适的调用方式:

    import json
    from urllib.request import Request, urlopen
    
    OLLAMA_SHOW_URL = "http://localhost:11434/api/show"
    
    def supports_decision(model):
        request = Request(
            OLLAMA_SHOW_URL,
            data=json.dumps({"model": model}).encode(),
            headers={"Content-Type": "application/json"},
            method="POST",
        )
        try:
            with urlopen(request, timeout=30) as response:
                capabilities = json.loads(response.read().decode()).get("capabilities", [])
        except (OSError, TypeError, ValueError):
            return False
        return "decision" in capabilities
    

    决策模型只能根据其能力做出决策。常规模型将有完成、工具或其他功能。如果 Ollama 不可用,则可以合理地认为模型正常并使用生成路径。

    如何嵌入现有代码

    最简单的方法不是重写分类器,而是将其分为两种策略。生成策略的工作方式与以前一样:它收集提示,将其发送到 /api/generate 并解析 JSON。决策策略将状态和键入的问题发送到 /v1/systemone 并将概率与阈值进行比较。

    创建分类器时,策略的选择发生在一个地方:

    def create_classifier(model):
        if supports_decision(model):
            return DecisionClassifier(model)
        return GenerativeClassifier(model)
    

    这种方法有几个优点。生成模型继续运行不变。可以通过更改一个环境变量来启用决策模型。这两种方法之间的全部差异集中在两个小类中,并且没有分散到整个应用程序中。

    对于二元分类,决策策略如下所示:

    async def classify(text):
        answers = await ask_decision(
            {"message": text},
            {
                "isJob": {
                    "type": "noul",
                    "instructions": instructions,
                }
            },
            model,
        )
        probability = answers["isJob"]["noul"]
        return probability >= 0.5, probability
    

    请注意,决策模型不会返回解释。如果您的结果格式具有原因字段,您可以根据概率构建它:例如,存储概率本身或类似“模型将 0.935 的消息评为空缺”的字符串。这比发明模型没有给出的原因更诚实。

    说明应该是一个问题

    这是最重要的实际结论。决策模型无法理解“你对消息进行分类,如果……则回答 true,否则回答 false”这样的长提示。他们想要一个简短、直接的问题。

    在同一条关于职位空缺的消息中,我收到了以下概率:

    • 直接提问“此消息是招聘信息吗?” — 0.921。
    • 详细说明什么被视为空缺 – 0.026。
    • 最后有问题的长说明 – 0.391。

    相差了近三十倍。该模型在分类上并没有错误,只是当问题隐藏在段落中时,它不明白他们想要从中得到什么。因此,对于决策模型,值得保留单独的简短指令,并为生成模型留下长提示。

    创建单独的环境变量很方便:

    OLLAMA_JOB_CLASSIFIER_DECISION_INSTRUCTIONS=Does the message advertise a job posting that someone can apply to?
    

    并仅对生成路径使用常规提示。

    阈值和概率

    阈值 0.5 适合作为默认值,但将其包含在配置中会很有用。对于不同的任务,误报和误报响应的成本是不同的。对于节制来说,提高门槛比较安全;寻找职位空缺时,将其降低比较安全,以免错过有用的消息。

    记录概率本身也很有用,而不仅仅是结果布尔值。当分类器出错时,日志会显示它是一个自信的答案还是一个边界决策。对于选择问题,值得保存概率和置信度:它们显示模型在选项之间的波动程度。

    性能和内存

    速度很大程度上取决于模型的大小和硬件。在我的测试中,我在 CPU 上得到了以下数字:

    • tev1:0.8b – 只需几秒钟即可解决,轻松装入内存。
    • tev1 – 4B,明显较慢,但仍然适合交互式任务。
    • nimble – Q8_0 中为 9B,内存约为 10 GB。第一个请求(包括加载模型)花费了大约 137 秒,后续解决方案在 CPU 上花费了 12 到 32 秒。

    Nimble 需要大量 RAM。在具有 16 GB 和限制约为 8 GB 的 Docker/WSL 的计算机上,该模型不适合:系统开始交换,容器停止响应。通过 .wslconfig 文件将 WSL 限制增加到 12 GB 有助于:

    [wsl2]
    memory=12GB
    swap=8GB
    

    更改后,需要 wsl –shutdown 并重新启动 Docker Desktop。但即使有 12 GB,预留空间仍然很小:该模型大约占用 10 GB,留给系统的空间所剩无几。

    默认情况下,Ollama 在五分钟不活动后卸载模型,释放内存。这很方便:nimble 不会始终保持 10 GB 繁忙,但暂停后每次新启动都会再次开始加载模型。

    何时使用决策模型

    决策模型非常适合需要快速、廉价地回答明确提出的问题的任务:

    • 消息、票证和请求的分类。
    • 通过命令或执行器进行路由。
    • 内容审核和安全检查。
    • 游戏或交互式应用程序中的快速二元和多元解决方案。

    它们不太适合需要详细文本的任务:解释、字段提取、摘要、答案生成。为此,保留了通常的生成模型。组合时可以获得最佳结果:决策模型做出决策,生成模型解释决策或提取数据。

    总计

    与常规法学硕士相比,Ollama 的决策模型是一个独立的、范围更窄的工具。它们不会取代生成模型,但会取消工作的常规部分:键入的响应、概率而不是文本解析以及可预测的格式。如果您已经有了分类管道,则转换归结为检查模型的功能、单独的调用策略和简短的指导问题。

    来源
    https://ollama.com/blog/ollama-now-supports-jev-style-decision-models
    https://ollama.com/library/nimble
    https://ollama.com/library/tev1
    https://typesafe.ai

  • 通过 FreeLLMAPI 的 OpenCode 免费模型

    OpenCode 是一个在终端中工作的开放编程代理:读取项目文件、编辑代码、运行命令和测试、搜索存储库并使用 git。它不依赖于一个模型提供商,因此几乎任何 OpenAI 兼容服务都可以连接到它。

    FreeLLMAPI 是一款开放式自托管路由器,可在一个兼容 OpenAI 的 /v1 地址下收集来自数十家 AI 提供商的免费计划。您拥有一个本地网关和一个统一密钥,而不是三十个密钥、三十个限制和三十个可能导致请求失败的位置。路由器本身会选择一个可用的型号,当出现429或5xx错误时切换到下一个型号,并确保请求不超过免关税配额。

    在这篇文章中,我将描述安装 FreeLLMAPI、添加提供程序以及将网关连接到 OpenCode。

    你需要什么

    要工作,你需要四样东西:

    • 已安装 OpenCode。如果尚未安装代理,我会在有关 OpenCode 和 DeepSeek 的单独说明中讨论安装过程。
    • FreeLLMAPI 正在运行。最简单的方法是安装桌面应用程序或 Docker 容器。
    • Node.js 20.18 或更高版本。配置 OpenCode 的 CLI 生成器需要此版本。 OpenCode 本身可以在没有 Node 的情况下安装。
    • 至少一个提供商的密钥。Google AI Studio、Groq、Cerebras、Mistral、OpenRouter、NVIDIA、HuggingFace 以及目录中的其他服务的免费计划均适用。

    安装 FreeLLMAPI

    该项目有多个安装路径。选择对您的系统更方便的一种。

    桌面应用程序

    对于 Windows 和 macOS,最简单的选项是发布页面中的现成安装程序。在 Windows 上它是 .exe,在 macOS 上它是 Apple Silicon 或 Intel 的 .dmg。该应用程序位于托盘中,并在本地升起路由器和控制面板。

    桌面版本不需要密码:面板通过隐藏的本地帐户自行登录。您需要的唯一凭据是托盘弹出窗口或密钥页面标题中的统一密钥。

    应用程序数据位于一个目录中:

    • Windows — %APPDATA%\FreeLLMAPI\
    • macOS — ~/Library/Application Support/FreeLLMAPI/
    • Linux — ~/.config/FreeLLMAPI/

    Docker

    如果已经安装了 Docker,则可以通过一条命令启动服务器。该脚本创建 ~/freellmapi 目录,生成加密密钥,下载映像并启动容器:

    curl -fsSL https://freellmapi.co/install.sh | bash
    

    再次运行脚本是安全的:保存 .env 文件和加密密钥,并将容器更新到最新版本。在 Windows 上,此方法适用于 WSL 或任何 bash 环境。

    启动后,面板打开于:

    http://localhost:3001
    

    对于服务器安装,您需要使用电子邮件和密码创建一个帐户。如果忘记密码,重置代码会打印在容器日志中:

    docker compose logs -f freellmapi
    

    Docker Compose

    如果您想将配置保留在 git 中并手动管理启动,则常规 Compose 即可。在 macOS 和 Linux 上:

    git clone https://github.com/tashfeenahmed/freellmapi.git
    cd freellmapi
    ENCRYPTION_KEY="$(openssl rand -hex 32)"
    printf "ENCRYPTION_KEY=%s\nPORT=3001\n" "$ENCRYPTION_KEY" > .env
    docker compose up -d
    

    在 Windows PowerShell 中:

    git clone https://github.com/tashfeenahmed/freellmapi.git
    cd freellmapi
    $Bytes = New-Object Byte[] 32
    [Security.Cryptography.RandomNumberGenerator]::Create().GetBytes($Bytes)
    $ENCRYPTION_KEY = -join ($Bytes | ForEach-Object { "{0:x2}" -f $_ })
    "ENCRYPTION_KEY=$ENCRYPTION_KEY`nPORT=3001" | Out-File -Encoding utf8 .env
    docker compose up -d
    

    ENCRYPTION_KEY 密钥是必需的:它用于加密 SQLite 数据库中的提供程序密钥。您无法即时更改它 – 旧的秘密将不再被解密。对于轮换,该项目有一个单独的命令“rotate-encryption-key”。

    从源代码运行

    对于开发或调试,您可以通过 Node.js 运行项目:

    git clone https://github.com/tashfeenahmed/freellmapi.git
    cd freellmapi
    npm install
    ENCRYPTION_KEY="$(node -e 'console.log(require("crypto").randomBytes(32).toString("hex"))')"
    printf "ENCRYPTION_KEY=%s\nPORT=3001\n" "$ENCRYPTION_KEY" > .env
    npm run dev
    

    该模式下API和面板在3001端口发起,Vite接口在5173端口发起。

    首次启动和提供商密钥

    打开面板,进入Keys页面,添加我们使用的服务的密钥。对于每个提供商,界面都有一个注册链接和一个获取密钥的提示。从一两个开始就足够了:例如,Google AI Studio 和 Groq。

    添加后,密钥将接受健康检查。如果提供商响应错误,密钥将保留在列表中,但将被标记为不健康 – 可以再次检查或删除它。

    接下来,您应该转到型号页面并查看可用的型号。您还可以在其中配置路由策略和回退链的顺序 – 发生错误和限制时路由器所沿的链。 auto模型意味着由路由器本身做出选择。除此之外,还可以使用 auto:fast、auto:smart 和针对特定任务的命名配置文件等选项。

    还值得检查链中是否有支持工具的模型。 OpenCode 积极使用工具调用,没有此功能的模型将无法正常读取文件或运行命令。

    统一密钥在密钥页面上或桌面应用程序的托盘中获取。它看起来像一个带有前缀的字符串:

    freellmapi-...
    

    OpenCode 中指示的正是此密钥,而不是各个提供商的密钥。

    连接到 OpenCode

    FreeLLMAPI 有一个配置生成器,它本身从正在运行的网关读取模型目录,制作现有配置的备份副本,并小心地将提供程序添加到其中。

    首先,我们将统一密钥设置为环境变量。生成器读取它而不是单独的标志,因此秘密不会最终出现在命令历史记录中。

    在 macOS 和 Linux 上:

    export FREELLMAPI_API_KEY=freellmapi-YOUR_KEY
    

    在 Windows PowerShell 中:

    $env:FREELLMAPI_API_KEY="freellmapi-YOUR_KEY"
    

    现在让我们看看具体会记录什么:

    npx freellmapi setup-opencode --url http://localhost:3001 --dry-run
    

    如果 diff 令人满意,则重复不带标志的命令:

    npx freellmapi setup-opencode --url http://localhost:3001
    

    生成器写入全局 OpenCode 配置:

    ~/.config/opencode/opencode.json
    

    freellmapi 提供程序与 @ai-sdk/openai 兼容包、基地址 http://localhost:3001/v1 以及实时目录中的模型地图一起出现在其中。默认模型变为 freellmapi/auto。

    密钥本身不会出现在文件中:配置包含替换 {env:FREELLMAPI_API_KEY}。因此,当代理启动时,该变量必须保持设置状态:

    opencode
    

    这种方法也很方便,因为秘密不会出现在配置中,也不会出现在 git 中。对于 CI 和一次性运行,这比将密钥存储在文件中更正确。

    手动设置

    如果您不想运行生成器,可以在 opencode.json 中手动描述提供程序。最小选项如下所示:

    {
      "$schema": "https://opencode.ai/config.json",
      "model": "freellmapi/auto",
      "provider": {
        "freellmapi": {
          "npm": "@ai-sdk/openai-compatible",
          "name": "FreeLLMAPI",
          "options": {
            "baseURL": "http://localhost:3001/v1",
            "apiKey": "{env:FREELLMAPI_API_KEY}"
          },
          "models": {
            "auto": {
              "name": "FreeLLMAPI Auto Router",
              "limit": { "context": 1048576, "output": 65536 }
            }
          }
        }
      }
    }
    

    顶层的模型字段很重要:没有它,OpenCode 可能会继续使用以前的模型,或者在全新安装时不选择任何内容。最好从网关响应中获取上下文和输出限制,而不是发明它们:

    curl http://localhost:3001/v1/models
    

    如果需要手动切换到模型列表,您可以将特定标识符添加到模型列表中。但对于日常工作,自动就足够了:路由器本身会选择一个实时模型,并在达到限制时进行切换。

    如何使用

    启动 opencode 后,模型列表将使用熟悉的命令打开:

    /models
    

    它将有一个 FreeLLMAPI 提供程序和一个自动模型。然后工作照常进行:我们描述任务,通过@指定文件,用Tab键切换计划模式,用/undo命令回滚编辑。对于新项目,运行 /init 以使代理创建 AGENTS.md 非常有用。

    一些实用技巧:

    • 路由。对于例行程序,请将其保留为自动。如果您需要速度,请尝试 auto:fast,如果质量是 auto:smart 或目录中的特定强大型号。
    • 诊断 每个网关响应都包含一个 X-Roated-Via 标头,其中包含实际为请求提供服务的提供商和模型的名称。它显示路由器将任务发送到的位置。
    • 分析。在“分析”页面上,面板显示请求量、成功、p50/p95 延迟以及提供商的令牌消耗量。
    • 对话的连续性。在对话过程中切换模型时,网关可以添加有关上下文传输的简短注释。通过变量 FREELLMAPI_CONTEXT_HANDOFF=on_model_switch 启用。

    如果 OpenCode 在容器中运行并且 FreeLLMAPI 在主机上运行,​​则 localhost 将指向容器本身。在这种情况下,您需要使用 host.docker.internal 或可从 baseURL 中的容器访问的其他地址。

    需要注意什么

    FreeLLMAPI 不是付费模型的替代品,也不是具有 SLA 的服务。这是一种将免费计划捆绑到一个简洁网关中的方法。因此有几个限制:

    • 质量波动。免费关税结束,到了晚上,接近每日配额耗尽时,路由器可能会切换到较弱的型号。配额通常会在 UTC 午夜重置。
    • 延迟是可变的。不同的提供商响应不同,切换到备份模型时,请求可能需要明显更长的时间。
    • 没有旗舰型号。免费计划中提供不错但不是高端的型号。对于复杂的架构,这是值得考虑的。
    • 网关必须正在运行。如果应用程序或容器停止,OpenCode 将不会收到响应。自动启动托盘中的应用程序或重新启动容器策略可以解决此问题。
    • 该项目是为一个用户设计的。提供商密钥在本地存储并加密,但多人共享面板不适合此工具。应以与常规机密相同的方式保护统一密钥和 .env。

    还有一个细微差别:模型目录会自行更新,但免费安装会延迟大约三十天收到目录快照。高级付费计划可以加快更新速度,但不需要熟悉该项目 – 路由器本身仍然免费且开放。

    链接

    https://github.com/tashfeenahmed/freellmapi
    https://freellmapi.co/
    https://freellmapi.co/models
    https://github.com/tashfeenahmed/freellmapi/releases/latest
    https://github.com/tashfeenahmed/freellmapi/blob/main/docs/en/install/01-install.md
    https://github.com/tashfeenahmed/freellmapi/blob/main/docs/en/clients/01-agent-clients.md
    https://github.com/tashfeenahmed/freellmapi/blob/main/cli/README.md
    https://opencode.ai/
    https://opencode.ai/docs/
    https://opencode.ai/docs/providers/

    来源

    https://github.com/tashfeenahmed/freellmapi
    https://github.com/tashfeenahmed/freellmapi/blob/main/README.ru.md
    https://github.com/tashfeenahmed/freellmapi/blob/main/docs/en/install/01-install.md
    https://github.com/tashfeenahmed/freellmapi/blob/main/docs/en/clients/01-agent-clients.md
    https://github.com/tashfeenahmed/freellmapi/blob/main/docs/en/clients/02-supported-agents.md
    https://github.com/tashfeenahmed/freellmapi/blob/main/cli/README.md
    https://opencode.ai/docs/providers/

  • 俄罗斯 OpenCode 人工智能提供商

    OpenCode 是一个开放的编程代理,可以直接在终端中工作:读取项目文件、编辑代码、运行命令和测试、搜索存储库并使用 git。它的优势在于它不依赖于一个模型提供商,并且可以连接数十个提供商。

    GigaChat 是 Sber 的大型语言模型。它不在 OpenCode 提供程序的就绪列表中,但这不是问题:OpenCode 通过 Vercel AI SDK 包连接任意提供程序。对于 GigaChat,有一个包 gigachat-ai-sdk-provider,它负责 OAuth 授权和更新访问令牌。一个单独的细微差别是数字发展部证书:没有它们,Node 不信任 GigaChat 服务器,并且请求会因证书验证错误而失败。

    在这篇文章中,我将描述如何获取密钥、安装证书并将 GigaChat 连接到 OpenCode。

    你需要什么

    要工作,你需要三样东西:

    • 已安装 OpenCode。如果尚未安装代理,我会在有关 OpenCode 和 DeepSeek 的单独说明中讨论安装过程。
    • GigaChat 帐户。在 GigaChat Studio 中注册并获得授权密钥 – 您需要 Sber ID 才能登录。
    • 现代终端。WezTerm、Alacritty、Ghostty、Kitty 或任何其他终端都可以。

    GigaChat 授权密钥

    密钥是在您的 GigaChat Studio 个人帐户中创建的。转到developers.sber.ru/studio,登录并在GigaChat API部分创建一个项目。在项目设置中,有一个包含授权数据的块:从那里复制的行是一个现成的 Base64 授权密钥。正是这个被替换到环境变量中,而不是单独的客户端秘密对。

    与键一起指定范围 – 访问区域:

    • GIGACHAT_API_PERS – 适用于个人。
    • GIGACHAT_API_B2B – 适用于个体企业家和法人实体。
    • GIGACHAT_API_CORP – 公司访问权限。

    显示的密钥值应立即保存:以后不会再次显示,如有必要,必须发出新的密钥值。

    了解这条线是什么很重要。授权密钥不是单独的密钥,而是一对已经以 Base64 编码的 client_id:client_secret。 gigachat-js 库将此标头替换为 OAuth 请求:

    Authorization: Basic ваш_ключ_авторизации
    

    作为响应,JWE 访问令牌的生命周期约为半小时,然后库会自动更新它。该包本身会检查该值是否类似于 base64,并在该变量意外包含“原始”客户端机密时发出警告。因此,需要将帐户中现成的base64字符串传输到config和环境变量中,而不是单独传输client_id和client_secret对。

    数字发展部的证书

    GigaChat API 使用 NCA 数字发展部颁发的证书。标准可信根存储没有它们,因此当尝试获取访问令牌时,请求失败并显示如下错误:

    self-signed certificate in certificate chain
    

    证书可以安装在操作系统级别 – 然后它们将受到浏览器和系统实用程序的信任。但 OpenCode 运行在 Node 和 Bun 上,因此直接在 NODE_EXTRA_CA_CERTS 变量中指定证书文件更安全、更容易。下载根证书和颁发者证书并将它们放入一个 PEM 文件中:

    curl -s https://gu-st.ru/content/lending/russian_trusted_root_ca_pem.crt -o russian_trusted_root_ca_pem.crt
    curl -s https://gu-st.ru/content/lending/russian_trusted_sub_ca_pem.crt -o russian_trusted_sub_ca_pem.crt
    cat russian_trusted_root_ca_pem.crt russian_trusted_sub_ca_pem.crt > russian_trusted_ca_bundle.pem
    

    该文件可以放置在方便的位置,并且可以在启动代理时指定其完整路径。

    这里有一个问题。下载的文件使用 CRLF 换行符,并且根证书没有尾随换行符。因此,普通的猫将第一个证书的末尾和第二个证书的开头连接成一行:

    -----END CERTIFICATE----------BEGIN CERTIFICATE-----
    

    LibreSSL – 以及 macOS 上的 openssl 系统,让我提醒一下,正是 LibreSSL – 不接受这样的文件并返回错误:

    PEM routines:CRYPTO_internal:bad end line
    

    这意味着仅猫是不够的。每个证书必须首先通过 openssl 运行:它将其重新编码为带有 LF 换行符和最终换行符的规范 PEM,然后才合并:

    openssl x509 -in russian_trusted_root_ca_pem.crt -out russian_trusted_root_ca.pem
    openssl x509 -in russian_trusted_sub_ca_pem.crt -out russian_trusted_sub_ca.pem
    cat russian_trusted_root_ca.pem russian_trusted_sub_ca.pem > russian_trusted_ca_bundle.pem
    

    您可以检查文件是否正在被读取,如下所示:

    openssl x509 -in russian_trusted_ca_bundle.pem -noout -subject
    

    如果证书取自其他来源并采用 DER 或 PKCS#7 格式,它们也可以重新编码为 PEM:

    openssl x509 -in cert.crt -inform DER -outform PEM -out cert.pem
    openssl pkcs7 -print_certs -in bundle.p7b -out cert.pem
    

    连接到 OpenCode

    该提供程序在 opencode.jsonc 配置文件中进行描述。 OpenCode 本身将下载并连接 npm 字段中指定的 npm 包,找到其中的 createGigaChat 工厂并将选项传递给它。通过 API 中的标识符列出模型就足够了。

    该文件可以放置在两个地方:

    • 全局 – ~/.config/opencode/opencode.jsonc。这些设置适用于所有用户项目。
    • 在项目中 – 项目根目录中的 opencode.jsonc。此配置具有更高的优先级,并且可以安全地提交到 git。

    两个文件使用相同的方案并组合在一起:项目文件仅与匹配密钥的全局文件重叠,其余设置将被保存。还支持 .jsonc 扩展名。如果仅某些存储库需要 GigaChat,则将提供程序保留在项目配置中而不是全局配置中会更方便。

    {
      "$schema": "https://opencode.ai/config.json",
      "provider": {
        "gigachat": {
          "npm": "gigachat-ai-sdk-provider",
          "name": "GigaChat",
          "models": {
            "GigaChat-2-Max": { "name": "GigaChat 2 Max" },
            "GigaChat-2-Pro": { "name": "GigaChat 2 Pro" },
            "GigaChat-2": { "name": "GigaChat 2 Lite" },
            "GigaChat": { "name": "GigaChat" }
          }
        }
      }
    }
    

    此处列出了可提供个人密钥的型号。如果您有一个针对个体企业家或有权访问 GigaChat 3 的法人实体的项目,请将 models 方法中的必要标识符添加到 models 块中。

    更方便的做法是不将密钥本身存储在文件中,而是将其传递给环境变量:gigachat-js 包会自动读取它。范围值也可以设置为变量。剩下的就是设置证书的路径并启动代理:

    export GIGACHAT_CREDENTIALS=ваш_ключ_авторизации
    export GIGACHAT_SCOPE=GIGACHAT_API_PERS
    export NODE_EXTRA_CA_CERTS=/путь/к/russian_trusted_ca_bundle.pem
    opencode
    

    此选项也很好,因为秘密不会最终存储在本地 auth.json 存储中:它仅存在于进程的环境中。这对于 CI 和一次性启动来说更加方便。

    模型

    可用模型集取决于范围键。个人密钥 (GIGACHAT_API_PERS) 可用于 GigaChat 和 GigaChat 2 系列:

    • GigaChat – 基本模型。
    • GigaChat-2 – 用于日常任务的快速且轻量级的模型,在界面中显示为 Lite。
    • GigaChat-2-Pro – 针对资源密集型任务的改进模型。
    • GigaChat-2-Max 是使用个人密钥可用的最强大的功能。

    GigaChat 3 系列(GigaChat-3-Ultra、GigaChat-3-Pro、GigaChat3.5-432B-A28B-Reasoning 等开放模型)在控制台目录中可见,但不可用于个人密钥:它需要个人企业家项目或具有 GIGACHAT_API_B2B 或 GIGACHAT_API_CORP 范围的法人实体以及合适的费率。在个人密钥上,这样的模型会响应错误:

    {"status":404,"message":"No such model"}
    

    您可以通过查询模型列表来检查密钥实际输出的内容:

    curl -H "Authorization: Bearer <токен_доступа>" https://gigachat.devices.sberbank.ru/api/v1/models
    

    还有两点。 API 中的模型 ID 与显示的名称不匹配 – 轻型模型称为 GigaChat-2,而不是 GigaChat-2-Lite。并且控制台中的目录不会显示与您的密钥可用的内容相同的内容,因此您应该关注模型方法的响应,而不是价格列表。

    在界面中,使用以下命令打开模型列表:

    /models
    

    对于存储库中的日常工作 – 浏览文件、较小的编辑、运行测试 – GigaChat-2 已经足够了。对于复杂的任务和设计,切换到 Pro 或 Max 是有意义的。

    项目中首次启动

    转到项目目录并启动代理:

    cd ваш_проект
    opencode
    

    第一步是初始化代理:

    /init
    

    OpenCode 将分析项目结构并创建一个文件 AGENTS.md – 代理指令。该文件值得提交到 git:它可以帮助代理理解项目中采用的约定和模式。

    替代方案:本地代理

    如果由于某种原因您不想使用 npm 提供程序,本地代理会给出相同的结果。 GigaChat 团队拥有官方 gpt2giga – FastAPI 服务,可将 OpenAI、Anthropic 和 Gemini 格式的请求转换为 GigaChat API 并更新访问令牌本身。它在端口 8090 上本地引发,之后通过 @ai-sdk/openai-company 包在 OpenCode 中配置常规 OpenAI 兼容提供程序,其基地址为 http://localhost:8090/v1。此路径的缺点是您还需要在 OpenCode 旁边保留一个正在运行的 Python 服务。

    {
      "$schema": "https://opencode.ai/config.json",
      "provider": {
        "gigachat": {
          "npm": "@ai-sdk/openai-compatible",
          "name": "GigaChat (proxy)",
          "options": {
            "baseURL": "http://localhost:8090/v1"
          },
          "models": {
            "GigaChat-2-Max": { "name": "GigaChat 2 Max" }
          }
        }
      }
    }
    

    DeepSeek 和其他模型(通过 Cloud.ru)

    GigaChat API 本身没有 DeepSeek 模型:只有 GigaChat 系列和用于嵌入的模型。如果您需要 OpenCode 中的 DeepSeek,但需要通过俄罗斯云网关,则 Cloud.ru 的 Foundation Models 服务比较合适。它使用 OpenAI 兼容协议提供模型,因此使用标准 @ai-sdk/openai-company 包进行连接。

    例如,在 Cloud.ru 基础模型目录中,有以下模型:

    deepseek-ai/DeepSeek-V4.1-Flash
    deepseek-ai/DeepSeek-V4-Flash
    deepseek-ai/DeepSeek-V4-Pro
    

    密钥在 Cloud.ru 控制台中颁发:“用户”部分,“服务帐户”选项卡。我们创建一个项目级服务帐户,然后在其凭据中使用 Foundation Models 服务创建一个 API 密钥。密钥显示一次,我们保存它。

    opencode.json 中的提供程序配置如下所示:

    {
      "$schema": "https://opencode.ai/config.json",
      "provider": {
        "cloudru": {
          "npm": "@ai-sdk/openai-compatible",
          "name": "Cloud.ru Foundation Models",
          "options": {
            "baseURL": "https://foundation-models.api.cloud.ru/v1",
            "apiKey": "{env:CLOUDRU_API_KEY}"
          },
          "models": {
            "deepseek-ai/DeepSeek-V4.1-Flash": { "name": "DeepSeek V4.1 Flash", "limit": { "context": 1048576, "output": 1048576 } },
            "deepseek-ai/DeepSeek-V4-Flash": { "name": "DeepSeek V4 Flash", "limit": { "context": 1048576, "output": 1048576 } },
            "deepseek-ai/DeepSeek-V4-Pro": { "name": "DeepSeek V4 Pro", "limit": { "context": 1048576, "output": 1048576 } }
          }
        }
      }
    }
    

    我们将密钥传递给环境变量:

    export CLOUDRU_API_KEY=ваш_ключ_cloudru
    opencode
    

    这里不需要数字发展部证书:api.cloud.ru 域具有常规 TLS,与 GigaChat 不同。但值得监控项目的平衡。如果帐户为零,则授权通过,请求将随计费响应一起丢弃:

    {"message":"Not enough money"}
    

    这不是配置错误,而是您需要在 Cloud.ru 控制台中更新项目的信号。

    需要注意什么

    首次设置时最常遇到的几个实际问题:

    • 证书验证错误。有关链中自签名证书的消息意味着未选取 NODE_EXTRA_CA_CERTS 变量。检查文件的路径、代理是否在同一环境中运行以及文件本身:如果使用 cat 合并两个证书时,它们的末尾位于同一行,LibreSSL 将返回错误的结束行,并且需要通过 openssl 重建捆绑包,如有关证书的部分中所示。
    • 错误 401。 一般来说,这是一个不正确的授权密钥或不匹配的范围 – 对于个人,您需要 GIGACHAT_API_PERS。
    • 错误 404,并显示文本“没有这样的模型”。这不是连接失败,而是无法访问特定模型。从配置中删除它或将其替换为可用的配置。在像 GigaChat 404: Unknown error 这样的消息中,同样的 GigaChat 响应是罪魁祸首 – 提供程序根本无法解析错误正文。
    • 成本。OpenCode 不需要订阅:您在花费代币时直接向 GigaChat 付款,因此长时间会话的价格是可以预测的。
    • 模型质量。对于复杂的架构任务,不同类别的模型有所不同,因此对于设计来说,采用更强大的模型并将例程交给更快的模型是有意义的。

    链接

    https://opencode.ai/
    https://opencode.ai/docs/providers/
    https://developers.sber.ru/studio/
    https://developers.sber.ru/docs/ru/gigachat/guides/main
    https://github.com/nyddle/gigachat-ai-sdk-provider
    https://github.com/ai-forever/gpt2giga
    https://cloud.ru/docs/foundation-models/ug/topics/quickstart

    来源

    https://opencode.ai/docs/providers/#custom-provider
    https://developers.sber.ru/docs/ru/gigachat/certificates
    https://developers.sber.ru/docs/ru/gigachat/models/main
    https://developers.sber.ru/docs/ru/gigachat/guides/selecting-a-model
    https://github.com/nyddle/gigachat-ai-sdk-provider
    https://github.com/ai-forever/gpt2giga
    https://cloud.ru/docs/foundation-models/ug/topics/quickstart
    https://cloud.ru/docs/foundation-models/ug/topics/overview__available__models

  • AirLLM:弱显卡上的大型语言模型

    通常,运行具有 700 亿个参数的大型语言模型需要数十 GB 的视频内存。 AirLLM 更冷静地处理这个问题,并提供了一种不同的方式:这样的模型可以在只有 4 GB 内存的显卡上运行,并且不需要量化、蒸馏和修剪。在这篇文章中,我将尝试不慌不忙地告诉您 AirLLM 是如何工作的,如何使用它,并且我将分享我的小项目 AirLLM-experiments,这使得使用这个库更加方便。

    什么是 AirLLM

    AirLLM 是由 Gavin Li 编写的大型语言模型推理开源库。它的想法简单而优雅:该库一次仅将一层加载到 GPU 上,而不是将所有模型权重一次存储在视频内存中。权重以切分成层的分片的形式存储在磁盘上,在生成过程中,每层依次加载、处理和卸载。

    由此可见,所需的视频内存量并不取决于模型的整体大小,而是取决于其中一层的大小。这就是为什么 70B 型号适合 4 GB,671B 上的 DeepSeek-V3 适合约 12 GB,而 Qwen3-235B 适合约 3 GB。但模型本身的大小主要受磁盘空间的限制,而不是显卡的功能。

    这些内存节省是以速度为代价的:生成每个令牌时都会从磁盘读取每个层,因此输出很慢,每个令牌大约需要几秒。因此,AirLLM 不再是快速互动聊天,而是甚至能够启动不适合硬件的模型。

    安装

    该库是使用常用命令从 PyPI 安装的:

    pip install airllm
    

    首次启动时,模型将从 Hugging Face 下载并分解为图层。此过程很慢并且占用大量磁盘空间,因此您应该提前准备好可用空间。如果需要,您可以启用 4 位或 8 位压缩 – 然后将块量化应用于权重,这将使从磁盘加载图层的速度提高约三倍,并且精度会损失很多。

    基本示例

    您使用 AirLLM 的方式与使用 Transformer 中的常规模型几乎相同。在Hugging Face上输入一次模型ID就足够了,然后一切就会很熟悉了:

    from airllm import AutoModel
    
    MAX_LENGTH = 128
    model = AutoModel.from_pretrained("Qwen/Qwen3-32B")
    
    input_text = ['What is the capital of United States?']
    
    input_tokens = model.tokenizer(
        input_text,
        return_tensors="pt",
        return_attention_mask=False,
        truncation=True,
        max_length=MAX_LENGTH,
        padding=False)
    
    generation_output = model.generate(
        input_tokens['input_ids'].cuda(),
        max_new_tokens=20,
        use_cache=True,
        return_dict_in_generate=True)
    
    print(model.tokenizer.decode(generation_output.sequences[0]))
    

    AutoModel 类本身决定模型类型,因此同一行可用于 Llama、Qwen 和 DeepSeek。如果你采用像 DeepSeek-V3 这样具有 671B 参数的模型,它也将适合大约 12 GB 的视频内存 – 这在很大程度上使该项目具有吸引力。

    在 macOS 上启动

    AirLLM 不仅可以在 CUDA 上运行,还可以在 Apple Silicon 上运行。在 macOS 上,它使用 MLX 后端,因此需要安装 mlx 和 torch,并且仅支持 Apple 芯片。还有一个小限制:MLX 实现仅支持类似 Llama 的架构,因此 Qwen 和类似型号无法以这种方式在 MacBook 上启动。

    使用示例

    AirLLM 实验是两个小型交互式控制台实用程序,用于在本地运行大型语言模型。它们无需每次都编写相同的代码来加载模型和组织聊天。

    第一个工具airllm-lib-usage.py直接在当前Python进程中运行AirLLM库。它显示总目录中模型的编号列表,如有必要,它会安装缺少的依赖项并打开聊天会话。 MLX运行时在macOS上使用,torch在其他平台上使用。

    第二个工具是airllm-openai-server-client.py,可帮助您使用airllm-openai-server服务器,该服务器在Docker中运行并提供与OpenAI兼容的API。当您第一次启动它时,该实用程序会要求设置、收集图像、拾取容器并向正在运行的服务器打开流式聊天。当重复启动时,它会找到一个现有的容器并简单地重用它,并将模型缓存存储在单独的 Docker 卷中,以免再次下载模型。

    可用模型的列表包含在公共模块 model_catalog.py 中,因此这两个工具都可以使用同一组模型。聊天命令也很常见:/help、/clear、/exit。源代码和说明位于存储库中:

    https://github.com/zefir1990/AirLLM-experiments

    需要注意什么

    第一个响应可能需要几分钟的时间来准备:首先,AirLLM 下载模型并将其分层,然后才开始生成。此外,速度仍然很低——这是为了节省内存而故意做出的妥协。对于像 meta-llama 这样的门控模型,您需要接受 Hugging Face 上的条款并传递访问令牌。最好不要删除下载的模型和分片的缓存,否则所有内容都必须重新下载。

    链接

    https://github.com/lyogavin/airllm
    https://github.com/mkamranr/airllm-openai-server
    https://github.com/zefir1990/AirLLM-experiments
    https://pypi.org/project/airllm/
    https://huggingface.co/

    来源

    https://github.com/lyogavin/airllm
    https://github.com/zefir1990/AirLLM-experiments

  • 安装 OpenCode 并连接 DeepSeek

    OpenCode 是一个位于终端中的开放编程代理。它可以读取项目文件、编辑代码、运行命令和测试、搜索存储库并使用 git – 与 Claude Code 和其他控制台代理所做的事情大致相同。主要区别在于 OpenCode 不依赖于一个模型提供者:可以通过它连接数十个提供者,包括 DeepSeek。在这篇文章中,我将描述安装代理并将 DeepSeek 连接到它。

    你需要什么

    你只需要做两件事就可以工作:

    • 现代终端。 WezTerm、Alacritty、Ghostty、Kitty 或任何其他终端都可以。
    • 提供商的 API 密钥。在我们的示例中为 DeepSeek。

    如果您使用标准安装脚本安装代理,则不需要 Node.js – 二进制文件已准备好。

    安装

    最简单的方法是官方安装脚本:

    curl -fsSL https://opencode.ai/install | bash
    

    它将检测平台本身并将可执行文件放入 PATH 中。安装后,您应该检查一切是否就位:

    opencode --version
    

    如果命令显示版本,则安装成功。

    使用其他方法安装

    如果您更喜欢包管理器,有多种选择。通过 Node.js:

    npm install -g opencode-ai
    

    Bun、pnpm 和 Yarn 也可以做同样的事情:

    bun install -g opencode-ai
    pnpm install -g opencode-ai
    yarn global add opencode-ai
    

    macOS 和 Linux 有 Homebrew。请注意:这是开发人员推荐的公式,而不是官方公式 – 它更新频率较低:

    brew install anomalyco/tap/opencode
    

    在 Arch Linux 上:

    sudo pacman -S opencode
    paru -S opencode-bin
    

    第一个命令从存储库安装稳定版本,第二个命令从 AUR 安装最新版本。

    在 Windows 上安装

    在 Windows 中,建议通过 WSL 工作:这样性能更高,并且与代理功能的兼容性更完整。但也有本地方法。通过 Chocolatey、Scoop 或 npm:

    choco install opencode
    scoop install opencode
    npm install -g opencode-ai
    

    还有一个通过 Mise 以及 Docker 容器的选项:

    mise use -g github:anomalyco/opencode
    docker run -it --rm ghcr.io/anomalyco/opencode
    

    最后,完成的二进制文件始终可以从 GitHub 上的发布页面获取。

    DeepSeek 键

    密钥在您的 DeepSeek 个人帐户中创建。转到 platform.deepseek.com,打开包含 API 密钥的部分,然后单击“创建新密钥”。最好立即保存结果字符串:它只会显示一次。

    DeepSeek 连接

    然后一切都在代理本身内部完成。在终端中启动 OpenCode:

    opencode
    

    在界面中我们执行连接命令:

    /connect
    

    在打开的提供商列表中,查找 DeepSeek,选择它并插入 API 密钥。以这种方式添加的密钥将保存到文件中:

    ~/.local/share/opencode/auth.json
    

    连接后,剩下的就是使用以下命令选择模型:

    /models
    

    DeepSeek 型号将出现在列表中,包括 deepseek-v4-pro、deepseek-flash 和 deepseek-v4-flash。对于存储库中的日常工作,闪存选项就足够了;对于复杂的任务,切换到专业版是有意义的。

    通过config进行配置

    如果您不想通过 master 存储密钥或需要设置自己的 API 地址,则直接在 opencode.json 配置文件中描述提供程序:

    {
      "$schema": "https://opencode.ai/config.json",
      "provider": {
        "deepseek": {
          "options": {
            "baseURL": "https://api.deepseek.com"
          }
        }
      }
    }
    

    如果您通过代理或您自己的网关,则 baseURL 字段非常有用。在这种情况下,将密钥本身传输到环境变量会很方便:

    export DEEPSEEK_API_KEY=ваш_ключ_deepseek
    opencode
    

    此选项适用于 CI 和一次性启动:密钥最终不会存储在存储中,而是仅存在于流程环境中。

    项目中首次启动

    转到项目目录并启动代理:

    cd ваш_проект
    opencode
    

    第一步是初始化它:

    /init
    

    OpenCode 将分析项目结构并创建一个文件 AGENTS.md – 代理指令的模拟。该文件值得提交到 git:它可以帮助代理理解项目中采用的约定和模式。

    如何使用

    这项工作的结构与其他代理的结构大致相同。您应该立即了解的一些技巧:

    • 规划模式。Tab 键可在规划模式和装配模式之间切换代理。第一个,他只是建议如何解决问题,并没有改变任何东西 – 在做出改变之前检查想法很方便。
    • 文件链接。@ 键可打开项目文件的模糊搜索,以将特定文件传输到上下文中的代理。
    • 回滚更改。/undo命令撤消最后的编辑并返回原始请求,/redo将它们返回。您可以连续回滚多个步骤。
    • 共享对话。/share 命令创建当前对话的链接并将其复制到剪贴板。默认情况下,对话不会在任何地方发布。

    对于简单的更改,您不必切换到计划模式,而是立即描述需要做什么并通过@指定文件。

    需要注意什么

    几个实际要点。 OpenCode 不需要订阅:您在花费代币时直接向提供商付款,因此 DeepSeek 的长时间会话可以预见比顶级模型便宜。密钥本地存储在 auth.json 中 – 这在共享计算机上值得考虑,但对于其他人的环境,环境变量更可靠。

    还有一件事:不同类别的模型之间复杂架构问题的答案质量有所不同,因此对于设计而言,采用更强大的模型是有意义的,而将例程交给快速且廉价的模型。

    链接

    https://opencode.ai/
    https://opencode.ai/docs/
    https://opencode.ai/docs/providers/
    https://github.com/anomalyco/opencode
    https://platform.deepseek.com/api_keys
    https://api-docs.deepseek.com

    来源

    https://opencode.ai/docs/
    https://opencode.ai/docs/providers/#deepseek
    https://github.com/anomalyco/opencode/releases
    https://models.dev/

  • 在配备 M2 处理器的 MacBook 上安装 Asahi Linux

    在配备 Apple Silicon 处理器的 Mac 上,您无法以通常的方式安装 Linux:这里不可能从闪存驱动器启动,而且启动加载程序是由 Apple 签名的。 Asahi Linux 项目致力于解决这个问题 – 其参与者使用逆向工程使 M1 和 M2 硬件在常规 Linux 下工作。现在该项目的旗舰发行版是 Fedora Asahi Remix,它在 M2 上运行得非常可靠。在这篇文章中,我将逐步描述安装过程。

    什么是 Asahi Linux

    该项目始于 2020 年,当时苹果改用自己的芯片,并随之而来的是封闭式启动方案:该设备仅运行苹果签名的代码。 Asahi Linux 参与者编写了他们的 m1n1 引导加载程序,并在其之上编写了 U-Boot 和 UEFI 环境。接下来,加载最常见的 ARM64 系统,但带有 linux-asahi 内核,其中添加了非标准 Apple 硬件的驱动程序:GPU、视频、声音、相机单元。

    实际上,它看起来像这样:您从 macOS 运行安装程序,它对磁盘进行分区,安装引导链和系统。 macOS 保持不变,您可以在打开时获得双重启动并选择您的系统。

    要求

    • 采用 M2 芯片的 Mac – MacBook Air、MacBook Pro 13 英寸,以及配备 M2 Pro 和 M2 Max 的 14 英寸和 16 英寸。还支持 M1 汽车。
    • 当前的 macOS。安装程序需要最新版本的系统,因此请在开始之前进行更新。
    • 可用空间。至少约 30 GB,舒适 – 100 GB 或更多。该空间与 APFS 容器隔离,不会自行恢复。
    • macOS 管理员密码。在分区期间和首次启动进入恢复模式时都需要它。
    • 备份。磁盘分区是一项最好从全新备份开始的操作。

    第 1 步.备份和更新

    通过时间机器或任何其他方法制作副本。将 macOS 更新到可用的最新版本并重新启动。如果启用了 FileVault,则在恢复模式的启动阶段仍需要密码 – 安装程序需要解锁驱动器。

    第 2 步:启动安装程序

    在 macOS 上打开终端并运行一个命令:

    curl https://alx.sh | sh
    

    这是该项目的官方安装程序。它会自行下载,检查您的 Mac 型号并提供选择发行版的机会。还有一个直接用于 Fedora 的选项:

    curl https://fedora-asahi-remix.org/install | sh
    

    第一个选项更好:它显示当前可用的系统,并且还提供桌面选择。

    步骤3.磁盘分区

    安装程序将要求输入管理员密码并显示当前布局。然后对话如下所示:

    • 按 r 调整 macOS 分区的大小。
    • 输入新 Linux 分区的大小。它可以以千兆字节为单位,也可以是磁盘的百分比,或者您可以写入 min – 那么最小的可能部分将被切断。
    • 用字母y确认标记。这一步最长:系统物理移动APFS容器中的数据;在大磁盘上,这需要几分钟。
    • 按 f 将安装程序指向新创建的空闲分区。

    了解正在发生的事情很重要:Linux 没有安装在 APFS 内部,而是安装在旁边的单独分区上。这就是为什么 macOS 保持不变,回滚减少为删除此部分。

    第 4 步:选择发行版和桌面

    接下来,安装程序将提供系统和桌面环境。 Fedora Asahi Remix 默认附带 KDE Plasma – 它是最先接收更新的旗舰选项。另一种选择是 GNOME,它的感觉更接近 macOS。如果您不需要图形环境,还有一个最小图像。

    步骤 5. 首次在恢复模式下启动

    分区后,安装程序将提示您继续,然后 Mac 将关闭。这是最不寻常的部分:

    • 等待至少 25 秒 – 这是 Apple 进入恢复模式的要求。
    • 按住电源按钮,直到出现启动选项。
    • 选择安装卷并输入您的 macOS 密码。

    在此步骤中,引导链安装在服务分区:m1n1、U-Boot 和 UEFI 环境中。然后机器将再次重新启动 – 再次按住电源按钮并选择新卷,这次进入系统。将会有多次这样的重启,每次都需要手动选择:默认情况下,Mac 会继续加载 macOS。

    第6步.安装系统

    接下来,初始设置向导启动:系统名称、用户、密码、时区、键盘布局。之后,安装本身开始,并且它已经来自互联网 – 您将需要稳定的连接,并且需要十五分钟到半小时的时间。

    安装完成后,重新启动并从启动菜单中选择 Linux。当您首次登录时,系统会提示您完成设置和更新。

    什么有效,什么无效

    在安装之前,你应该清醒地评估你会损失什么。在M2笔记本上情况如下:

    作品:

    • Wi-Fi 和蓝牙 – 无限制。
    • 集成屏幕和图形 – 硬件加速,包括 OpenGL 和 Vulkan。
    • MacBook Air 和 MacBook Pro 上的网络摄像头、麦克风和扬声器。
    • 睡眠模式 – 正常工作。
    • 硬件视频解码 – 播放器不加载处理器。
    • USB 端口,包括通过 Thunderbolt 连接器的 USB 2 和 USB 3。

    不起作用或部分起作用:

    • 触摸 ID。指纹在 Linux 中不可用 – 使用密码登录。
    • Thunderbolt (USB4)。状态 – 正在开发中。不幸的是,专门需要 Thunderbolt 的设备将无法工作。
    • 通过 USB-C 的外部显示器。 DisplayPort Alt 模式也正在运行。 M2 笔记本电脑没有 HDMI 端口,因此无法连接外部屏幕。配备 M2 Pro 和 M2 Max 的型号具有 HDMI,并且可以正常工作。 USB-C 的解决方法位于下面的 Fairydust 核心部分。
    • 硬件视频编码已在计划中,解码已到位。

    简而言之,它是一个非常适合处理代码、终端、浏览器和本地模型的系统,但不适用于外部显示器底座。

    通过 Fairydust 核心的外部监视器

    USB-C 图像输出可在 Asahi Linux 团队的实验性 Fairydust 内核分支中使用。手动组装需要很长时间,因此使用 asahi-fairydust-display 项目中的包装器脚本更容易:

    git clone https://github.com/bharambetejas/asahi-fairydust-display
    cd asahi-fairydust-display
    chmod +x asahi-fairydust-build.sh
    ./asahi-fairydust-build.sh
    

    该脚本克隆 Fairydust 分支,配置并组装内核,将其放置在标准内核旁边并编辑 GRUB。您需要 15 GB 可用空间、USB-C → HDMI 或 DisplayPort 适配器以及 60-90 分钟的组装时间。重新启动后,在 GRUB 中选择标记为 -fairydust 的内核,并将适配器插入最前面的 USB-C 端口。

    下载后检查:

    uname -r
    glxinfo | grep "OpenGL renderer"
    xrandr
    

    第一个命令应显示带有后缀 -fairydust 的版本,第二个命令应显示 Apple M2,而不是 llvmpipe,第三个命令应显示连接的 DP-1 输出。

    预订。该分支是实验性的,不受官方支持。输出仅通过一个 USB-C 端口工作,并且并不总是能够承受热插拔 – 在已插入适配器的情况下重新启动会更安全。该脚本不会自动配置显示:其中相应的步骤被禁用,因为它导致了 Wayland 上的登录循环。通过 dnf 更新库存内核会重新排列 /boot/dtb 符号链接,这就是输出可能默默停止工作的原因 – 然后必须重复构建。

    标准内核不受影响:要返回,只需在 GRUB 菜单中选择它即可。

    外部驱动器而不是升级

    这是好的一面。 MacBook 无法升级:内存和存储设备焊接在主板上,容量在购买时就选定了。在 macOS 中,外部驱动器仍然是外部的 – 系统和应用程序无法真正转移到它。

    在 Linux 中,这一限制被消除:通过 USB 的外部 SSD 是常规块设备,任何挂载点都可以通过 /etc/fstab 传输到它。如果您想转移您的主目录、Steam 库、虚拟机映像或本地模型,请这样做。事实证明,这正是这款车所没有的升级。

    看起来像这样。首先,查看所需分区的UUID:

    lsblk -f
    sudo blkid
    

    然后将行添加到 /etc/fstab:

    UUID=ваш-uuid  /home  ext4  defaults,nofail  0  2
    

    传输本身是通过复制完成的:将数据移动到外部驱动器,然后将其安装在所需的位置。通常情况下,并不是整个 /home 都会以这种方式被拿走,而是个别的重型目录 – 这样风险就会更小。

    有几点需要注意。选项中值得设置nofail参数:没有它,如果磁盘未连接,系统将无法启动。 USB驱动器的速度仍然低于内置NVMe,因此最好在内部磁盘上留出空间以供频繁的I/O操作。并且在移动安装有目录的磁盘时无需拉出磁盘 – 首先卸载它。

    如何在系统之间切换

    当您打开它时,按住电源按钮 – 将出现启动菜单,其中包含 macOS 和 Linux。您可以选择macOS中的默认系统:“系统偏好设置”→“常规”→“系统磁盘”。 Linux也有相应的设置,这样就可以在没有终端的情况下进行双向切换。

    链接

    https://asahilinux.org/fedora/
    https://asahilinux.org/docs/
    https://asahilinux.org/docs/platform/feature-support/m2/
    https://fedoraproject.org/asahi-remix
    https://github.com/bharambetejas/asahi-fairydust-display
    https://github.com/AsahiLinux/linux/tree/fairydust

    来源

    https://asahilinux.org/docs/platform/feature-support/m2/
    https://discussion.fedoraproject.org/t/fedora-asahi-remix-installation-guide/
    https://github.com/AsahiLinux/docs
    https://github.com/bharambetejas/asahi-fairydust-display/blob/main/README.md
    https://github.com/bharambetejas/asahi-fairydust-display/blob/main/asahi-fairydust-build.sh

  • 在 ARM Mac 上安装带有来宾添加的 VirtualBox

    有关在具有 ARM64 处理器的 Mac 上的 VirtualBox 中安装 Ubuntu Server 并连接 Guest Additions 的说明。

    安装 VirtualBox

    下载 VirtualBox 的 ARM64 版本,安装映像并将 VirtualBox.app 传输到应用程序。

    配置虚拟机

    我们创建一台新机器,指定Linux类型和Ubuntu版本(64位ARM)。在设置中我们设置:

    • TPM – 禁用
    • UEFI – 禁用
    • RAM – 4096 MB。
    • 图形控制器 – VMSVGA(用于 VBoxLinuxAdditions)。
    • 处理器 – 4 核。

    安装 Ubuntu 服务器

    将 ARM64 的 Ubuntu Server ISO 映像挂载到 CD-ROM 驱动器中。在下载部分,将光驱放在列表中的第一位。我们启动机器并安装 Ubuntu Server。

    安装 xubuntu-desktop

    安装XFCE图形环境:

    sudo apt update
    sudo apt install -y xubuntu-desktop
    

    在登录管理器选择对话框中,选择 lightdm。

    重新启动访客系统:

    sudo reboot
    

    来宾添加

    首次启动后,安装用于构建内核模块的软件包:

    sudo apt update
    sudo apt install -y build-essential linux-headers-$(uname -r)
    

    我们通过 VirtualBox 菜单安装带有 Guest Additions 的磁盘:Devices → Mount Guest Additions 磁盘映像。该磁盘将出现在 guest 虚拟机内的 /media/$USER 目录中。

    在 Xubuntu 中打开终端,进入挂载磁盘的目录并运行安装程序:

    cd /media/$USER/*
    sudo ./VBoxLinuxAdditions-arm64.run
    

    重新启动访客系统:

    sudo reboot
    

    安装后应该如何工作

    我们检查内核模块是否已加载:

    lsmod | grep vbox
    

    输出应包括 vboxguest 和 vboxsf。

    在计算机属性中添加共享文件夹并将其安装在来宾中:

    sudo mkdir -p /media/sf_shared
    sudo mount -t vboxsf shared /media/sf_shared
    

    工作特点:

    • 共享文件夹 – 主机目录通过 vboxsf 在来宾中可见。
    • 共享剪贴板 – 在主机和访客之间复制文本。
    • 鼠标集成 – 光标自由延伸到机器窗口之外。
    • 自动更改分辨率 – 访客屏幕会根据窗口大小进行调整。
    • 时间同步 – 客人的时间调整为主人的时间。

    来源

    https://www.virtualbox.org/manual/topics/guestadditions.html
    https://forums.virtualbox.org/viewtopic.php?t=112886

  • 如何将 DeepSeek 连接到 Claude Code

    Claude Code 是 Anthropic 的控制台代理,可以读取项目文件、编辑代码、运行命令和测试、搜索存储库以及使用 git。使用它时的主要不便之处在于成本:具有大量上下文的长时间会话很快就会耗尽订阅预算。

    有一个解决方案。 DeepSeek 提供与 Anthropic API 兼容的端点。更改基地址和令牌就足够了,Claude Code 将开始在 DeepSeek 模型上工作,无需任何重新安装或修补。在这篇文章中,我将描述如何在 macOS、Linux 和 Windows 上进行设置。

    为什么需要这个

    原因可能不同:
    – 价格。 DeepSeek 模型明显比 Claude 便宜,并且对于日常代理任务 – 导航项目、较小的编辑、运行测试 – 并不总是需要最高的质量。
    – 可用性。如果您没有订阅或由于某种原因无法使用 Anthropic 卡付款,DeepSeek 将成为一个可行的选择。
    – 实验。比较不同的模型如何在相同的环境中处理相同的代码库是很有趣的。

    你需要什么

    您需要安装 Claude Code 和 DeepSeek API 密钥。如果尚未安装 Claude Code,则顺序如下:
    1. 安装 Node.js 18 或更高版本。在 Windows 上,您还需要 Git for Windows。
    2. 使用以下命令安装 Claude Code 本身。
    3. 检查安装情况。

    npm install -g @anthropic-ai/claude-code
    claude --version
    

    如果显示版本,则说明安装成功。 API 密钥是在您的 DeepSeek 个人帐户的密钥页面上创建的。

    通过环境变量进行配置

    所有集成都归结为环境变量。对于 macOS 和 Linux,它看起来像这样:

    export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
    export ANTHROPIC_AUTH_TOKEN=ваш_ключ_deepseek
    
    export ANTHROPIC_MODEL=deepseek-flash[1m]
    export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
    export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
    export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
    export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
    
    export CLAUDE_CODE_EFFORT_LEVEL=max
    export CLAUDE_CODE_AUTO_COMPACT_WINDOW=786432
    

    对于 Windows 中的 PowerShell,语法不同,但变量名称相同:

    $env:ANTHROPIC_BASE_URL="https://api.deepseek.com/anthropic"
    $env:ANTHROPIC_AUTH_TOKEN="ваш_ключ_deepseek"
    $env:ANTHROPIC_MODEL="deepseek-flash[1m]"
    

    让我们弄清楚这里是什么。 `ANTHROPIC_BASE_URL` 变量将请求从 Anthropic 服务器重定向到 DeepSeek。 `ANTHROPIC_AUTH_TOKEN` 替换您的密钥。其余变量决定哪个模型用于哪个角色。有些模型带有“[1m]”后缀 – 这是一个具有大约一百万个令牌的上下文窗口的选项,它允许代理一次保存更多的项目文件。因此,“CLAUDE_CODE_AUTO_COMPACT_WINDOW”被设置为该窗口的大小,以便自动历史压缩不会过早起作用。

    不用每次都手动导出变量,而是将它们注册到Claude Code配置中,很方便。然后启动时将自动获取设置。

    {
      "env": {
        "ANTHROPIC_BASE_URL": "https://api.deepseek.com/anthropic",
        "ANTHROPIC_AUTH_TOKEN": "ваш_ключ_deepseek",
        "ANTHROPIC_MODEL": "deepseek-flash[1m]",
        "ANTHROPIC_DEFAULT_HAIKU_MODEL": "deepseek-flash",
        "CLAUDE_CODE_SUBAGENT_MODEL": "deepseek-flash"
      }
    }
    

    之后,进入项目目录并运行代理:

    cd ваш_проект
    claude
    

    VS Code 中的克劳德代码

    Claude Code 不仅可以在终端中使用,还可以作为 VS Code 的扩展。它以正常方式安装:使用 Cmd+Shift+X 打开扩展面板,找到“Claude Code”并单击安装。扩展是由 Anthropic 本身产生的。

    该扩展包含自己的 CLI 副本,并且它读取与终端版本相同的 ~/.claude/settings.json 文件。上一节中的设置也适用于此处 – 但有一个警告,这通常会导致混乱。

    启动前进行输入验证

    在开始之前,扩展程序会检查其自己的“claudeCode.environmentVariables”设置中的凭据,而不是来自 settings.json 中的凭据。 settings.json 中的值到达正在运行的进程 – 也就是说,API 地址和选定的模型被正确拾取 – 但它们没有通过扩展程序自己的登录检查。如果您看到登录屏幕,即使终端中的一切都已正常工作,这就是原因。

    这可以通过 VS Code 设置中的几行来解决:复制“claudeCode.environmentVariables”中的变量并禁用登录请求。

    {
      "claudeCode.environmentVariables": [
        { "name": "ANTHROPIC_BASE_URL", "value": "https://api.deepseek.com/anthropic" },
        { "name": "ANTHROPIC_AUTH_TOKEN", "value": "ваш_ключ_deepseek" },
        { "name": "ANTHROPIC_MODEL", "value": "deepseek-flash[1m]" }
      ],
      "claudeCode.disableLoginPrompt": true
    }
    

    macOS 细微差别

    如果从 Dock 或 Finder 启动 VS Code,它不会从 ~/.zshrc 继承环境变量。这是标准 macOS 行为,Claude 代码文档中对此进行了专门讨论。也就是说,在你的 shell 中为扩展使用 `export ANTHROPIC_BASE_URL=…` 根本不起作用 – 这个变量不会在它的环境中。

    由此可以得出两个结论。首先,claudeCode.environmentVariables中的设置比shell变量更可靠。其次,如果您仍然喜欢 shell,请从终端启动编辑器,其中变量已导出:

    code .
    

    什么不起作用

    在第三方提供商上,某些扩展功能不可用,因为它们需要 claude.ai 帐户:
    – 云会话将没有计划使用栏、语音输入和 Web 选项卡;
    – 注销命令不显示在菜单中;
    – `/usage` 将显示当前会话的消耗和代币数量,而不是计划限制;
    – 如果基地址不是 Anthropic,则远程控制不起作用。

    这是预期行为,并不表示安装失败。

    另外,我想补充一点,JetBrains 有自己的插件,但设计不同:它不包含内置 CLI,但启动已安装在集成终端中的插件。没有环境变量的设置,因此您应该使用已导出的变量从终端启动 IDE。

    DeepSeek 如何理解 Claude 模型名称

    Claude Code 在内部引用诸如 claude-opus、claude-sonnet 和 claude-haiku 等名称的模型。 DeepSeek 拦截这些名称并用自己的名称替换它们:
    – 以 claude-opus 开头的所有内容都会转到 deepseek-v4-pro;
    – 以 claude-sonnet 或 claude-haiku 开头的所有内容都会转到 deepseek-flash;
    – 未知型号名称也简化为deepseek-flash。

    这意味着即使没有明确指定模型,集成也将发挥作用 – 但最好明确控制哪些模型以及以什么费率来满足请求。这就是为什么在上面的设置中所有角色都是手动编写的。

    需要注意什么

    兼容性不完整,您应该提前了解这一点。 DeepSeek 简单地忽略了 Anthropic API 的一些功能:

    – 缓存提示。 不支持 `cache_control` 字段。 Claude Code 主动使用缓存,以免重复发送相同的上下文而付出过多的代价。这种情况在这里不会发生,因此长时间会话的价格比您对每个代币价格的预期要高。定期开始新的对话,而不是无休止地继续旧的对话。
    – 思考预算。 支持“thinking”参数,但忽略其中的“budget_tokens”。
    – 杂项。 `top_k`、`service_tier`、`container` 字段以及来自 API 的 MCP 服务器连接也将被忽略。
    – MCP。 尽管代理的常用工具(读取文件、编辑、运行命令、搜索)功能正常,但 DeepSeek 端的内置 MCP 服务器机制不起作用。

    另外,值得一提的是代理。社区中有像“ds-cc-proxy”这样的项目,它们放置在 Claude Code 和 DeepSeek 之间,承担消除轻微不兼容性的任务,以及将主会话和子代理分离到不同的模型中。如果标准设置表现不稳定,这样的中间层可以提供帮助。

    克劳德代码路由器

    上述方法将一个模型应用于所有任务。但代理所做的事情却截然不同:他了解项目的结构,纠正一些小问题,有时还解决一个真正复杂的问题。不同类型的工作应该使用不同的模型是合乎逻辑的。这正是 claude-code-router (CCR) 可以做的事情 – 一个位于 Claude Code 和模型提供者之间的本地网关。

    它给出了什么

    – 按规则路由。您可以设置哪个模型服务于主会话,哪个模型服务于后台任务,哪个模型服务于调度模式。仅在进行复杂推理时才使用昂贵的模型,并将例程交给廉价的模型是有意义的。
    – 备份选项。如果提供程序返回错误,则请求将转到链中的下一个模型,而不是删除会话。
    – 可观察性。界面显示请求日志、延迟、令牌消耗和成本 – 您只能通过直接连接来猜测。
    – 多个代理的一个地址。提供商、密钥和规则位于一处,客户端连接到一个本地地址。

    首先关于版本 – 这很重要

    这里值得警告,因为它会节省您的时间。 CCR 在其历史上经过了大幅重新设计,您在搜索中找到的几乎所有文章都描述了过时的版本。

    在旧版本中,配置位于文件 ~/.claude-code-router/config.json 中,其中包含 Providers 和 Router 块,并且所有内容都是使用“ccr code”命令启动的。现在不再那样了。当前版本 (3.x) 将设置存储在 SQLite 数据库中,并通过 Web 界面进行管理。如果还没有数据库,旧的 config.json 将被读取一次作为迁移源 – 之后,对其进行编辑不会影响任何内容。

    也就是说,如果您在互联网上找到了有关编辑 config.json 和“ccr code”命令的说明,但没有任何效果,那么您正在编辑一个不再有人读取的文件。这不是你的错。

    安装

    您将需要 Node.js 22 或更高版本。

    npm install -g @musistudio/claude-code-router
    ccr ui
    

    `ccr ui` 命令在后台启动服务并在浏览器中打开管理界面。了解其他命令很有用:“ccr start”启动服务,“ccr stop”停止服务,“ccrserve”在前台工作,当您需要查看日志时很方便。

    默认情况下,管理接口位于端口 3458 上,模型的网关本身位于端口 3456 上。

    设置

    一切都在 Web 界面中完成,无需手动编辑文件:
    1. 在 Providers 部分中,添加 DeepSeek 提供程序并指定其密钥。请注意:此处需要直到聊天/完成点的完整地址,而不仅仅是域名。
    2. 在“模型”部分中,描述此模型是什么 – 该描述有助于路由。
    3. 在代理配置部分,设置默认模型。
    4. 在“路由”部分中,配置规则:哪个模型响应哪个请求。
    5. 在 API 密钥页面上,创建 CCR 客户端密钥 – 这是 Claude Code 将使用的密钥,而不是 DeepSeek 密钥。

    之后,剩下的就是将 Claude Code 发送到网关:指定界面中显示的网关地址作为基地址,并将 CCR 客户端密钥作为令牌。

    一件好事:如果逻辑比比较一个字段更复杂,路由规则不仅可以使用字段编写,还可以使用 JavaScript 脚本编写。

    值得使用吗

    将 DeepSeek 连接到 Claude Code 主要是一种在不放弃方便的代理环境的情况下降低成本的方法。您可以获得相同的界面、相同的工具和相同的工作流程,但模型不同。设置需要几分钟,并且是完全可逆的:只需删除环境变量即可返回人类模型。

    局限性也很明显:没有提示缓存、API 字段兼容性不完全、对于复杂的架构任务,模型的质量可能会有所不同。对于存储库中的日常工作 – 导航、重构、运行测试 – 这已经足够了。

    示例:Oni 扩展

    这种组合的一个活生生的例子是我的项目 Oni-Extended,它是 Apple Silicon 游戏 Oni(Bungie,2001)移植版的一个分支。游戏源代码是用C语言编写的,已经存在了二十多年;其中从未进行过任何测试,文件大小以数万行为单位。然而,新功能已通过 DeepSeek 的 Claude Code 添加到该项目中:通过 F5/F9 快速保存和加载、按键保持块以及禁用损坏的 -nodamage 启动标志。

    这很好地说明了上面所说的内容。所有任务都与大型存储库中的日常工作相关 – 代理检查其他人的代码,找到模块之间的联系并测试假设,而不是从头开始设计架构。尽管结果是通过项目自己的基础设施(装配、水平运行台和离线测试)进行验证的,但 DeepSeek 上此类会话的成本明显低于 Anthropic 模型。

    链接

    https://platform.deepseek.com/api_keys
    https://api-docs.deepseek.com
    https://docs.anthropic.com/en/docs/claude-code
    https://github.com/anthropics/claude-code
    https://github.com/musistudio/claude-code-router
    https://ccrdesk.top/en/guides/cli/
    https://github.com/zefir1990/Oni-Extended

    来源

    https://api-docs.deepseek.com/guides/anthropic_api
    https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code
    https://ccrdesk.top/en/routing/
    https://code.claude.com/docs/en/vs-code

  • 《Donki Hills》正式登陆 Steam 已有一年多了!

    《Donki Hills》已经在 Steam 上发布一年多了!

    整整一年前,该项目出现在 Steam 页面上,从那时起,这款游戏已经取得了长足的进步。在此期间,我们进行了许多尝试、改变和探索,寻找Donki Hills应该发展的方向。

    游戏玩法的开发工作仍在继续,现在该项目正在逐渐显现出它的真面目。 《Donki Hills》开始变成它的初衷——喜剧第一人称 Roguelike 模仿生存恐怖游戏。

    这是一场恐怖与幽默、探索和意想不到的情况相遇的奇怪冒险。你必须前往城市,寻找物品,解开谜语,并逐渐揭开通往玛丽亚的秘密。

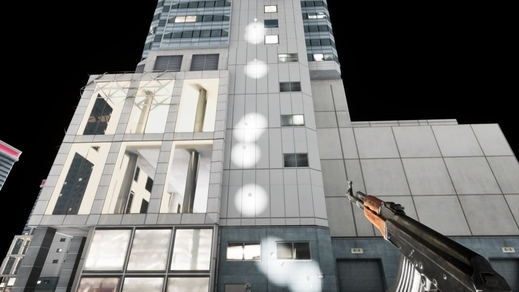
    以下是原型的下一次游戏测试的最新屏幕截图。这还不是游戏的最终外观,但你已经可以感受到城市的氛围以及项目的前进方向。

    很想听听您的反应! 👀
    你觉得新方向怎么样?您对比赛的氛围和理念有何印象?

    感谢所有将 Donki Hills 添加到愿望清单、关注开发并支持该项目的人❤️

    前方还有许多实验、新机制和奇怪的冒险。

    https://store.steampowered.com/app/3476390/Donki_Hills/

  • 绕过游戏笔记本电脑处理器上的节流

    现代游戏笔记本电脑制造商经常配置系统,使处理器在负载下升温至 90 摄氏度,甚至达到 100 摄氏度。这个问题在夏季运行要求较高的游戏或繁重的工作任务时尤其严重。

    由于过热,会激活节流(重置处理器频率以防止物理损坏),这会导致性能急剧下降、冻结和 FPS 下降。解决过热问题的方法有很多(从使用散热垫到降压),但在本文中,我将介绍与 Windows 11 及早期版本的操作系统相关的最简单、最快的方法。

    方法是通过电源设置来限制处理器的最大状态:

    1. 通过 Windows 搜索或控制面板打开电源选项。
    2. 在活动电源计划中,转到更改其他参数的部分。
    3. 找到处理器电源管理分支。
    4. 展开最大处理器状态选项。
    5. 对于已插入,将值从 100% 更改为 80% 或更低。

    应用这些设置后,处理器将不再自动超频到产生过多热量的极端频率。虽然最大峰值性能会下降约20%,但处理器不会再过热。对于系统来说,在没有节流的情况下以降低的频率稳定运行比在 100 度以下的温度下因过热而导致性能持续急剧跳跃要好得多,也更舒适。

    每台笔记本电脑都是独一无二的,因此我建议用户进行试验并找到最佳平衡(百分比),以提供所需的性能而不会过热。

  • 将 Surreal Engine C++ 移植到 WebAssembly

    在这篇文章中,我将描述如何将 Surreal Engine 游戏引擎移植到 WebAssembly。
    https://demensdeum.com/demos/SurrealEngine/”
    超现实引擎–一个游戏引擎,实现了Unreal Engine 1的大部分功能,著名的游戏都使用这个引擎–虚幻竞技场 99、虚幻、杀出重围、不朽。它指的是主要在单线程执行环境中工作的经典引擎。
    我最初的想法是承担一个我无法在任何合理的时间范围内完成的项目,从而向我的 Twitch 粉丝展示即使我也无法完成的项目。在我的第一次直播中,我突然意识到使用 Emscripten 将 Surreal Engine C++ 移植到 WebAssembly 的任务是可行的。

    一个月后,我可以在 WebAssembly 上演示我的前叉和引擎组装:
    https://demensdeum.com/demos/SurrealEngine/
    与原始版本一样,控制是使用键盘箭头进行的。接下来,我计划将其调整为移动控制 (tachi),添加正确的光照和 Unreal Tournament 99 渲染的其他图形功能。

    从哪里开始?

    我想说的第一件事是,任何项目都可以使用 Emscripten 从 C++ 移植到 WebAssembly,唯一的问题是功能有多完整。选择一个其库端口已可用于 Emscripten 的项目;就 Surreal Engine 而言,您非常幸运,因为该引擎使用了 SDL 2、OpenAL –图书馆。它们都被移植到 Emscripten。不过,Vulkan 用作图形 API,目前还无法用于 HTML5,实现 WebGPU 的工作正在进行中,但也处于草案阶段,而且在完全标准化后,从 Vulkan 到 WebGPU 的进一步移植会有多简单也不得而知。因此,我必须为 Surreal Engine 编写自己的基本 OpenGL-ES / WebGL 渲染器。

    构建项目

    在 Surreal Engine 中构建系统 – CMake,这也简化了移植,因为 Emscripten 提供了其本机构建器emcmake,emmake。
    Surreal Engine 端口基于我最新的 WebGL/OpenGL ES 和 C++ 游戏代码,称为 Death-Mask,因此开发更加简单,我随身携带了所有必要的构建标志和代码示例。
    CMakeLists.txt 中最重要的一点是 Emscripten 的构建标志,下面是项目文件中的示例:

    set(CMAKE_CXX_FLAGS "-s MIN_WEBGL_VERSION=2 
    -s MAX_WEBGL_VERSION=2 
    -s EXCEPTION_DEBUG 
    -fexceptions 
    --preload-file UnrealTournament/ 
    --preload-file SurrealEngine.pk3 
    --bind 
    --use-preload-plugins 
    -Wall 
    -Wextra 
    -Werror=return-type 
    -s USE_SDL=2 
    -s ASSERTIONS=1 
    -w 
    -g4 
    -s DISABLE_EXCEPTION_CATCHING=0 
    -O3 
    --no-heap-copy 
    -s ALLOW_MEMORY_GROWTH=1 
    -s EXIT_RUNTIME=1")
    

    构建脚本本身:

    clear
    emmake make -j 16
    cp SurrealEngine.data /srv/http/SurrealEngine/SurrealEngine.data
    cp SurrealEngine.js /srv/http/SurrealEngine/SurrealEngine.js
    cp SurrealEngine.wasm /srv/http/SurrealEngine/SurrealEngine.wasm
    cp ../buildScripts/Emscripten/index.html /srv/http/SurrealEngine/index.html
    

    接下来,让我们准备 index.html,其中包括项目文件系统预加载器。为了上传到网络,我使用了 Unreal Tournament Demo 版本 338。正如您从 CMake 文件中看到的,解压后的游戏文件夹已添加到构建目录中,并作为 Emscripten 的预加载文件进行链接。

    主要代码更改

    然后我们必须改变游戏的游戏循环,不能无限循环,这会导致浏览器冻结,而是需要使用 emscripten_set_main_loop,我在 2017 年的笔记中写过这个功能“将 SDL C++ 游戏移植到 HTML5 (Emscripten)”
    我们将退出 while 循环的代码更改为 if,然后在全局范围内显示包含游戏循环的游戏引擎的主类,并编写一个将从全局对象调用游戏循环步骤的全局函数:

    #if __EMSCRIPTEN__
    #include <emscripten.h>
    Engine *EMSCRIPTEN_GLOBAL_GAME_ENGINE = nullptr;
    void emscripten_game_loop_step() {
    	EMSCRIPTEN_GLOBAL_GAME_ENGINE->Run();
    }
    #endif
    

    之后,您需要确保应用程序中没有后台线程;如果有,那么准备重写它们以进行单线程执行,或者使用 Emscripten 中的 phtread 库。
    Surreal Engine 中的后台线程用于播放音乐,数据来自主引擎线程,有关当前曲目、是否需要播放音乐或缺少音乐,然后后台线程通过互斥体接收新状态并开始播放新音乐或暂停。后台线程还用于在播放期间缓冲音乐。
    我尝试使用 pthread 为 Emscripten 构建 Surreal Engine,但没有成功,因为 SDL2 和 OpenAL 端口是在没有 pthread 支持的情况下构建的,而且我不想为了音乐而重建它们。因此,我使用循环将背景音乐流的功能转移到单线程执行。通过从 C++ 代码中删除 pthread 调用,我将缓冲和音乐播放移至主线程,这样就不会出现延迟,我将缓冲区增加了几秒钟。
    接下来我将描述图形和声音的具体实现。

    不支持 Vulkan!

    是的,HTML5 不支持 Vulkan,尽管所有营销手册都将跨平台和广泛的平台支持作为 Vulkan 的主要优势。因此,我必须为简化的 OpenGL 类型编写自己的基本图形渲染器 – ES,它用在移动设备上,有时它不包含现代OpenGL的时尚功能,但它很好地移植到WebGL,这正是Emscripten实现的。写了基本的tile渲染,bsp渲染,最简单的GUI显示,渲染模型+贴图,两周就完成了。这也许是该项目中最困难的部分。实现超现实引擎渲染的全部功能还有很多工作要做,因此欢迎读者以代码和拉取请求的形式提供任何帮助。

    支持 OpenAL!

    幸运的是,Surreal Engine 使用 OpenAL 进行音频输出。在 OpenAL 中编写了一个简单的 hello world 并使用 Emscripten 在 WebAssembly 中将其组装后,我清楚地意识到一切是多么简单,然后我开始移植声音。
    经过几个小时的调试,我们发现 Emscripten 的 OpenAL 实现存在几个错误,例如,在初始化读取单声道通道数时,该方法返回无限数,在尝试初始化无限大小的向量后,C++ 崩溃并出现异常 vector::length_error。
    我们通过将单声道数量硬编码为 2048 来解决这个问题:

    		alcGetIntegerv(alDevice, ALC_MONO_SOURCES, 1, &monoSources);
    		alcGetIntegerv(alDevice, ALC_STEREO_SOURCES, 1, &stereoSources);
    
    #if __EMSCRIPTEN__
    		monoSources = 2048; // for some reason Emscripten's OpenAL gives infinite monoSources count, bug?
    #endif


    有网络吗?

    Surreal Engine目前不支持在线游戏,支持与机器人一起玩,但我们需要有人为这些机器人编写AI。理论上,你可以使用Websockets在WebAssembly/Emscripten上实现网络游戏。

    结论

    总之,我想说,由于使用了 Emscripten 移植的库,以及我过去在 Emscripten 上使用 C++ 为 WebAssembly 实现游戏的经验,Surreal Engine 的移植非常顺利。以下是有关该主题的知识来源和存储库的链接。
    M-M-M-杀死怪物!
    另外,如果您想帮助该项目,最好使用 WebGL/OpenGL ES 渲染代码,请在 Telegram 中给我写信:
    https://t.me/demenscave

    链接

    https://demensdeum.com/demos/SurrealEngine/

    https://github.com/demensdeum/SurrealEngine-Emscripten

    https://github.com/dpjudas/SurrealEngine

  • 通过 Chisel 在客户端之间进行端口转发:没有 L3 的精简隧道

    当两个设备位于 NAT 或严格的防火墙后面并且无法直接“看到”对方时,VPN 似乎是标准解决方案。但成熟的 L3 隧道(如 WireGuard 或 OpenVPN)通常是多余的:它需要 root 权限、设置虚拟接口,并且可能与现有路由冲突。

    在这种情况下,使用 Chisel 会很方便 – 一种在 HTTP 之上运行并使用 WebSocket 进行数据传输的 TCP/UDP 隧道。在这篇文章中,我将展示如何通过中间服务器将端口从一个客户端“转发”到另一个客户端。

    它是如何工作的?

    想象一下这种情况:您有 客户端 A(例如,您的家庭服务器)、客户端 B(您的工作笔记本电脑)和具有公共 IP 地址的 VPS。客户端A和B可以访问VPS,但不能互相访问。

    转发方案将如下所示:
    1. 客户端 A 连接到 VPS 并在服务器上打开“反向”端口。现在,到达服务器端口 X 的所有内容都会转到客户端 A 的端口 Y。
    2. 客户端 B 连接到 VPS 并将端口 Z 从其本地计算机转发到服务器的端口 X。
    3. 结果,客户端 B 访问 localhost:Z 并最终到达 客户端 A:Y。

    当与 VPS 的通信未实现 L3 层或无法在客户端之间配置路由时,此方法是解决方案之一。我们专门从事应用程序和端口级别的工作。

    第 1 步:启动服务器

    在您的 VPS 上,只需在服务器模式下运行 Chisel 即可。需要 --reverse 标志来允许客户端打开服务器端的端口。

    chisel server --port 8080 --reverse
    

    第 2 步:连接客户端 A(源)

    假设客户 A 希望在端口 3000 上开放对其本地 Web 服务器的访问。他连接到 VPS 并说:“在服务器上保留端口 2000,并将其转发给我到 3000。”

    chisel client vps-ip:8080 R:2000:127.0.0.1:3000
    

    现在,VPS 上的端口 2000(在环回接口上)通向客户端 A。

    第 3 步:连接客户端 B(消费者)

    现在客户端B想要访问这个资源。它连接到同一个VPS并将其本地端口8080转发到服务器的端口2000。

    chisel client vps-ip:8080 8080:127.0.0.1:2000
    

    准备好!现在,当您在客户端 B 上打开 http://localhost:8080 时,您将看到该服务在客户端 A 上运行。

    安全性和细微差别

    Chisel 支持通过 --auth 标志进行身份验证,在通过公共服务器工作时强烈建议这样做。您还可以使用 TLS 证书来加密流量。

    这种方法的主要优点是不需要 TUN/TAP 设备和复杂的路由表。这是一个精简的隧道,只做一件事:通过 WebSocket 连接绑定端口。如果您将 Chisel 配置为通过端口 443 工作,这甚至可以通过公司代理工作。

    输出

    Chisel 是用于特定网络任务的实用程序。当您需要在隔离节点之间转发端口而不设置成熟的 VPN 时,通过中继服务器的正向和反向隧道组合是完全可行的解决方案。

    链接

    https://github.com/jpillora/chisel

  • 为什么我无法修复该错误?

    您花费数小时编写代码,进行假设,调整条件,但错误仍然重现。听起来很熟悉吗?这种沮丧的状态通常被称为“幽灵狩猎”。该程序似乎过着自己的生活,忽略您的更正。

    造成这种情况的最常见且最烦人的原因之一是在应用程序中完全错误的位置寻找错误。

    “虚假症状”的陷阱

    当我们看到错误时,我们的注意力就会被吸引到它“出问题”的地方。但在复杂的系统中,发生错误(崩溃或不正确的值)只是一长串事件的结束。当你试图修复结局时,你是在对抗症状,而不是疾病。

    这就是流程图概念的用武之地。

    它在现实中是如何运作的

    当然,没必要每次都直接在纸上画(画)出流程图,但将其放在脑子里或手边作为架构指南很重要。流程图允许您将应用程序的操作可视化为结果树。

    在不理解这个结构的情况下,开发者常常是在黑暗中摸索。想象一下这种情况:您在一个条件分支中编辑逻辑,而应用程序(由于一组特定参数)转到您甚至没有想到的完全不同的分支。

    <块引用>
    结果:您花费数小时对算法的一个部分进行“完美”代码修复,当然,这对解决算法实际失败的另一部分的问题没有任何作用。

    <小时/>

    击败错误的算法

    要停止敲打紧闭的门,您需要改变诊断方法:

    • 在结果树中查找状态:在编写代码之前,您需要准确确定应用程序所采取的路径。逻辑在什么时候出现了错误?哪个具体状态(状态)导致了该问题?
    • 复制成功率为 80%:这通常由测试人员和自动化测试完成。如果bug是“浮动”的,则开发参与过程中共同寻找条件。
    • 使用尽可能多的信息:日志、操作系统版本、设备参数、连接类型(Wi-Fi/5G)甚至特定的电信运营商对于本地化都很重要。

    错误时刻的“照片”

    理想情况下,要修复它,您需要在重现错误时获取应用程序的完整状态。交互日志也非常重要:它们不仅显示最终点,还显示整个用户路径(失败之前执行了哪些操作)。这有助于理解如何再次重新创建类似的状态。

    未来提示:如果您遇到复杂的情况,请在这部分代码中添加扩展的调试日志记录信息,以防这种情况再次发生。

    <小时/>

    人工智能时代“难以捉摸”的状态问题

    在使用LLM(大型语言模型)的现代系统中,经典决定论(“一个输入,一个输出”)经常被违反。您可以传递完全相同的输入数据,但会得到不同的结果。

    发生这种情况是由于现代生产系统的非决定论:

    • GPU 并行性:GPU 浮点运算并不总是关联的。由于线程并行执行,数字相加的顺序可能会略有变化,这可能会影响结果。
    • GPU 温度和限制:执行速度和负载分布可能取决于硬件的物理状态。在巨大的模型中,这些微观差异会累积,并可能导致在输出时选择不同的标记。
    • 动态批处理:在云端,您的请求会与其他请求合并。不同的批量大小会改变内核中的计算数学。

    在这样的条件下,再现“同样的状态”几乎是不可能的。只有统计测试方法才能拯救您。

    <小时/>

    当逻辑失败时:内存问题

    如果您使用“不安全”语言(C 或 C++),该错误可能会因内存损坏而发生。

    这些是最严重的情况:一个模块中的错误可能会“覆盖”另一个模块中的数据。这会导致完全无法解释的孤立故障,无法使用正常的应用程序逻辑进行追踪。

    如何在架构层面保护自己?

    为了避免这种“神秘”的错误,您应该使用现代方法:

    • 多线程编程模式:清晰的同步消除了竞争条件。
    • 线程安全语言:编译时保证内存安全的工具:
      • Rust:所有权系统消除了内存错误。
      • Swift 6 并发:强大的数据隔离检查。
      • Erlang:通过参与者模型完成进程隔离。

    摘要

    修复错误并不是要编写新代码,而是要了解旧代码是如何工作的。请记住:您可能会浪费时间编辑管理层根本不接触的分支。记录系统状态,考虑AI非确定性因素,选择安全工具。

  • 为什么文档是你最好的朋友

    (以及如何创建在更新后继续有效的解决方案)

    “应用程序只能使用公共 API,并且必须在当前发布的操作系统上运行。”苹果应用程序审查指南

    如果您曾经开始使用新框架并发现自己在想:“现在我自己就能理解所有内容,阅读文档太长了”,那么您绝对不是一个人。我们中的许多人都有一种天生的调查本能:先尝试,然后再查看说明。这是完全正常的。

    然而,在这个阶段,很容易得意忘形,最终陷入代码运行良好但可能依赖于系统的非明显功能的情况。

    为什么有时仅仅“自己解决”还不够?

    框架,尤其是封闭框架,是复杂的、多层的系统。它们经常隐藏内部逻辑和优化:

    * 公共文档中没有描述;
    * 不保证该行为将来会维持;
    * 可能会随着新版本的发布而改变;
    * 可能包含开发人员已知但尚未修复的功能。

    当我们凭直觉行事时,存在根据随机观察而不是根据记录的规则构建架构的风险。这可以使代码对更新更加敏感。

    文档不是限制,而是可靠的支持

    框架开发人员创建手册来帮助我们。在文档中执行操作,我们得到:

    * 稳定;
    * 支持;
    * 可预测的系统行为。

    如果超出这些限制,我们就会承担额外的风险,并且维护此类代码会变得更加困难。

    实验?当然。但要了解边界。
    好奇心是开发人员的一大特质。探索和尝试新事物是绝对必要的。但这里有一个小小的愿望:

    最舒适的实验方法是依赖最佳实践。

    该文档是一张地图,显示哪些路径最安全并受到创建者的支持。

    外部观点:专家建议

    我们经常向经验丰富的同事学习:

    *他们开设有用的课程,
    * 在会议上发言,
    * 写精彩的书籍和博客,
    * 分享他们独特的愿景。

    他们中的许多人分享了真正宝贵的经验。但值得记住的是:如果作者的方法与官方文档相矛盾,它们可能会变得脆弱。

    有时,这种“经验模式”:

    * 仅适用于特定版本的框架;
    * 对更新敏感;
    * 在异常情况下可能会出现不可预测的行为。

    向社区学习是伟大且有益的。但任何建议,即使是最权威的建议,都应该仔细检查官方手册。

    关于 SOLID 的一些知识

    SOLID 原则中的三个想法完美地补充了这种方法:

    * 开放/封闭原则:尝试通过公共 API 扩展行为,如果可能,不依赖隐藏的实现。
    * 里氏替代原则:依赖合同,而不是具体执行。否则,幕后的变化可能会导致意想不到的困难。
    * 依赖倒置:建立对抽象的依赖,而不是细节。

    在实践中,这意味着与框架的内部、未记录的细节相关联会使系统变得脆弱。
    基于公共接口和合约,我们得到:

    * 更好地将代码与框架的更改隔离;
    * 易于测试;
    * 架构的可预测性和可靠性。

    如果出现错误怎么办?

    也有这样的情况,一切都按照规则去做,但结果却没有达到预期。框架不断发展,但并不总是完美的。在这种情况下:

    * 构建一个重现问题的最小示例。
    * 确保仅使用记录的 API。
    * 发送错误报告 – 开发团队一定会感谢您的工作并尽力提供帮助。

    如果该示例依赖于解决方法,那么开发人员提供支持将会更加困难。

    如何充分利用框架

    *请参阅文档。
    * 遵循作者的指南和建议。
    * 在所描述的功能范围内进行实验。
    * 检查来自互联网和官方来源的建议。
    * 本地化错误,同时尊重框架契约。

    结论

    框架是强大的工具,有自己的游戏规则。如果忘记它们,我们的代码就会变得过于脆弱。但我们都希望创建的产品能长久存在,而不是在每次小更新后都需要紧急修正。

    手册和文档是极好的支持,有助于创建真正可靠的解决方案。

    来源

    https://developer.apple.com/app-store/review/guidelines/
    https://en.wikipedia.org/wiki/SOLID
    https://en.wikipedia.org/wiki/API
    https://en.wikipedia.org/wiki/RTFM

  • 在 Linux 上构建适用于 iOS 的 C++ SDL 应用程序

    在这篇文章中,我将描述在 Linux 上为 iOS 构建 C++ SDL 应用程序的过程,在没有付费 Apple Developer 订阅的情况下签署 ipa 存档,以及使用 macOS 在没有越狱的情况下将其安装在干净的设备 (iPad) 上。

    首先,让我们安装 Linux 的构建工具链:
    https://github.com/tpoechtrager/cctools-port

    需要从存储库下载工具链,然后按照Godot Engine网站上的说明完成安装:
    https://docs.godotengine.org/ru/latest/development/compiling/cross-compiling_for_ios_on_linux.html

    目前,您需要下载 Xcode dmg 并从那里复制 sdk 来构建 cctools-port。此阶段在 macOS 上更容易完成;只需从已安装的 Xcode 中复制必要的 sdk 文件即可。成功组装后,终端将包含交叉编译器工具链的路径。
    接下来,您可以开始构建适用于 iOS 的 SDL 应用程序。让我们打开 cmake 并添加必要的更改来构建 C++ 代码:

    SET(CMAKE_SYSTEM_NAME Darwin)
    SET(CMAKE_C_COMPILER arm-apple-darwin11-clang)
    SET(CMAKE_CXX_COMPILER arm-apple-darwin11-clang++)
    SET(CMAKE_LINKER arm-apple-darwin11-ld)


    现在您可以使用 cmake 和 make 进行编译,但不要忘记将 $PATH 添加到交叉编译器工具链:

    
    PATH=$PATH:~/Sources/cctools-port/usage_examples/ios_toolchain/target/bin


    为了与框架和SDL正确链接,我们将它们编写在cmake中,例如游戏Space Jaguar的依赖项:

    
    target_link_libraries(
    ${FSEGT_PROJECT_NAME}
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libclang_rt.ios.a
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libSDL2.a
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libSDL2_mixer.a
    ${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/libSDL2_image.a
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreServices.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/ImageIO.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/Metal.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/AVFoundation.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/GameController.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreMotion.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreGraphics.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/AudioToolbox.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/CoreAudio.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/QuartzCore.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/OpenGLES.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/UIKit.framework"
    "${FLAME_STEEL_PROJECT_ROOT_DIRECTORY}/scripts/buildScripts/ios/resources/libs/Foundation.framework"
    )


    就我而言,SDL、SDL_Image、SDL_mixer 库预先在 macOS 上的 Xcode 中编译以进行静态链接;从 Xcode 复制的框架。还添加了 libclang_rt.ios.a 库,其中包括特定于 iOS 的运行时调用,例如 isOSVersionAtLeast。包含一个用于 OpenGL ES 的宏,禁用移动版本中不支持的功能,类似于 Android。
    解决所有构建问题后,您应该获得 ARM 的已组装二进制文件。接下来,让我们考虑在没有越狱的设备上运行组装的二进制文件。
    在 macOS 上,安装 Xcode,在 Apple 门户上注册,无需支付开发者计划费用。在Xcode中添加帐户->首选项->帐户、创建空白应用程序并在真实设备上构建。在组装过程中,设备将被添加到您的免费​​开发者帐户中。组装并启动后,需要构建存档;为此,请选择通用 iOS 设备和产品 ->档案。构建存档后,从中提取embedded.mobileprovision和PkgInfo文件。从设备的构建日志中,找到具有正确签名密钥的 codesign 行、扩展名为 app.xcent 的授权文件的路径,将其复制。
    从存档中复制 .app 文件夹,将存档中的二进制文件替换为 Linux 中交叉编译器编译的二进制文件(例如 SpaceJaguar.app/SpaceJaguar),然后将必要的资源添加到 .app 中,检查存档中 .app 中的 PkgInfo 和Embedded.mobileprovision 文件的完整性,必要时再次复制。我们使用协同设计命令 – 重新签名 .app codesign 需要一个用于签名的输入密钥、权利文件的路径(可以使用 .plist 扩展名重命名)
    重新签名后,创建一个 Payload 文件夹,将扩展名为 .app 的文件夹移至此处,在根目录中创建一个包含 Payload 的 zip 存档,并使用 .ipa 扩展名重命名该存档。之后,在 Xcode 中,打开设备列表并将新的 ipa 拖放到设备的应用程序列表中;通过 Apple Configurator 2 安装不适用于此方法。如果重新签名正确完成,则具有新二进制文件的应用程序将安装在具有 7 天证书的 iOS 设备(例如 iPad)上,这对于测试期来说足够了。

    来源

    https://github.com/tpoechtrager/cctools-port

    https://docs.godotengine.org/ru/latest/development/compiling/cross-compiling_for_ios_on_linux.html

    https://jonnyzzz.com/blog/2018/06/13/link-error-3/

    https://stackoverflow.com/questions/6896029/re-sign-ipa-iphone

    https://developer.apple.com/library/archive/documentation/Security/Conceptual/CodeSigningGuide/Procedures/Procedures.html

  • 在 Ubuntu MinGW CMake 下构建 Windows

    在这篇文章中,我将描述在 Ubuntu 上使用 MinGW32 工具链为 Windows 构建库和应用程序的过程。
    安装wine、mingw:

    sudo apt-get install wine mingw-w64
    

    之后,您就可以为 Windows 构建 C/C++ 应用程序了:

    # C
    i686-w64-mingw32-gcc helloWorld.c -o helloWorld32.exe      # 32-bit
    x86_64-w64-mingw32-gcc helloWorld.c -o helloWorld64.exe    # 64-bit
     
    # C++
    i686-w64-mingw32-g++ helloWorld.cc -o helloWorld32.exe     # 32-bit
    x86_64-w64-mingw32-g++ helloWorld.cc -o helloWorld64.exe   # 64-bit
    

    可以使用wine检查收集到的exe。
    接下来,让我们看看对 CMake 构建、CMakeLists.txt 文件的更改,将 MinGW 特定的内容添加到构建文件中:

    if (MINGW32)
    set(CMAKE_SYSTEM_NAME Windows)
    SET(CMAKE_C_COMPILER i686-w64-mingw32-gcc)
    SET(CMAKE_CXX_COMPILER i686-w64-mingw32-g++)
    SET(CMAKE_RC_COMPILER i686-w64-mingw32-windres)
    set(CMAKE_RANLIB i686-w64-mingw32-ranlib)
    endif()
    
    // для сборки shared dll
    elseif (MINGW32)
    add_library(FlameSteelEngineGameToolkit.dll SHARED ${SOURCE_FILES})
    else()
    
    // обязательно линкуем со всеми зависимостями
    if (MINGW32)
    target_link_libraries(
                            FlameSteelEngineGameToolkit.dll 
                            -static-libgcc
                            -static-libstdc++
                            SDL2 
                            SDL2_mixer 
                            /home/demensdeum/Sources/cube-art-project-bootstrap/FlameSteelFramework/FlameSteelCore/FlameSteelCore.dll
                            /home/demensdeum/Sources/cube-art-project-bootstrap/FlameSteelFramework/FlameSteelBattleHorn/FlameSteelBattleHorn.dll
                            /home/demensdeum/Sources/cube-art-project-bootstrap/FlameSteelFramework/FlameSteelCommonTraits/FlameSteelCommonTraits.dll)
    
    set_target_properties(FlameSteelEngineGameToolkit.dll PROPERTIES
            PREFIX ""
            SUFFIX ""
            LINK_FLAGS "-Wl,--add-stdcall-alias"
            POSITION_INDEPENDENT_CODE 0 # this is to avoid MinGW warning; 
            # MinGW generates position-independent-code for DLL by default
    )
    else()
    

    我们收集:

    cmake -DMINGW32=1 .
    make
    

    输出将是 dll 或 exe,具体取决于您收集的内容。对于一个工作示例,您可以查看新的 Cube-Art-Project 及其库的存储库:
    https://gitlab.com/demensdeum/cube-art-project

    https://gitlab.com/demensdeum/FlameSteelEngineGameToolkitFSGL

    https://gitlab.com/demensdeum/cube-art-project-bootstrap

    来源
    https://arrayfire.com/cross-compile-to-windows-from-linux/

  • 为 Ubuntu OSXCross CMake 构建 macOS 应用程序

    在这篇文章中,我将描述如何使用 CMake 和 osxcross 在 Ubuntu 构建机器上为 macOS 构建跨平台 C++ 应用程序。
    首先,安装osxcross工具链:
    https://github.com/tpoechtrager/osxcross
    安装分 3 个阶段进行,下载依赖项:

    cd tools
    ./get_dependencies.sh
    

    从Apple官方网站下载XCode.xip,然后从XCode下载SDK:

    ./gen_sdk_package_pbzx.sh /media/demensdeum/2CE62A79E62A4404/LinuxSupportStorage/xcode111.xip
    

    希望您阅读最后一步中的 XCode 许可协议?接下来,使用所需的前缀构建工具链:

    INSTALLPREFIX=/home/demensdeum/Apps/osxcross ./build.sh 
    

    现在您可以使用上一步的前缀目录中的 osxcross。让我们为 CMake 添加一个新的构建宏并编写所有必要的内容:

    if (OSXCROSS)
    SET(CMAKE_SYSTEM_NAME Darwin)
    SET(CMAKE_C_COMPILER o64-clang)
    SET(CMAKE_CXX_COMPILER o64-clang++)
    SET(CMAKE_C_COMPILER_AR x86_64-apple-darwin19-ar)
    SET(CMAKE_CXX_COMPILER_AR x86_64-apple-darwin19-ar)
    SET(CMAKE_LINKER x86_64-apple-darwin19-ld)
    SET(ENV{OSXCROSS_MP_INC} 1)
    endif()
    

    动态链接对我来说并不成功,因此我们静态导出库:

    if (OSXCROSS)
    add_library(FlameSteelCore STATIC ${SOURCE_FILES})
    else()
    

    接下来,您可能会面临这样的情况:您没有 osxcross 所需的库,我在使用 SDL2 时遇到过这种情况。 osxcross 支持现成的库包 – macports。例如,安装 SDL2-mixer:

    osxcross-macports -v install libsdl2_mixer
    

    之后,您可以像平常一样在 cmake-make 链接中开始构建库/应用程序,如果需要,不要忘记指定库的静态链接。

    手动组装库

    目前,我遇到了静态链接时库归档不正确的问题;构建最终应用程序时,我收到错误:

    file was built for archive which is not the architecture being linked (x86_64)
    

    与此票证非常相似,我们设法实现了一种解决方法,使构建正确完成。让我们解压缩静态库并使用 osxcross 存档器重新构建它:

    ar x ../libFlameSteelCore.a
    rm ../libFlameSteelCore.a
    x86_64-apple-darwin19-ar rcs ../libFlameSteelCore.a *.o
    

    另外,我个人考虑的问题之一是缺乏在 Ubuntu 上直接运行 macOS 应用程序的能力(至少部分功能)。当然,有一个项目 darling,但支持仍然有很多不足之处。

    来源

    https://github.com/tpoechtrager/osxcross

  • 本地图像生成:ComfyUI 和 FLUX 模型

    如今,您不必依赖云服务:您可以完全在自己的硬件上生成高质量的图像。在这篇文章中,我将描述如何使用 ComfyUI 在计算机上本地运行现代 FLUX 模型。

    ComfyUI 采用基于节点的架构。这使您能够:
    – 完全控制生成的每个阶段。
    – 轻松共享现成的“工作流程”

    FLUX是大型模型,因此硬件要求比SD 1.5或SDXL更高:
    – 显卡 (GPU): Nvidia RTX,具有 12 GB VRAM 或更高(为了舒适工作)。如果您有 8 GB 或更少,则必须使用量化版本(GGUF 或 NF4)。
    – 随机存取存储器 (RAM): 至少 16 GB(最好 32 GB 及以上)。
    – 磁盘空间: 模型和组件大约需要 20–50 GB。

    启动 FLUX 最简单的方法是使用现成的模板。只需在工作流程窗口中搜索 Flux Text to Image 并安装即可。

    在“Text to Image (Flux.1 Dev)”节点中用英文编写提示,选择分辨率(FLUX 适用于 1024×1024 甚至更高),然后按 RUN。

    第一代可能需要一些时间,因为模型将加载到显卡内存中。

    https://github.com/comfyanonymous/ComfyUI

  • 本地 Vibe 编码:LM Studio、VS Code 和 Continue

    如果您希望使用神经网络来帮助编写代码(所谓的 Vibe 编码),并且您有一台相当强大的计算机,例如配备 Nvidia RTX 显卡,那么您可以在您的计算机上完全免费地部署整个环境。这解决了付费订阅的问题,并允许您安全地处理 NDA 下的项目,因为您的代码不会发送到任何地方。在这篇文章中,我将描述如何组装 LM Studio、VS Code 和 Continue 扩展的本地包。

    本地 Vibe 编码工具

    为了舒适的工作,我们需要三个主要组件:
    – LM ​​Studio: 用于下载和运行本地 LLM 的便捷应用程序。它承担了使用 GGUF 模型的所有复杂性,并建立了一个与 OpenAI API 兼容的本地服务器。
    – VS Code: 流行且熟悉的代码编辑器。
    – 继续: VS Code 扩展,将神经网络直接集成到工作环境中。允许您聊天、突出显示代码以进行重构,并支持自动完成。

    硬件要求

    本地语言模型是内存密集型的:
    – 显卡 (GPU): Nvidia,配备 8 GB VRAM 或更高(可轻松处理具有 7-80 亿个参数的模型)。较重的型号将需要 16 GB 的 VRAM。
    – 磁盘空间:约500 GB用于存储各种下载的模型。

    配置链接

    设置过程非常简单,不需要在终端中进行复杂的操作:
    1.下载并安装LM Studio。使用内置搜索查找轻量级模型,例如 Qwen Coder 或 gemma3:12b。
    2. 在 LM Studio 中,转到“本地服务器”选项卡并单击“启动服务器”。默认情况下,它将从“http://localhost:1234/v1”启动。
    3. 打开 VS Code 并从插件商店安装 Continue 扩展。
    4. 打开“继续”配置文件并添加新模型,指定“openai”提供程序以及 LM Studio 中的本地服务器地址。

    然后,您可以直接在“继续”侧栏中与当地的法学硕士进行交流,询问有关您的代码的问题,并生成新的组件。

    为什么会这样?

    正如我之前所写,法学硕士在扁平结构和 WET(将所有内容写入两次)代码方面做得更好。在设计复杂的架构时,局部参数模型可能不如 GPT-4 这样的巨头,但它们完全能够生成样板代码、重构简单功能和快速原型设计。

    此外,通过本地 Vibe 编码,您的代码永远不会离开机器。这使得这种组合非常适合企业发展和处理敏感数据。

    输出

    局部神经网络无法完全取代程序员或设计复杂的系统。然而,LM Studio + VS Code +Continue 的组合提供了独立于云服务的能力并维护了隐私。如果您愿意忍受小模型的限制并独立控制项目架构,那么这是一个用于日常任务的完全可用的辅助工具。

    链接

    https://code.visualstudio.com/
    https://lmstudio.ai/
    https://continue.dev/

    来源

    https://youtu.be/IqqCwhG46jY
    https://www.youtube.com/watch?v=7AImkA96mE8

  • 本地视频生成:ComfyUI 和 LTX-2.3

    以前,使用神经网络创建视频是 Runway 或 Luma 等云服务的特权。如今,如果您拥有现代 Nvidia 显卡,您就可以直接在计算机上生成高质量视频。在这篇文章中,我将告诉您如何使用 ComfyUI 和有效的 LTX-2.3 模型设置本地视频生成。

    视频生成工具

    对于工作,我们需要:
    – ComfyUI:强大的界面,采用基于节点的架构,允许您灵活地自定义生成过程。
    – LTX-2.3: Lightricks 的现代型号,经过优化,可以以相对适中的视频内存要求创建流畅且详细的视频。

    硬件要求

    生成视频是一个比处理图像更加消耗资源的过程:
    – 显卡 (GPU): 具有 8 GB VRAM 的 Nvidia RTX 是 768×512 分辨率的最低要求。为了舒适的操作和更高的分辨率,非常需要 16-24 GB 的 VRAM。
    – 随机存取存储器 (RAM): 至少 32 GB。下载时视频模型和 VAE 会占用大量空间。
    – 磁盘空间: 模型本身和相关组件约 500 GB。

    设置和启动

    ComfyUI中启动LTX-2.3的流程如下:
    1. 更新ComfyUI:该模型相对较新,因此请确保您安装了最新版本的界面。
    2. 安装工作流程:最简单的方法是找到现成的 LTX Video JSON 模板。该模型需要特定的节点来处理视频潜在空间。
    3. 提示和参数:用英文输入场景描述。请注意,LTX-2.3 能够很好地理解运动(例如“摄像机绕轨道运行”、“快速运动”)。

    为什么选择LTX-2.3?

    LTX-2.3 之所以引人注目,是因为它提供的结果与专有云服务相当,但在本地运行。这给你:
    – 完全隐私:您的提示和生成的视频不会发送到其他人的服务器。
    – 控制:您可以尝试帧速率 (FPS)、分辨率和提示强度,而无需为每次尝试付费。

    本地视频生成仍在积极开发中,LTX-2.3 是进入“家庭好莱坞”世界的绝佳入口。

    链接

    https://github.com/comfyanonymous/ComfyUI
    https://huggingface.co/Lightricks/LTX-Video

  • 本地音乐生成:ComfyUI 和 ACE-Step-1.5 模型

    如今,您不必依赖云服务来创建内容:您可以完全在自己的硬件上生成高质量的音乐。在这篇文章中,我将描述如何使用 ComfyUI 在计算机上本地运行现代 ACE-Step-1.5 模型。

    ComfyUI 采用基于节点的架构。这使您能够:
    – 完全控制音频生成的每个阶段。
    – 轻松共享现成的“工作流程”。

    ACE-Step-1.5 是一种高级音乐生成模型,需要大量计算资源。其硬件要求比许多简单的合成器要高:
    – 显卡 (GPU): Nvidia RTX,具有 8 GB VRAM 或更高(建议 12 GB+),可实现舒适的高品质工作。
    – 随机存取存储器 (RAM): 至少 16 GB(最好 32 GB 及以上)。
    – 处理器(CPU):现代多核处理器,对 AVX/CUDA 计算有良好的支持。
    – 磁盘空间: 模型和组件大约需要 20–50 GB。

    运行 ACE-Step-1.5 最简单的方法是使用现成的音频生成模板。只需在工作流程窗口中搜索音乐文本到音频并安装即可。

    在“提示输入”节点中编写描述流派和情绪的提示(例如,“带有重低音的令人振奋的合成波曲目”)。指定所需的持续时间并按运行。
    第一代可能需要一些时间,因为模型将被加载到显卡内存中并处理复杂的声学模式。

    https://github.com/comfyanonymous/ComfyUI
    https://www.youtube.com/watch?v=UAlLD5fS7-c

  • 使用 ollama 的局部神经网络

    如果您希望推出像 ChatGPT 这样的东西,并且您有一台相当强大的计算机,例如配备 Nvidia RTX 显卡,那么您可以运行 ollama 项目,该项目将允许您在本地计算机上使用现成的 LLM 模型之一,而且完全免费。 ollama 提供了与 LLM 模型进行通信的能力,以 ChatGPT 的方式进行;同样在最新版本中,还宣布了读取图像并将输出数据格式化为 json 格式的功能。

    我还在配备 Apple M2 处理器的 MacBook 上运行了该项目,并且我知道 AMD 最新型号的显卡受到支持。

    要在 macOS 上安装,请访问 ollama 网站:
    https://ollama.com/download/mac

    单击“下载 macOS”,您将下载 ollama-darwin.zip 形式的存档,存档内有 Ollama.app,需要将其复制到“应用程序”。之后,启动 Ollama.app,安装过程很可能会在第一次启动时发生。之后,在托盘中您可以看到 ollama 图标,该托盘位于时钟旁边的右上角。

    之后,启动常规 macOS 终端,然后键入命令来下载、安装并运行任何 ollama 模型。可用模型、描述及其特征的列表可以在 ollama 网站上查看:
    https://ollama.com/search

    如果启动时不适合您的显卡,请选择参数最少的型号。

    例如,启动 llama3.1:latest 模型的命令:

    ollama run llama3.1:latest
    

    Windows 和 Linux 的安装通常是相似的,在一种情况下,会有一个 ollama 安装程序,并通过 Powershell 进一步使用它。
    对于 Linux,安装是使用脚本完成的,但我建议使用特定包管理器的版本。在 Linux 上,还可以通过常规 bash 终端启动 ollama。

    来源
    https://www.youtube.com/watch?v=Wjrdr0NU4Sk
    https://ollama.com

  • 使用 ffmpeg 实现视频稳定

    如果您想稳定视频并消除相机抖动,“ffmpeg”工具提供了强大的解决方案。借助内置过滤器“vidstabdetect”和“vidstabtransform”,您无需使用复杂的视频编辑器即可获得专业的效果。

    准备工作

    在开始之前,请确保您的“ffmpeg”支持“vidstab”库。在 Linux 上,您可以使用以下命令进行检查:

    bash  
    ffmpeg -filters | grep vidstab  
    

    如果未安装该库,您可以添加它:

    sudo apt install ffmpeg libvidstab-dev  
    

    通过brew安装macOS:

    brew install libvidstab
    brew install ffmpeg
    

    现在让我们继续该过程。

    第 1 步:运动分析

    首先,您需要分析视频的运动并创建带有稳定参数的文件。

    ffmpeg -i input.mp4 -vf vidstabdetect=shakiness=10:accuracy=15 transfile=transforms.trf -f null -  
    

    参数:

    抖动:视频抖动级别(默认为 5,对于更复杂的情况可以增加到 10)。
    精度:分析精度(默认15)。
    transfile:保存运动参数的文件名。

    第 2 步:应用稳定化

    现在您可以使用转换文件应用稳定性:

    ffmpeg -i input.mp4 -vf vidstabtransform=input=transforms.trf:zoom=5 output.mp4
    

    参数:

    input:指向带有转换参数的文件(在第一步中创建)。
    缩放:用于消除黑边的缩放系数(例如 5 – 自动缩放直至消除伪像)。

  • 图灵计算机

    我向您展示 1936 年艾伦·图灵 (Alan Turing) 文章《论可计算数与解决问题的应用》第一页的译文。第一章包含对计算机的描述,后来成为现代计算的基础。

    这篇文章的完整翻译和解释可以在美国普及者 Charles Petzold 的著作《阅读图灵:图灵关于可计算性和图灵机的历史文章的旅程》(ISBN 978-5-97060-231-7, 978-0-470-22905-7)中阅读。

    原文:
    https://www.astro.puc.cl/~rparra/tools/PAPERS/turing_1936.pdf

    论可计算数及其在解决问题中的应用

    图灵

    [1936 年 5 月 28 日收稿 – 1936 年 11 月 12 日阅读]

    “可计算”数可以简单地描述为实数,其小数形式的表达可以通过有限多种方式计算。尽管乍一看本文将数字视为可计算的,但定义和探索整数变量、实数变量、可计算变量、可计算谓词等的可计算函数几乎同样容易。然而,与这些可计算对象相关的基本问题在每种情况下都是相同的。为了详细考虑,我选择可计算数字作为可计算对象,因为考虑它们的方法是最不麻烦的。我希望尽快描述可计算数与可计算函数的关系等等。同时,将在以可计算数表示的实变量函数理论领域进行研究。根据我的定义,如果一个实数的十进制表示可以由机器编写,那么它就是可计算的。

    在第 9 段和第 10 段中,我给出了一些论据来表明可计算数包括所有自然被认为是可计算的数。特别是,我证明了一些大类数字是可计算的。例如,它们包括所有代数数的实部、贝塞尔函数零点的实部、数字 π、e 等。然而,可计算数并不包括所有可定义数,如以下不可计算的可定义数示例所示。

    尽管可计算数的类别非常大并且在许多方面与实数的类别相似,但它仍然是可枚举的。在第 8 节中,我考虑了某些看似相反的论点。当其中一个论证得到正确应用时,乍一看,得出的结论与哥德尔*的结论相似。这些结果具有极其重要的应用。特别是,如下所示(§11),解析问题无法有解。

    在最近的一篇文章中,Alonzo Church 介绍了“有效可计算性”的想法,这与我的“可计算性”的想法相当,但定义完全不同。关于解决问题,丘奇也得出了类似的结论。本文附录中给出了“可计算性”和“有效可计算”等价性的证明。

    1. 电脑

    我们已经说过,可计算数是那些小数位可以用有限方法计算的数。这里需要一个更清晰的定义。在我们到达第 9 节之前,本文不会真正尝试证明此处给出的定义的合理性。现在,我只想指出,(逻辑)基本原理是人类的记忆必然是有限的。

    让我们将计算实数的人与只能满足有限数量的条件 q1, q2, …, qR 的机器进行比较;我们将这些条件称为“m 配置”。这台(即如此定义的)机器配备有“胶带”(类似于纸)。穿过机器的皮带被分成几段。我们称它们为“正方形”。每个这样的方块都可以包含某种“符号”。在任何时刻,只有一个这样的正方形,比如第 r 个,包含“在这台机器中”的符号。我们将这样的正方形称为“扫描符号”。可以说,“扫描字符”是机器“直接感知”的唯一字符。然而,通过改变它的 m 配置,机器可以有效地记住它之前“看到”(扫描过)的一些字符。机器在任何时刻可能的行为由 m 配置 qn 和扫描的符号***决定。我们称这对符号 qn 为“配置”。这样指定的配置决定了给定机器的可能行为。在其中所扫描的方块是空白的(即,不包含字符)的一些配置中,机器在所扫描的方块上写入新字符,而在这些配置的另一些中,它擦除所扫描的字符。这台机器也能够移动来扫描另一个方格,但这样它只能移动到右侧或左侧的相邻方格。除了这些操作之外,还可以更改机器的 m 配置。在这种情况下,一些写入的字符将形成一个数字序列,这是正在计算的实数的小数部分。其余的无非是为了“帮助记忆”而做的不准确的标记。在这种情况下,只能擦除上述不准确的标记。

    我声称这里考虑的操作包括计算中使用的所有操作。对于了解机器理论的读者来说,这种说法的基本原理更容易理解。因此,在下一节中,我将在理解“机器”、“磁带”、“扫描”等术语的基础上继续发展相关理论。

    *哥德尔“论数学原理中形式上不可判定的句子(由怀特海和罗素于 1910 年、1912 年和 1913 年出版)和相关系统,第一部分”,《数学杂志》。物理学,德国月刊第 38 期(1931 年,第 173-198 页。
    ** Alonzo Church,“初等数论中的不可判定问题”,American J. of Math.,第 58 期(1936 年),第 345-363 页。
    *** Alonzo Church,“关于解决问题的注释”,J. of Symbolic Logic,第 1 期(1936 年),第 40-41 页

DemensDeum
Privacy Overview

This website uses cookies so that we can provide you with the best user experience possible. Cookie information is stored in your browser and performs functions such as recognising you when you return to our website and helping our team to understand which sections of the website you find most interesting and useful.